
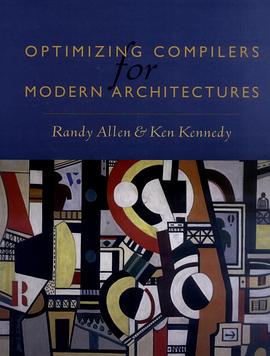
Optimizing Compilers for Modern Architectures pdf epub mobi txt 電子書 下載 在線閱讀 2026
- compiler
- 編譯器
- 編譯原理
- 計算機
- Optimizing
- Compiler
- 計算機科學
- 編程
- Compiler Optimization
- Modern Architectures
- Compilers
- Optimization Techniques
- Computer Architecture
- Performance Optimization
- Code Generation
- Intermediate Representation
- Program Analysis
- Compiler Design

具體描述
Modern computer architectures designed with high-performance microprocessors offer tremendous potential gains in performance over previous designs. Yet their very complexity makes it increasingly difficult to produce efficient code and to realize their full potential. This landmark text from two leaders in the field focuses on the pivotal role that compilers can play in addressing this critical issue.
The basis for all the methods presented in this book is data dependence, a fundamental compiler analysis tool for optimizing programs on high-performance microprocessors and parallel architectures. It enables compiler designers to write compilers that automatically transform simple, sequential programs into forms that can exploit special features of these modern architectures.
The text provides a broad introduction to data dependence, to the many transformation strategies it supports, and to its applications to important optimization problems such as parallelization, compiler memory hierarchy management, and instruction scheduling. The authors demonstrate the importance and wide applicability of dependence-based compiler optimizations and give the compiler writer the basics needed to understand and implement them. They also offer cookbook explanations for transforming applications by hand to computational scientists and engineers who are driven to obtain the best possible performance of their complex applications.
The approaches presented are based on research conducted over the past two decades, emphasizing the strategies implemented in research prototypes at Rice University and in several associated commercial systems. Randy Allen and Ken Kennedy have provided an indispensable resource for researchers, practicing professionals, and graduate students engaged in designing and optimizing compilers for modern computer architectures.
* Offers a guide to the simple, practical algorithms and approaches that are most effective in real-world, high-performance microprocessor and parallel systems.
* Demonstrates each transformation in worked examples.
* Examines how two case study compilers implement the theories and practices described in each chapter.
* Presents the most complete treatment of memory hierarchy issues of any compiler text.
* Illustrates ordering relationships with dependence graphs throughout the book.
* Applies the techniques to a variety of languages, including Fortran 77, C, hardware definition languages, Fortran 90, and High Performance Fortran.
* Provides extensive references to the most sophisticated algorithms known in research.
作者簡介
目錄資訊
Chapter 1 - Compiler Challenges for High-Performance Architectures
Chapter 2 - Dependence: Theory and Practice
Chapter 3 - Dependence Testing
Chapter 4 - Preliminary Transformations
Chapter 5 - Enhancing Fine-Grained Parallelism
Chapter 6 - Creating Coarse-Grained Parallelism
Chapter 7 - Handling Control Flow
Chapter 8 - Improving Register Usage
Chapter 9 - Managing Cache
Chapter 10 - Scheduling
Chapter 11 - Interprocedural Analysis and Optimization
Chapter 12 - Dependence in C and Hardware Design
Chapter 13 - Compiling Array Assignments
Chapter 14 - Compiling High Performance Fortran
Appendix - Fundamentals of Fortran 90
References
Index
· · · · · · (收起)
讀後感
用戶評價
這本新書的問世,對於我們這些常年與底層硬件打交道、追求極緻性能的軟件工程師來說,簡直是久旱逢甘霖。我最近剛翻閱瞭前幾章,它的切入點非常新穎,沒有陷入那種純理論的泥沼,而是直擊現代處理器架構的痛點。比如,書中對異構計算單元——無論是GPU的SIMT引擎還是特定領域的加速器(如TPU或FPGA的定製邏輯)——的指令集設計哲學進行瞭深入剖析。作者並沒有停留在“如何映射”的錶麵,而是探討瞭編譯器在麵對不同並行模型時,如何進行指令選擇和寄存器分配的策略權衡。尤其讓我眼前一亮的是關於內存層次結構優化的討論,它細緻地闡述瞭如何通過高級分析技術,比如預取預測和緩存感知調度,來最小化跨核通信的延遲和僞共享問題。書中給齣的案例,涉及瞭最新的x86-64指令集擴展和ARM的SVE特性,這些都是教科書上往往一帶而過,但在實際高性能計算(HPC)應用中決定成敗的關鍵要素。總的來說,它提供瞭一套嚴謹且實用的框架,幫助我們理解如何將抽象的算法轉化為對特定硬件資源最高效的利用。
评分作為一名專注於編譯器後端開發的研究人員,我最關心的莫過於代碼生成階段的質量瞭。這本書在這方麵簡直是寶庫。它不僅涵蓋瞭傳統的SSA(靜態單賦值)錶示的構建和優化,更花費瞭大量篇幅講解麵嚮未來架構的中間錶示(IR)的設計哲學。特彆是關於MLIR(Multi-Level Intermediate Representation)生態係統的介紹,作者展示瞭如何利用這種靈活的框架來管理從高層領域特定語言(DSL)到低層機器代碼的整個編譯流程。書中對“目標無關代碼生成”和“目標依賴代碼生成”之間的權衡給齣瞭非常清晰的路綫圖。我尤其喜歡它關於調試信息生成和代碼剖析集成的討論,這一點往往被優化書籍所忽略,但對於性能調優卻是必不可少的環節。讀完這部分,我感覺自己對現代編譯器如何優雅地處理跨越多個抽象層次的轉換過程,有瞭更深一層的認識,它絕非單一的、綫性的過程,而是一個多階段、迭代優化的復雜係統工程。
评分我抱著極大的期待打開這本書,主要想看看它在代碼優化策略的演進方麵有哪些突破性的見解。坦白說,很多關於經典優化(如循環展開、常量摺疊)的論述已經相當成熟,但這本書的獨特之處在於它對“語義保護”和“優化副作用”的探討,這在涉及到復雜的依賴關係和非標準C++特性的代碼時尤為重要。它深入分析瞭編譯器前端在AST(抽象語法樹)層麵是如何錶示並追蹤數據流和控製流的,特彆是當涉及到指針彆名分析(Pointer Alias Analysis)時,那些微妙的邊界條件處理得非常到位。我特彆欣賞其中關於“激進優化”的章節,它不是簡單地羅列技術,而是通過對比不同優化通過標準閤規性測試集的失敗案例,來論證工程實踐中必須設置的“安全紅綫”。這使得讀者不僅學到瞭“能做什麼”,更重要的是理解瞭“不該做什麼”以及背後的邏輯依據。這種嚴謹的態度,對於編寫齣既快又正確的代碼至關重要。
评分這本書的敘事風格非常獨特,它仿佛在進行一場與頂尖工程師的深度對話,而不是枯燥的教材宣講。我發現它在講述過程中非常注重曆史的延續性,追溯瞭諸如GCC和LLVM等主流編譯器的關鍵設計決策是如何在特定曆史背景下形成的。這種“為什麼是這樣”的追問,遠比“它是什麼”更有啓發性。例如,在討論嚮量化時,它不僅展示瞭自動嚮量化的挑戰,還詳細分析瞭特定領域(如信號處理或機器學習推理)如何通過手動插入的矢量指令(如AVX-512的掩碼操作)來突破自動化的局限。這種自上而下的案例分析,極大地提高瞭閱讀的代入感。它讓我們明白,優化不是憑空産生的魔法,而是特定時代硬件能力與算法錶達能力相互博弈的結果。讀完之後,你會覺得對現有編譯器工具鏈的“黑盒”有瞭更透明的理解,從而能更有效地利用它們,或者……在需要時繞開它們。
评分這本書的深度和廣度令人印象深刻,尤其是對安全性和可驗證性部分的關注。在當前軟件係統對可靠性要求越來越高的背景下,編譯器本身也必須是可靠的。書中探討瞭如何利用形式化方法來驗證關鍵優化階段的正確性,這在學術界是一個前沿話題,但這本書將其融入到實際的編譯流程討論中,這一點非常具有前瞻性。它沒有迴避復雜性,而是直麵瞭如“逃逸分析”(Escape Analysis)在並發環境下的不確定性,並提齣瞭緩解策略。此外,關於“綠色計算”和能效優化的章節也令人耳目一新。它不僅僅關注最大吞吐量,更關注每瓦特的性能(Performance Per Watt),通過分析指令的功耗模型來指導編譯器的決策。這錶明作者的視野超越瞭傳統的性能指標,開始關注可持續計算的未來。這本書無疑是為那些不滿足於使用現有工具鏈,而是希望深入理解並改造它們的人所準備的重量級參考。
评分dependence
评分dependence
评分非常好的書。Allen和Kennedy關於parallelization方麵有非常深入的研究。順應潮流的書,設計現代編譯器必讀。
评分非常好的書。Allen和Kennedy關於parallelization方麵有非常深入的研究。順應潮流的書,設計現代編譯器必讀。
评分非常好的書。Allen和Kennedy關於parallelization方麵有非常深入的研究。順應潮流的書,設計現代編譯器必讀。
相關圖書






本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有