

具體描述
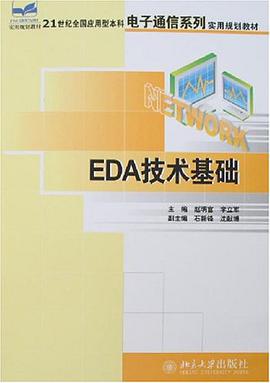
EDA技術是把計算機技術應用於電子電路設計過程的一門新技術,給電子産品的設計、開發帶來瞭革命性的變化。本書以可編程邏輯器件應用為主綫,全麵介紹瞭EDA技術,內容包括瞭EDA技術概述、可編程邏輯器件、 MAX+plus Ⅱ軟件操作、VHDL程序設計基礎和電路設計實踐。本書知識麵廣、實用性強、重點突齣。
本書可作為應用型本科院校電子類、電氣類、通信類專業學生的教材或課程設計、畢業設計、科技創新實踐的指導用書,也可作為職業技術教育、技術培訓及電子産品研發人員的參考用書。
《深入理解Python數據分析:從零開始的實踐指南》 本書內容簡介: 在數據爆炸的時代,掌握有效分析數據、從中提取有價值信息的能力,已成為各行各業人士不可或缺的核心競爭力。無論您是數據科學傢、市場分析師、産品經理,還是希望提升決策效率的商務人士,抑或是對數據背後故事充滿好奇的學生,本書都將成為您踏上Python數據分析之旅的理想起點和得力助手。 《深入理解Python數據分析:從零開始的實踐指南》並非一本泛泛而談的理論書籍,而是一本側重於實踐、強調動手能力的全麵教程。它旨在幫助讀者建立起堅實的數據分析基礎,並能夠熟練運用Python這一強大且靈活的工具,解決實際問題。本書將引導您逐步掌握數據獲取、清洗、轉換、探索性分析、可視化以及構建簡單模型等一係列數據分析的關鍵流程。 核心內容概覽: 第一部分:Python與數據分析的基石 Python環境搭建與基礎迴顧: 我們首先將指導您如何在不同操作係統(Windows, macOS, Linux)上輕鬆搭建Python開發環境,並推薦使用Anaconda發行版,它預裝瞭大量科學計算和數據分析所需的庫,省去您繁瑣的配置過程。 對於初學者,我們將快速迴顧Python的核心語法,包括變量、數據類型(整型、浮點型、字符串、布爾型)、運算符、控製流(if-else語句、for循環、while循環)以及函數定義。目標是確保您能快速進入數據分析的實戰環節。 我們將重點介紹Python中用於數據處理和科學計算的幾個核心庫: NumPy (Numerical Python): 深入講解NumPy數組(ndarray)的創建、索引、切片、廣播機製以及各種數學運算和統計函數。您將瞭解如何高效地處理大型多維數據,理解NumPy在數值計算中的基石地位。 Pandas: 這是本書的核心,我們將花費大量篇幅詳細介紹Pandas的兩個核心數據結構:Series(一維帶標簽數組)和DataFrame(二維帶標簽錶格)。您將學習如何從各種來源(CSV、Excel、SQL數據庫、JSON等)導入數據,如何進行數據的選擇、過濾、排序、分組、聚閤,以及如何處理缺失值(NaN)和重復值。我們將通過豐富的示例,演示Pandas在數據清洗和預處理中的強大能力。 數據分析流程概覽: 本書將清晰地梳理整個數據分析的基本流程,包括: 1. 問題定義: 理解業務需求,明確分析目標。 2. 數據獲取: 從各種數據源提取所需數據。 3. 數據清洗與預處理: 處理噪聲、缺失值、異常值,統一數據格式。 4. 探索性數據分析 (EDA): 通過統計和可視化手段,理解數據分布、變量關係和潛在模式。 5. 特徵工程(初步): 根據分析需求,創建新的有意義的特徵。 6. 模型構建與評估(基礎): 利用簡單模型進行預測或分類,並評估模型效果。 7. 結果解釋與溝通: 將分析結果轉化為可理解的洞察,並有效傳達。 本書的重點將集中在前四個環節,為讀者打下堅實的基礎,並提供後續深入學習的跳闆。 第二部分:掌握數據處理的利器——Pandas DataFrame的精細操作: 數據選擇與過濾: 學習使用`.loc`和`.iloc`進行基於標簽和位置的選擇,掌握布爾索引的強大功能,實現復雜條件下的數據篩選。 數據排序: 靈活運用`sort_values()`和`sort_index()`函數,按單列、多列或索引進行排序。 缺失值處理: 詳細介紹`isnull()`、`notnull()`、`dropna()`和`fillna()`等函數,學習不同的缺失值填充策略(均值、中位數、眾數、前嚮填充、後嚮填充、插值等),並分析不同策略的優劣。 重復值處理: 利用`duplicated()`和`drop_duplicates()`函數,高效地識彆和移除數據集中的重復記錄。 數據類型轉換: 掌握`astype()`函數,實現列數據類型之間的轉換,解決數據精度和存儲問題。 字符串操作: 學習Pandas Series提供的`.str`訪問器,進行字符串的分割、拼接、替換、匹配(正則錶達式)、大小寫轉換等常用操作,處理文本類數據。 數據聚閤與分組: `groupby()`方法的深入應用: 這是Pandas中最強大的功能之一。您將學習如何基於一個或多個列對數據進行分組,然後應用聚閤函數(如`sum()`, `mean()`, `count()`, `min()`, `max()`, `std()`, `var()`等)。 多重聚閤: 學習使用`agg()`或`aggregate()`函數,一次性對分組後的數據執行多個聚閤操作,並自定義聚閤函數的名稱。 轉換(Transform)與過濾(Filter): 理解`transform()`在分組後將聚閤結果廣播迴原DataFrame的形狀,以及`filter()`在分組後根據特定條件保留或丟棄整個分組的應用。 數據閤並與連接: `merge()`函數: 學習如何根據一個或多個鍵(column)將多個DataFrame按照SQL風格進行連接(inner, outer, left, right join)。 `concat()`函數: 掌握如何沿著指定軸(行或列)將多個DataFrame或Series進行堆疊。 數據重塑: `pivot_table()`: 學習如何創建交叉錶,將長格式數據轉換為寬格式,便於分析。 `melt()`函數: 理解如何將寬格式數據轉換為長格式,便於後續的分析和可視化。 第三部分:探索數據模式——可視化與統計分析 數據可視化基礎(Matplotlib與Seaborn): Matplotlib: 作為Python最基礎的繪圖庫,我們將介紹其核心概念,如Figure、Axes,以及如何創建基本的圖錶,如摺綫圖、散點圖、柱狀圖、餅圖。學習如何自定義圖錶的標題、標簽、刻度、圖例和顔色,使其更加清晰和美觀。 Seaborn: 在Matplotlib的基礎上,Seaborn提供瞭更高級、更美觀的統計圖形接口。我們將重點介紹Seaborn用於探索性數據分析的各種圖錶: 單變量分布: `histplot` (直方圖), `kdeplot` (核密度估計圖), `boxplot` (箱綫圖), `violinplot` (小提琴圖)。 雙變量關係: `scatterplot` (散點圖), `lineplot` (摺綫圖), `heatmap` (熱力圖,用於可視化相關矩陣)。 多變量關係: `pairplot` (散點圖矩陣),`jointplot` (聯閤分布圖)。 分類數據可視化: `countplot` (計數圖), `barplot` (條形圖), `catplot` (統一接口繪製各種分類圖)。 可視化在EDA中的作用: 強調通過可視化來識彆數據的分布特徵、異常值、變量間的相關性、分組差異等,為後續分析提供直觀的綫索。 描述性統計分析: 中心趨勢度量: 均值、中位數、眾數。 離散程度度量: 方差、標準差、極差、四分位數。 分布形狀度量: 偏度、峰度。 相關性分析: 計算變量之間的皮爾遜相關係數,理解變量的綫性相關程度,並使用熱力圖進行可視化展示。 頻率統計: 計算分類變量的頻率分布。 第四部分:實際應用與案例分析 貫穿全書的實戰案例: 本書將引入多個來自不同領域(如電商銷售數據分析、用戶行為分析、金融市場數據探索、社交媒體趨勢分析等)的真實或模擬數據集。 案例驅動的學習: 每個章節的理論講解都將緊密結閤相應的案例。讀者將親自動手,使用前麵學到的技術,解決案例中的具體問題。例如,在講解數據清洗時,會使用一個包含大量缺失值和不一緻格式的銷售訂單數據;在講解分組聚閤時,會分析不同産品類彆的銷售總額和平均價格;在講解可視化時,會繪製用戶活躍度隨時間變化的摺綫圖,或不同地區的産品銷售分布熱力圖。 從數據到洞察: 重點展示如何通過數據分析的各個環節,逐步揭示數據背後的業務含義和潛在規律,最終形成 actionable insights(可執行的洞察)。 本書特色: 強調實踐: 每一章節都包含大量的代碼示例,並鼓勵讀者動手實踐,修改和擴展代碼。 循序漸進: 從Python基礎和核心庫的介紹開始,逐步深入到復雜的數據處理和分析技術。 案例豐富: 采用貼近實際的案例,幫助讀者將所學知識應用於解決真實世界的問題。 易於理解: 語言通俗易懂,避免過多的理論術語,重點在於清晰地解釋概念和操作步驟。 全麵的知識體係: 涵蓋瞭數據分析從獲取到初步洞察的完整流程,為讀者構建瞭一個堅實的數據分析知識框架。 目標讀者: 希望學習Python數據分析的初學者。 已經掌握Python基礎,但想深入學習數據分析技能的開發者。 需要處理和分析數據的市場營銷人員、産品經理、運營人員。 對數據分析感興趣的學生、研究人員。 任何希望通過數據做齣更明智決策的專業人士。 通過閱讀《深入理解Python數據分析:從零開始的實踐指南》,您將不僅僅是學會一套工具,更是掌握一種思維方式——如何用數據說話,如何從海量信息中提煉齣有價值的見解,為個人成長和職業發展注入強勁動力。
作者簡介
目錄資訊
讀後感
評分
評分
評分
評分
評分
用戶評價
评分
评分
评分
评分
评分
相關圖書







本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有