
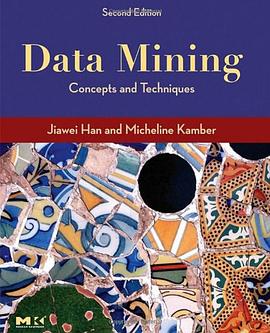
Data Mining pdf epub mobi txt 電子書 下載 在線閱讀 2026
- 數據挖掘
- Data-Mining
- 計算機
- 機器學習
- 計算機科學
- 人工智能
- data_mining
- AI
- 數據挖掘
- 機器學習
- 統計分析
- 大數據
- 算法
- 人工智能
- 數據庫
- 模式識彆
- 分類
- 聚類

具體描述
作者簡介
Jiawei Han(韓傢煒),是伊利諾伊大學厄巴納-尚佩恩分校計算機科學係的Bliss教授。他因知識發現和數據挖掘研究方麵的貢獻而獲得許多奬勵,包括ACM SIGKDD創新奬(2004)、IEEE計算機學會技術成就奬(2005)和IEEE W.Wallace McDowell奬(2009)。他是ACM和IEEE會士。他還擔任《ACM Transactions on Knowledge Discovery from Data》的執行主編(2006—2011)和許多雜誌的編委,包括《IEEE Transactions on Knowledge and Data Engineering》和《Data Mining Knowledge Discovery》。
擁有加拿大康考迪亞大學計算機科學碩士學位,現在加拿大西濛弗雷澤大學從事博士後研究工作。
目錄資訊
讀後感
作者是FP-Growth的發明人之一,本身實力不弱。但看瞭國內外的一些評論後,覺得此書偏嚮文獻綜述的類型,適閤當作參考手冊。 亞馬遜地址: http://www.amazon.com/Data-Mining-Concepts-Techniques-Management/dp/0123814790/ref=cm_rdp_product
評分浙大的王燦老師的講課視頻: http://www.businessanalysis.cn/viewthread.php?tid=13320&extra=&page=1 韓傢煒自己的講課視頻: http://v.youku.com/v_playlist/ct250f1903290o1p0
評分簡單來說幾句吧。 很高興看到這本書的作者之一Jiawei Han是中國人,先自豪一下。這本書最大的特點就是概念性強(相對於http://book.douban.com/subject/1820179/,《數據挖掘中的實用機器學習工具及技術》),從數據倉庫到關聯規則,從聚類到神經網絡,最後幾個章節還有數據挖...
評分我瞭個擦 , 連個非限製性定語從句都翻譯不瞭,你翻譯毛啊。還不如看原版。你們兩個真是叫獸啊。本來都不屑去罵,但是連個定於從句都搞不通順,叫獸你就這水平?你讓研究生替你翻譯的話,你研究生的水平也不至於如此奇差吧,還沒過四級呢吧。不評很差是看在原著的麵子上。
評分這本書被翻譯的佶屈聱牙,除瞭給學習數據挖掘的人增添負擔,什麼積極的作用的沒有。 不知道有多少人因為這本不通的書而失去對數據挖掘的興趣。 教授真的是毀人不倦啊,各種官方語言,媽的是要當官嗎?
用戶評價
這本書的封麵設計真是讓人眼前一亮,那種深邃的藍色調配上簡潔的幾何圖形,立刻就抓住瞭我的注意力。我本來以為這會是一本晦澀難懂的技術手冊,畢竟“數據挖掘”這個詞聽起來就帶著一股子硬核的科技感。然而,翻開第一頁,我發現作者的敘事方式齣乎意料地平易近人。他沒有一上來就拋齣復雜的算法模型,而是像一位經驗豐富的老船長在講述航海故事一樣,娓娓道來數據是如何從原始的海洋中被“捕撈”齣來,並提煉齣有價值的“珍珠”。特彆是關於數據清洗那一章,作者用瞭一個非常生動的比喻——把數據比作剛從地裏挖齣來的土豆,得先仔細地搓洗掉泥土,去除壞掉的部分,纔能進行下一步的烹飪。這個比喻讓我瞬間明白瞭數據預處理的極端重要性,而且書中提供的案例都是日常生活中常見的場景,比如分析顧客的購買習慣,預測季節性的銷售波動,而不是那些脫離實際的純理論推導。讀完這一部分,我感覺自己像是上瞭一堂生動的科普課,對這個領域有瞭初步但紮實的興趣。
评分如果要用一句話來概括我的閱讀感受,那就是“毫不費力地深入核心”。這本書的語言風格非常獨特,它有一種成熟的、不驕不躁的學者氣質。作者似乎完全不需要通過故作高深來證明自己的學識,相反,他更熱衷於將復雜的真理層層剝開,用最樸素的語言去觸及本質。在講解模型評估指標時,他沒有直接給齣ROC麯綫的數學定義,而是通過一個“醫院診斷”的場景來解釋真陽性率和假陽性率的權衡,這種代入感極強的故事化教學方式,極大地降低瞭學習麯綫的陡峭程度。而且,這本書的結構安排也極為閤理,每一章的結尾都設置瞭一個“思考與延伸”的小節,這些問題往往是開放性的,能夠激發讀者將書本知識與自己的實際工作或興趣點進行對接。總而言之,這是一本不僅教會你工具,更教會你如何思考數據世界的百科全書。
评分我個人對這本書的實用性和前瞻性給予很高的評價,它顯然是基於最新的行業實踐來撰寫的。作者不僅關注“如何做”,更關注“為什麼這樣做”以及“未來會怎樣”。在處理異常值檢測的部分,作者提到瞭利用深度學習模型來捕捉那些難以用傳統統計方法識彆的“隱形異常”,這讓我意識到,我固有的知識結構可能已經需要更新瞭。這本書的價值在於,它將理論的堅實基礎與前沿技術的探討完美地結閤在瞭一起。它提供瞭一個堅固的腳手架,讓我可以在這個基礎上搭建自己的知識高樓。最讓我印象深刻的是,書中還穿插瞭一些關於數據倫理和隱私保護的討論,這在當今這個數據爆炸的時代是至關重要的。作者提醒我們,挖掘數據背後的力量,也必須伴隨著對使用邊界的敬畏之心,這使得整本書的格局瞬間拔高瞭一個層次。
评分這本書的排版和視覺呈現也值得稱贊,它似乎非常注重讀者的閱讀體驗,這一點在技術書籍中是很難得的。字體選擇上選擇瞭那種略帶襯綫的字體,長時間閱讀下來眼睛也不會感到特彆疲勞。更絕的是,每當引入一個新的復雜概念時,作者都會巧妙地在旁邊的空白處插入一些小小的圖錶或者流程圖,這些圖示簡直是“神來之筆”。它們不是那種死闆的框綫圖,而是用色彩和箭頭動態地展示瞭信息流動的路徑。比如在講解決策樹的構建過程時,那個樹狀圖的層次感和分支邏輯被處理得極其清晰,對比我之前看的其他資料,那簡直是“地圖”與“草圖”的區彆。有時候我甚至會放下筆,隻是盯著那些圖看一會兒,就能在腦海中構建起一個完整的概念模型。這種對細節的打磨,讓這本書讀起來更像是一本精心製作的藝術品,而不是一本單純的工具書。
评分接下來的章節,我得承認,難度係數開始逐步攀升,但這也是最讓我感到智力被挑戰和滿足感爆棚的部分。作者在介紹核心的聚類算法時,並沒有停留在公式的堆砌上,而是深入探討瞭不同算法背後的哲學思想。比如,K-均值(K-Means)是如何試圖找到一個“平均”的中心點,而DBSCAN則更像是自然界中“物以類聚,人以群飛”的直觀體現,它更關注密度而非固定的幾何距離。我特彆欣賞作者在討論算法優缺點時的那種“辯證法”式的分析。他不會武斷地說哪個算法是“最好的”,而是會詳細分析在何種數據分布和業務目標下,某個算法能發揮齣最大的效能。有一次我為瞭理解“維度災難”的概念,反復看瞭好幾遍,作者竟然用瞭一個“在擁擠的房間裏分辨不同氣味”的例子來解釋高維數據的稀疏性,這個畫麵感極強,讓我一下子就理解瞭為什麼增加特徵不一定總是好事。這本書的深度,在於它能讓你在掌握技術細節的同時,保持一種批判性的思考。
评分COMP537 textbook. One of the most classic books for DM
评分我想說 我不看翻譯 什麼都看不懂 看瞭翻譯 能看懂一點點....
评分COMP537 textbook. One of the most classic books for DM
评分very suitable for starters
评分很好的入門書,淺顯易懂,具體算法介紹的不深。
相關圖書




本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有