
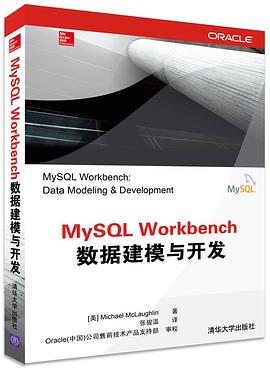
MySQL Workbench数据建模与开发 pdf epub mobi txt 电子书 下载 在线阅读 2026
- 计算机
- 数据建模
- 数据库
- 建模
- MySQL
- MySQL
- Workbench
- 数据建模
- 数据库设计
- MySQL
- 开发
- 数据库
- 工具
- 可视化
- ER图
- SQL

具体描述
建立和维护世界级的MySQL数据库,执行有效查询并深入洞察企业数据
《MySQL Workbench数据建模与开发》提供了一些已经过验正的策略、最佳实践和详细的实例。其中包括了安装MySQL Workbench、创建数据库模型、配置和部署数据库、认证用户、可视化地设计脚本和系统性能最优化。在这本书中,还全面涉及了逆向工程、数据库迁移和安全性等。
主要内容
● 安装MySQL Workbench
● 建立和配置MySQL数据库
● 建立、测试和管理连接
● 涉及精确的关系数据模型
● 创建函数、过程和触发器
● 对数据库进行逆向工程并捕获定义
● 编写、调试并部署用户脚本
● 维护本地和远端实例管理器
● 授予系统或模式级的用户权限
● 老版本数据库的迁移和融合
作者简介
Michael McLaughlin拥有Oracle ACE身份,是BYU的Idaho商务与通信学院的计算机信息技术系的教授。他教授有关IT管理、数据库和系统分析与设计方面的课程。他是Oracle Database 11g PL/SQL Programming 、Oracle Database 10gExpress Edition PHP Web Programming和Oracle Database 11g & MySQL 5.6 Developer Handbook 等书的作者,也是Oracle Database 11g PL/SQL Programming Workbook 、Oracle Database 10g PL/SQL Programming 、Expert Oracle PL/SQL 和Oracle Database AJAX & PHP Web Application Development 等书的合著者。
Michael在Oracle Corporation工作了8年以上,最近成为 E-business Suite Release Engineering的应用程序高级升级经理。
目录信息
第1章 安装和配置 3
1.1 Fedora Linux 4
1.2 Mac OS X 13
1.3 Microsoft Windows 25
1.3.1 预安装Microsoft可再发行库 28
1.3.2 安装MySQL产品 32
1.4 本章小结 53
1.5 本章内容考查 53
第2章 创建和管理连接 55
2.1 Fedora 56
2.2 Mac OS X 63
2.3 Windows 7 68
2.3.1 配置MySQL Workbench连接 68
2.3.2 配置Server Administration 75
2.4 本章小结 80
2.5 本章内容考查 80
第Ⅱ部分 数 据 建 模
第3章 数据建模的概念 85
3.1 数据建模理论 86
3.1.1 什么是数据建模 86
3.1.2 数据建模为什么重要 88
3.1.3 如何实现它 93
3.2 数据建模系统 95
3.2.1 二元关系 97
3.2.2 n元关系 100
3.2.3 符号集 100
3.3 经典的规范化 103
3.3.1 第一范式 104
3.3.2 第二范式 107
3.3.3 第三范式 108
3.4 本章小结 110
3.5 本章内容考查 110
第4章 创建和管理表与关系 113
4.1 打开和保存文件 114
4.2 创建表和视图 116
4.2.1 添加表 117
4.2.2 添加列 118
4.2.3 添加索引 121
4.2.4 添加外键 123
4.2.5 创建视图 126
4.2.6 创建例程 127
4.3 创建关系 128
4.4 本章小结 132
4.5 本章内容考查 132
第5章 创建和管理例程 135
5.1 添加例程 136
5.2 编辑例程 144
5.3 删除例程 145
5.4 本章小结 145
5.5 本章内容考查 145
第6章 逆向工程 147
6.1 对数据库进行逆向工程 148
6.2 前向工程一个数据库 157
6.2.1 从EER Model开始进行前向工程 158
6.2.2 通过脚本进行前向工程 165
6.3 本章小结 171
6.4 本章内容考查 171
第Ⅲ部分 SQL 开 发
第7章 编辑数据 175
7.1 连接到Edit Data 176
7.2 插入数据 180
7.3 更新数据 185
7.4 删除数据 187
7.5 多数据编辑 190
7.6 本章小结 192
7.7 本章内容考查 192
第8章 管理SQL脚本 195
8.1 打开SQL文件 196
8.2 运行SQL文件 200
8.3 本章小结 203
8.4 本章内容考查 203
第Ⅳ部分 服务器管理
第9章 实例 207
9.1 创建本地实例管理器 208
9.2 创建远程实例管理器 214
9.3 管理现有的实例 220
9.4 维护现有的实例管理器 224
9.5 本章小结 225
9.6 本章内容考查 225
第10章 创建和管理用户和角色 229
10.1 添加用户 230
10.2 添加模式特权 238
10.3 本章小结 243
10.4 本章内容考查 243
第11章 导入和导出 247
11.1 导出一个数据库 248
11.2 导入一个数据库 254
11.3 本章小结 259
11.4 本章内容考查 259
第12章 数据库迁移 261
12.1 迁移一个数据库 262
12.2 本章小结 277
12.3 本章内容考查 277
第Ⅴ部分 附录和术语表
附录A 内容考查的答案 281
附录B MySQL Workbench扩展 305
附录C 安装SQL Server 319
词汇表 数据库建模术语 343
· · · · · · (收起)
读后感
用户评价
拿到《MySQL Workbench数据建模与开发》这本书,我首先被它扎实的理论基础和丰富的实践案例所吸引。在阅读过程中,我逐渐意识到,数据建模并非是单纯的技术操作,而是一门需要结合业务理解、逻辑思维和工程实践的艺术。这本书在讲解Workbench各项功能的同时,始终将重点放在“为什么”和“怎么做”上,而不是简单地介绍“是什么”。比如,在介绍索引设计时,作者并没有仅仅列举几种索引类型,而是详细分析了不同场景下哪种索引更优,以及如何通过Workbench的可视化工具来分析查询性能,从而做出更合理的索引决策。我之前在优化查询时,往往只能依靠经验和猜测,而这本书给了我一套系统性的方法论,让我能够有理有据地进行优化。此外,书中关于数据库正向工程和逆向工程的讲解,也让我看到了Workbench在提升开发效率方面的巨大潜力。通过这本书,我不仅学会了如何使用Workbench来绘制漂亮的ER图,更重要的是,我理解了如何通过科学的数据建模来为后续的开发打下坚实的基础,避免了许多潜在的性能问题和维护难题。
评分刚拿到这本《MySQL Workbench数据建模与开发》,我怀着满腔的热情开始阅读。说实话,我之前一直是用一些零散的资料或者在线教程来学习MySQL Workbench,总感觉不够系统,也缺乏一些深度的实践指导。这本书的出现,就像是给我指明了方向,让我对数据建模和开发这一块有了更清晰的认知。它不仅仅是简单地介绍工具的使用,而是从更宏观的视角,比如如何将业务需求转化为实际的数据模型,如何优化模型以提高性能,以及如何利用Workbench来辅助整个开发流程。书中对ER图的绘制、数据类型的选择、约束的设置等方面都进行了非常细致的讲解,让我明白了一个优秀的数据模型是如何诞生的,以及它对后续开发的重要性。我尤其欣赏作者在讲解过程中穿插的案例分析,这些案例贴近实际开发场景,让我能够理解理论知识是如何在实际应用中发挥作用的。比如,书中关于如何处理复杂关系、如何设计高效索引的章节,就给了我很多启发。我之前在项目中遇到的一些性能瓶颈,现在看来,很大程度上是因为数据模型设计得不够合理。这本书不仅教会了我工具的使用,更重要的是,它提升了我对数据建模的整体理解和技术能力,这对我未来的项目开发来说,是无价的。我感觉这本书就像是一位经验丰富的导师,耐心细致地引导我一步步深入MySQL Workbench的世界。
评分《MySQL Workbench数据建模与开发》这本书,我得说它真的触及到了数据开发的核心痛点。作为一名常年和数据库打交道的开发者,我深知一个健壮、高效的数据模型是整个应用稳定运行的基石。然而,过去我更多地关注的是代码逻辑和业务实现,对于数据模型的精雕细琢往往是“想到哪儿做到哪儿”,缺乏系统性的指导。这本书就像是一剂良药,它系统地梳理了从需求分析到模型设计的全过程,特别是对于如何将抽象的业务需求转化为具体的数据库表结构、字段属性、索引设置以及表之间的关系,都有非常清晰的指引。书中对各种关系(一对一、一对多、多对多)的建模方式,以及如何选择合适的数据类型、如何设置主键外键约束、如何考虑数据冗余和一致性等问题,都进行了深入浅出的讲解。我印象特别深刻的是关于“前向工程”和“反向工程”的章节,这让我明白了如何利用Workbench来自动化地生成SQL脚本,以及如何根据已有的数据库结构来生成模型,这极大地提高了我的工作效率。这本书不仅仅是关于工具的教程,更是关于一种严谨的数据设计思想的传承。
评分《MySQL Workbench数据建模与开发》这本书,给我带来的最大感受是,它让我对数据建模有了全新的认识。我之前以为,只要数据库建好了,表结构合理,就可以万事大吉了。但这本书让我明白,数据建模是一个持续优化的过程,它需要我们深入理解业务需求,并将其转化为高效、可维护的数据库结构。书中对ER图的设计、数据类型的选择、索引的优化等方面都进行了非常细致的讲解,让我学到了很多实用的技巧和方法。我尤其喜欢书中关于“性能调优”的章节,作者通过案例分析,展示了如何利用Workbench来找出性能瓶颈,并提出相应的优化方案。这对于我来说是极其宝贵的经验,让我能够更自信地应对数据库性能方面的挑战。这本书不仅教会了我如何使用Workbench,更重要的是,它提升了我作为一名开发者在数据设计和优化方面的专业能力。
评分自从我开始阅读《MySQL Workbench数据建模与开发》这本书,我的工作效率和对数据库的理解都有了质的飞跃。在此之前,我对于数据建模的概念非常模糊,常常是在开发过程中遇到问题时才被动地去修改数据库结构。这本书就像一位经验丰富的老师,从最基础的ER图绘制讲起,逐步深入到数据库的各种细节。我尤其喜欢书中关于“数据库正向工程”和“逆向工程”的讲解,这让我看到了Workbench在自动化生成SQL脚本和从现有数据库生成模型方面的强大能力,极大地节省了我的开发时间。此外,书中对数据类型选择、索引设计以及关系约束的深入分析,也让我明白了为什么在数据建模阶段就应该考虑这些细节,以及它们对整个系统的性能和可维护性有多么大的影响。这本书的价值,不仅仅在于它提供了工具的使用方法,更在于它传授了一种严谨、科学的数据设计思想。
评分《MySQL Workbench数据建模与开发》这本书,就像是一位经验丰富的向导,带领我深入探索MySQL Workbench的奥秘。我一直觉得,掌握一个工具的皮毛很容易,但要真正理解其精髓,并将其运用到极致,却需要系统性的学习和深入的实践。这本书正是提供了这样的学习路径。它不仅仅是简单地介绍Workbench的界面和功能,而是从数据建模的核心理念出发,循序渐进地讲解如何将业务需求转化为结构化的数据模型。我特别喜欢书中关于“实体-关系模型”(ERM)的讲解,作者通过大量的图示和案例,清晰地展示了如何识别实体、属性和关系,以及如何将这些概念转化为数据库的表和字段。此外,书中关于“数据库正向工程”和“反向工程”的章节,也让我看到了Workbench在提升开发效率方面的巨大潜力,能够自动生成SQL脚本,并从现有数据库生成模型,这极大地简化了我的工作流程。
评分《MySQL Workbench数据建模与开发》这本书,对于我这样希望在数据层面更进一步的开发者来说,简直是一场及时雨。我一直觉得,虽然我能够熟练编写SQL语句,也理解一些基本的数据库概念,但在面对复杂的数据结构和性能优化挑战时,总是感到力不从心。这本书的出现,恰好弥补了我在数据建模和深度开发方面的知识空白。它从最基础的ER图绘制开始,一步步引导我理解如何将现实世界的业务逻辑映射到数据库表中,如何定义字段的类型、约束和关系,以及如何通过Workbench的强大功能来可视化地管理和修改这些模型。我特别欣赏书中关于“数据标准化”和“反标准化”的讨论,这让我明白了在不同的业务场景下,如何做出取舍,以达到性能和数据一致性之间的最佳平衡。同时,书中对SQL生成和优化的讲解,也让我对如何利用Workbench来辅助数据库开发有了更深的认识。我感觉这本书不仅仅是在教我如何使用一个工具,更是在传授一种严谨、科学的数据设计理念。
评分翻开《MySQL Workbench数据建模与开发》,我立刻被书中严谨的逻辑和深入的分析所吸引。这本书的讲解方式与我之前接触过的很多技术书籍都不太一样,它不是简单地罗列功能,而是深入挖掘了功能背后的原理和最佳实践。例如,在讲解数据库设计范式时,作者并没有仅仅停留在理论层面,而是结合Workbench的实际操作,演示了如何通过创建表、定义字段、设置关系等步骤,逐步将一个概念化的模型转化为结构清晰、符合范式的数据库设计。我尤其喜欢书中关于“反范式化”的讨论,这是一个在实际开发中经常会遇到的权衡问题,书中对反范式化的好处、坏处以及适用的场景进行了深入的分析,并提供了如何利用Workbench来评估和实现反范式化的具体指导,这对于我来说非常有价值。此外,书中对SQL语句的生成和优化也进行了详细的阐述,让我明白如何通过Workbench来生成高效的SQL,以及如何使用分析工具来找出SQL的性能瓶颈。我之前对SQL优化的理解比较片面,总是在遇到问题后再去优化,而这本书让我认识到,在数据建模阶段就考虑性能,是解决问题的根本之道。这本书的专业性和深度,让我觉得我投入的时间和精力都得到了应有的回报。
评分在我拿到《MySQL Workbench数据建模与开发》这本书的时候,我正面临着一个棘手的数据结构设计问题。我之前尝试过各种方法,但总觉得不够系统,模型设计出来后总是有这样那样的问题。这本书就像是为我量身定做的一样。它从最基础的概念入手,讲解了数据建模的基本原则和流程,然后深入到MySQL Workbench的具体操作。我非常欣赏作者在讲解过程中所展现出的严谨性和专业性。例如,在讲解如何设计主键和外键时,作者不仅仅给出了操作步骤,更重要的是解释了这样做的原理和意义,让我明白了为什么要这样做,以及这样做会带来什么样的好处。我尤其喜欢书中关于“范式化”和“反范式化”的讨论,这让我对如何在性能和数据一致性之间找到平衡点有了更深刻的理解。这本书的讲解方式非常清晰,易于理解,即使是对数据库建模不太熟悉的读者,也能很快上手。
评分在我开始深入阅读《MySQL Workbench数据建模与开发》之前,我对MySQL Workbench的理解仅停留在它是用来连接数据库、执行SQL命令的工具。这本书彻底颠覆了我原有的认知,让我看到了它在数据建模和整个开发流程中不可或缺的价值。书中详尽地阐述了如何从零开始构建一个数据模型,如何进行ER图的设计,如何定义表、字段、主键、外键以及各种约束。这些内容对我来说是全新的,但也正是因为它的系统性讲解,我才得以逐步理解数据模型的设计原则和最佳实践。我尤其被书中关于“数据类型选择”和“索引设计”的章节所吸引,作者深入剖析了不同数据类型对存储空间和查询性能的影响,以及如何根据业务需求设计高效的索引,这对于我来说是极其宝贵的经验。我之前在项目中常常因为对这些细节考虑不足而导致性能问题,这本书让我意识到,在数据建模阶段就做好这些功课,能够事半功倍。
评分 评分 评分 评分 评分相关图书



本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有