
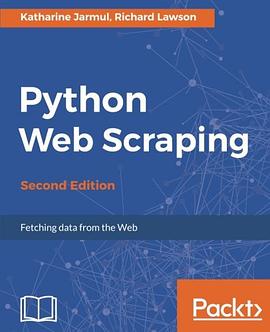
Python Web Scraping - Second Edition pdf epub mobi txt 电子书 下载 在线阅读 2026
- 爬虫
- Python
- 编程
- Python
- Web Scraping
- Data Extraction
- Beautiful Soup
- Scrapy
- Requests
- HTTP
- Data Analysis
- Automation
- Programming

具体描述
作者简介
目录信息
读后感
用户评价
这本书的设计风格让我眼前一亮,那是一种简洁而富有力量的设计感,让我觉得它蕴含着扎实的知识和精炼的技巧。我一直对Python的网络爬虫技术充满好奇,觉得它就像一条通往信息海洋的潜水艇,能够带我们去探索那些肉眼不可见的深层数据。掌握这项技能,对于我来说,就像是拥有了一副能够洞察互联网运行规律的“X光眼镜”。 我之所以会选择这本“第二版”的书籍,是因为我深信“精益求精”的道理。版本更新往往代表着作者对原有内容进行了审慎的反思和优化,融入了最新的技术洞见,并且可能吸纳了广大读者的宝贵反馈。对于我这样渴望获得最新、最有效学习资料的人来说,这种迭代更新意味着我能够更快速、更准确地掌握核心技术,避免了许多不必要的摸索和试错。 我非常期待书中能够详尽地剖析那些棘手的网页抓取难题。例如,那些依赖于AJAX异步加载数据的网站,或者是那些对爬虫行为设置了重重阻碍的网站,它们往往是学习者前进道路上的“拦路虎”。我希望作者能够提供一些非常具体的、可操作的解决方案,以及相应的代码示例,让我在面对这些挑战时,能够有条不紊地一一击破。 除了技术上的深度,我也关注这本书是否会触及爬虫技术的“边界”。如何确保我们的爬取行为是合法的、道德的,并且不会对目标网站造成过度的负担,这些都是我非常重视的议题。我希望作者能够在这方面提供一些清晰的指导原则,引导我成为一名负责任的数字公民。 对于学习者来说,易于理解的语言是至关重要的。我期望这本书能够使用清晰、流畅、并且逻辑严谨的语言来阐述复杂的概念,避免使用那些让人生畏的专业术语。如果书中能配备丰富的图表、流程图以及能够实际运行的代码片段,那将极大地增强学习的效率和乐趣。 我非常看重实践性。我希望这本书能包含一系列由浅入深的实战项目,让我能够将理论知识转化为实际操作能力。从最初的简单数据提取,到处理具有一定复杂度的动态网页,再到最终能够独立构建一个完整的爬虫应用,这样的循序渐进的学习过程,能够帮助我建立起扎实的技能基础,并培养解决实际问题的能力。 在数据处理方面,我也希望能从书中获得一些启发。抓取到的原始数据往往是杂乱无章的,如何有效地进行数据清洗、整理、存储,并最终将其转化为有价值的信息,这是爬虫技术价值的最终体现。我希望书中能够提供一些关于数据预处理、数据库选择以及数据分析的实用建议。 我对书籍的整体呈现方式也有一定的要求。无论是印刷质量、纸张的触感,还是整体的排版设计,都直接影响着阅读的舒适度和学习的效率。我希望这本书能够在这方面做到尽善尽美,提供一个令人愉悦的阅读体验。 总而言之,我对于这本书充满了高度的期待。我坚信,通过这本书的学习,我能够全面掌握Python Web Scraping的核心技术,并能够将其巧妙地应用于各种实际场景,从而在瞬息万变的互联网世界里,发掘出属于自己的那片蓝海。这本书对我来说,不只是一本技术书籍,更是一位智慧的引路人,它将带领我深入探索Python爬虫的无限可能。
评分这本书的封面设计给我一种简洁而专业的视觉冲击力,那种恰到好处的色彩搭配和字体选择,让我觉得这本书的内容一定也同样精炼且富有深度。我一直以来都对Python在网络爬虫领域的强大能力充满好奇,觉得这项技术就像一把能够解锁互联网海量信息宝库的钥匙,让我能够更主动地获取和分析数据。对我而言,学习网络爬虫不仅仅是掌握一项技能,更是获得一种全新的信息获取和分析能力。 选择这本“第二版”的书籍,是因为它代表着一种持续的改进和更新。通常,第二版会基于第一版的反馈,对内容进行优化,融入最新的技术发展,并修正可能存在的不足。这对于我这样想要学习到最前沿、最实用知识的学习者来说,无疑是一个巨大的优势,它能帮助我避免走许多不必要的弯路,直接接触到经过实践检验的、高效的方法。 我非常期待这本书能够详细讲解如何应对各种复杂的网络抓取场景。例如,那些需要通过JavaScript动态加载数据的网页,或者那些设置了精巧的反爬虫机制的网站,它们往往是学习者在实践中遇到的最大挑战。我希望书中能够提供清晰的思路、详细的步骤,以及可运行的代码示例,让我能够从容应对这些技术难题。 除了技术层面的讲解,我也非常关心书中是否会涉及爬虫技术的伦理和法律方面的问题。毕竟,作为一名负责任的开发者,了解并遵守相关的规定是至关重要的。我希望作者能够在书中提供一些关于数据使用、网站合规性等方面的指导,帮助我树立正确的技术观。 对于技术书籍而言,语言的清晰度和易懂性是至关重要的。我希望这本书能够用简洁、流畅、且富有逻辑性的语言来阐述复杂的概念,避免使用过于专业化、令人生畏的术语。如果书中能辅以丰富的图表、流程图,以及可供动手实践的代码片段,那将大大提升我的学习效率和乐趣。 我特别注重书籍的实践性。我希望这本书能够提供一系列由浅入深的项目案例,让我能够在学习理论知识的同时,通过动手实践来巩固和加深理解。从简单的静态网页抓取,到处理更为复杂的动态网页,乃至能够独立构建一个完整的爬虫应用,这样的学习过程能够帮助我建立起扎实的技能基础,并培养解决实际问题的能力。 数据处理和存储也是我非常关心的一环。网络爬虫的最终目的是获取有用的数据,而如何有效地存储、清洗和分析这些数据,是体现爬虫价值的关键。我希望书中能够提供一些关于数据库选择、数据清洗技巧以及数据可视化等方面的实用建议,从而让我的爬虫项目更具实际应用价值。 除了内容本身,书籍的整体呈现方式也直接影响着我的阅读体验。我希望这本书的印刷质量、纸张的触感,以及整体的排版设计都能达到很高的水准,提供一个舒适、愉悦的阅读环境。 总而言之,我对这本书充满了高度的期待。我相信,通过阅读这本书,我能够系统地掌握Python Web Scraping的核心技术,并能够将其熟练地应用于各种实际的项目中,从而在海量的信息时代,发掘出属于自己的那片价值蓝海。这本书对我来说,不仅仅是一本技术宝典,更是一位经验丰富的向导,它将引领我深入探索Python爬虫的广阔世界。
评分这本书的封面设计给我一种沉稳而现代的感觉,那种精心选择的色彩搭配和简洁的排版,让我觉得这本书的内容一定也同样精炼而有深度。我一直以来都对Python在网络爬虫领域的强大能力充满好奇,觉得这项技术就像一把能够解锁互联网海量信息宝库的钥匙,让我能够更主动地获取和分析数据。对我而言,学习网络爬虫不仅仅是掌握一项技能,更是获得一种全新的信息获取和分析能力。 选择这本“第二版”的书籍,是因为它代表着一种持续的改进和更新。通常,第二版会基于第一版的反馈,对内容进行优化,融入最新的技术发展,并修正可能存在的不足。这对于我这样想要学习到最前沿、最实用知识的学习者来说,无疑是一个巨大的优势,它能帮助我避免走许多不必要的弯路,直接接触到经过实践检验的、高效的方法。 我非常期待这本书能够详细讲解如何应对各种复杂的网络抓取场景。例如,那些需要通过JavaScript动态加载数据的网页,或者那些设置了精巧的反爬虫机制的网站,它们往往是学习者在实践中遇到的最大挑战。我希望书中能够提供清晰的思路、详细的步骤,以及可运行的代码示例,让我能够从容应对这些技术难题。 除了技术层面的讲解,我也非常关心书中是否会涉及爬虫技术的伦理和法律方面的问题。毕竟,作为一名负责任的开发者,了解并遵守相关的规定是至关重要的。我希望作者能够在书中提供一些关于数据使用、网站合规性等方面的指导,帮助我树立正确的技术观。 对于技术书籍而言,语言的清晰度和易懂性是至关重要的。我希望这本书能够用简洁、流畅、且富有逻辑性的语言来阐述复杂的概念,避免使用过于专业化、令人生畏的术语。如果书中能辅以丰富的图表、流程图,以及可供动手实践的代码片段,那将大大提升我的学习效率和乐趣。 我特别注重书籍的实践性。我希望这本书能够提供一系列由浅入深的项目案例,让我能够在学习理论知识的同时,通过动手实践来巩固和加深理解。从简单的静态网页抓取,到处理更为复杂的动态网页,乃至能够独立构建一个完整的爬虫应用,这样的学习过程能够帮助我建立起扎实的技能基础,并培养解决实际问题的能力。 数据处理和存储也是我非常关心的一环。网络爬虫的最终目的是获取有用的数据,而如何有效地存储、清洗和分析这些数据,是体现爬虫价值的关键。我希望书中能够提供一些关于数据库选择、数据清洗技巧以及数据可视化等方面的实用建议,从而让我的爬虫项目更具实际应用价值。 除了内容本身,书籍的整体呈现方式也直接影响着我的阅读体验。我希望这本书的印刷质量、纸张的触感,以及整体的排版设计都能达到很高的水准,提供一个舒适、愉悦的阅读环境。 总而言之,我对这本书充满了高度的期待。我相信,通过阅读这本书,我能够系统地掌握Python Web Scraping的核心技术,并能够将其熟练地应用于各种实际的项目中,从而在海量的信息时代,发掘出属于自己的那片价值蓝海。这本书对我来说,不仅仅是一本技术宝典,更是一位经验丰富的向导,它将引领我深入探索Python爬虫的广阔世界。
评分这本书的封面设计简直是太棒了!那种恰到好处的配色方案,既不会显得过于花哨,又充满了专业感,让我一眼就觉得这是一本值得信赖的技术书籍。我一直以来都对Python在网络爬虫领域的应用非常着迷,总觉得这项技术就像一把钥匙,能够打开通往海量信息世界的大门。想象一下,那些隐藏在网页深处的数据,那些等待我们去挖掘的价值,只要掌握了这项技能,一切皆有可能。 我之所以选择《Python Web Scraping - Second Edition》,最主要的原因就是它的“第二版”身份。这通常意味着作者在第一版的基础上,进行了深入的优化和更新,吸收了最新的技术发展,并且可能采纳了读者的反馈意见。对于我这样希望学习到最新、最实用的知识的学习者来说,这无疑是一个巨大的吸引力。它能够帮助我避免走很多不必要的弯路,直接接触到那些经过时间检验、已经被证明有效的方法。 我非常期待这本书能够深入讲解各种复杂的爬虫场景。比如,那些使用JavaScript动态加载内容的网页,或者那些对爬虫行为进行严格限制的网站,都是我学习过程中常常会遇到的难题。我希望这本书能够提供清晰的思路和实用的代码示例,让我能够有效地应对这些挑战,掌握应对不同类型网页的策略。 除了技术层面的讲解,我还非常关心这本书是否能包含一些关于爬虫的伦理和法律方面的讨论。毕竟,网络爬虫技术是一把双刃剑,合理使用才能发挥其最大价值,滥用则可能带来负面影响。我希望作者能够在这方面给出一些指导性的建议,帮助我成为一个负责任的技术实践者。 这本书的语言风格也是我非常看重的一点。我希望作者能够用通俗易懂的语言来解释复杂的概念,避免使用过于晦涩难懂的专业术语。清晰、简洁、逻辑性强的文字,能够让我更有效地吸收知识,并且在学习过程中保持兴趣。如果能配以丰富的图示和代码示例,那就更完美了。 我希望这本书能够提供一些实际的案例,让我能够边学边练。从简单的网页抓取,到处理一些中等复杂度的网站,再到最后能够独立完成一个小型爬虫项目,这样的实践过程能够帮助我巩固所学知识,并且在实际操作中发现问题,解决问题。 这本书在数据存储和处理方面是否能有一些深入的探讨,也是我非常关注的。抓取到数据只是第一步,如何有效地存储、清洗和分析这些数据,才是真正体现爬虫价值的关键。我希望书中能提供一些关于数据库选择、数据清洗技巧以及数据可视化的建议。 这本书的排版和印刷质量也直接影响我的阅读体验。清晰的字体、合理的行距、以及舒适的纸张,都能让我在学习过程中更加投入。我希望这本书能够在这些细节上也做到精益求精。 总而言之,我对这本书抱有极高的期望。我相信,通过阅读它,我能够系统地掌握Python Web Scraping的核心技能,并将其应用到实际的项目中,从而在互联网信息的世界里,开辟出属于自己的一片新天地。这本书对我来说,不仅是一本技术参考书,更像是一位经验丰富的导师,引领我探索Python爬虫的奥秘。
评分这本书的封面设计给我一种沉稳而现代的感觉,那种精心选择的色彩搭配和字体,都在暗示着内容的专业性和深度。我一直以来都对Python在网络爬虫领域的强大能力充满好奇,认为它就像一把能够解锁信息宝藏的钥匙,让我能够更深入地理解和利用互联网上的海量数据。对我而言,学习网络爬虫不仅仅是掌握一项技术,更是获取一种全新的信息获取和分析能力。 我选择这本“第二版”的书籍,是因为它代表着一种持续的改进和更新。通常,第二版会基于第一版的反馈,对内容进行优化,融入最新的技术发展,并修正可能存在的不足。这对于想要学习到最前沿、最实用知识的我来说,无疑是一个巨大的优势,它能帮助我避免走许多不必要的弯路,直接接触到经过实践检验的、高效的方法。 我非常期待这本书能够详细讲解如何应对各种复杂的网络抓取场景。例如,那些需要通过JavaScript动态加载数据的网页,或者那些设置了精巧的反爬虫机制的网站,它们往往是学习者在实践中遇到的最大挑战。我希望书中能够提供清晰的思路、详细的步骤,以及可运行的代码示例,让我能够从容应对这些技术难题。 除了技术层面的讲解,我也非常关心书中是否会涉及爬虫技术的伦理和法律方面的问题。毕竟,作为一名负责任的开发者,了解并遵守相关的规定是至关重要的。我希望作者能够在书中提供一些关于数据使用、网站合规性等方面的指导,帮助我树立正确的技术观。 对于技术书籍而言,语言的清晰度和易懂性是至关重要的。我希望这本书能够用简洁、流畅、且富有逻辑性的语言来阐述复杂的概念,避免使用过于专业化、令人生畏的术语。如果书中能辅以丰富的图表、流程图,以及可供动手实践的代码片段,那将大大提升我的学习效率和乐趣。 我特别注重书籍的实践性。我希望这本书能够提供一系列由浅入深的项目案例,让我能够在学习理论知识的同时,通过动手实践来巩固和加深理解。从简单的静态网页抓取,到处理更为复杂的动态网页,乃至能够独立构建一个完整的爬虫应用,这样的学习路径能够帮助我建立起扎实的技能基础,并培养解决实际问题的能力。 数据处理和存储也是我非常关心的一环。网络爬虫的最终目的是获取有用的数据,而如何有效地存储、清洗和分析这些数据,是体现爬虫价值的关键。我希望书中能够提供一些关于数据库选择、数据清洗技巧以及数据可视化等方面的实用建议,从而让我的爬虫项目更具实际应用价值。 除了内容本身,书籍的整体呈现方式也直接影响着我的阅读体验。我希望这本书的印刷质量、纸张的触感、以及整体的排版设计都能达到很高的水准,提供一个舒适、愉悦的阅读环境。 总而言之,我对这本书充满了高度的期待。我相信,通过阅读这本书,我能够系统地掌握Python Web Scraping的核心技术,并能够将其熟练地应用于各种实际的项目中,从而在海量的信息时代,发掘出属于自己的那片价值蓝海。这本书对我来说,不仅仅是一本技术宝典,更是一位经验丰富的导师,它将引领我深入探索Python爬虫的广阔世界。
评分这本书的封面设计给我的第一印象就是专业且极具吸引力。那种恰到好处的色彩运用和简洁的排版,让我觉得这本书的内容一定也同样精炼而有深度。我对Python在网络爬虫领域的强大表现一直充满兴趣,觉得这项技术就像一把神奇的钥匙,能够帮助我解锁互联网上隐藏的海量信息,让我能够更主动地获取和分析数据。 选择这本“第二版”的书籍,是因为我坚信“精益求精”是学习的关键。版本更新通常意味着作者在第一版的基础上,进行了大量的优化、改进,融入了最新的技术发展趋势,并且可能采纳了许多读者的宝贵反馈。这对于我这样渴望学习到最前沿、最实用知识的学习者来说,是一个非常重要的信息,它能帮助我少走许多弯路,直接接触到经过实践检验的、高效的学习方法。 我特别期待这本书能够深入讲解各种复杂场景下的网页抓取技术。比如,那些依赖于JavaScript动态加载内容的网页,又或者是那些设置了严密反爬虫机制的网站,它们往往是学习者在实际操作中会遇到的最大挑战。我希望这本书能够提供详细的步骤、清晰的思路,以及可以直接运行的代码示例,让我能够从容应对这些技术难题。 除了技术上的细节,我也非常关注书中是否会触及爬虫技术的伦理和法律边界。作为一名负责任的开发者,了解并遵守相关的法律法规以及行业道德规范是至关重要的。我希望作者能够在书中提供一些关于数据使用、网站合规性等方面的指导性建议,帮助我形成正确的技术价值观。 对于技术书籍而言,语言的通俗易懂和逻辑的严谨性是影响学习效果的关键因素。我期望这本书能够用简洁、流畅、且富有条理的语言来阐述复杂的概念,尽量避免使用那些可能让新手望而却步的专业术语。如果书中能够辅以丰富的图表、流程图,以及可供动手实践的代码片段,那将极大地提升我的学习效率和乐趣。 我非常看重书籍的实践性。我希望这本书能够提供一系列由浅入深的实战项目,让我能够在学习理论知识的同时,通过亲手实践来巩固和加深理解。从最基础的静态网页抓取,到处理具有一定复杂度的动态网页,再到能够独立构建一个完整的爬虫应用,这样的学习过程能够帮助我建立起扎实的技能基础,并培养解决实际问题的能力。 数据处理和存储也是我非常关心的一个环节。网络爬虫的最终目标是为了获取和利用数据,而如何有效地存储、清洗和分析这些数据,是体现爬虫技术价值的关键。我希望书中能够提供一些关于数据库选择、数据清洗技巧以及数据可视化等方面的实用建议,从而让我的爬虫项目更具实际应用价值。 除了内容本身,书籍的整体呈现方式也直接影响着我的阅读体验。我希望这本书的印刷质量、纸张的触感,以及整体的排版设计都能达到很高的水准,提供一个舒适、愉悦的阅读环境。 总而言之,我对这本书充满了高度的期待。我相信,通过阅读这本书,我能够系统地掌握Python Web Scraping的核心技术,并能够将其熟练地应用于各种实际的项目中,从而在浩瀚的互联网信息海洋中,发掘出属于自己的那片价值蓝海。这本书对我来说,不仅仅是一本技术宝典,更是一位经验丰富的向导,它将引领我深入探索Python爬虫的广阔世界。
评分这本书的封面设计给我一种专业且极具吸引力的感觉,那种沉稳的色调和简洁的字体排版,都暗示着其内容的扎实和深度。我一直以来都对Python在网络爬虫领域的应用充满好奇,觉得这项技术就像一把能够解锁互联网海量信息宝库的钥匙,让我能够更主动地获取和分析数据。对我而言,学习网络爬虫不仅仅是掌握一项技能,更是获得一种全新的信息获取和分析能力。 选择这本“第二版”的书籍,是因为它代表着一种持续的改进和更新。通常,第二版会基于第一版的反馈,对内容进行优化,融入最新的技术发展,并修正可能存在的不足。这对于我这样想要学习到最前沿、最实用知识的学习者来说,无疑是一个巨大的优势,它能帮助我避免走许多不必要的弯路,直接接触到经过实践检验的、高效的方法。 我非常期待这本书能够详细讲解如何应对各种复杂的网络抓取场景。例如,那些需要通过JavaScript动态加载数据的网页,或者那些设置了精巧的反爬虫机制的网站,它们往往是学习者在实践中遇到的最大挑战。我希望书中能够提供清晰的思路、详细的步骤,以及可运行的代码示例,让我能够从容应对这些技术难题。 除了技术层面的讲解,我也非常关心书中是否会涉及爬虫技术的伦理和法律方面的问题。毕竟,作为一名负责任的开发者,了解并遵守相关的规定是至关重要的。我希望作者能够在书中提供一些关于数据使用、网站合规性等方面的指导,帮助我树立正确的技术观。 对于技术书籍而言,语言的清晰度和易懂性是至关重要的。我希望这本书能够用简洁、流畅、且富有逻辑性的语言来阐述复杂的概念,避免使用过于专业化、令人生畏的术语。如果书中能辅以丰富的图表、流程图,以及可供动手实践的代码片段,那将大大提升我的学习效率和乐趣。 我特别注重书籍的实践性。我希望这本书能够提供一系列由浅入深的项目案例,让我能够在学习理论知识的同时,通过动手实践来巩固和加深理解。从简单的静态网页抓取,到处理更为复杂的动态网页,乃至能够独立构建一个完整的爬虫应用,这样的学习过程能够帮助我建立起扎实的技能基础,并培养解决实际问题的能力。 数据处理和存储也是我非常关心的一环。网络爬虫的最终目的是获取有用的数据,而如何有效地存储、清洗和分析这些数据,是体现爬虫价值的关键。我希望书中能够提供一些关于数据库选择、数据清洗技巧以及数据可视化等方面的实用建议,从而让我的爬虫项目更具实际应用价值。 除了内容本身,书籍的整体呈现方式也直接影响着我的阅读体验。我希望这本书的印刷质量、纸张的触感,以及整体的排版设计都能达到很高的水准,提供一个舒适、愉悦的阅读环境。 总而言之,我对这本书充满了高度的期待。我相信,通过阅读这本书,我能够系统地掌握Python Web Scraping的核心技术,并能够将其熟练地应用于各种实际的项目中,从而在海量的信息时代,发掘出属于自己的那片价值蓝海。这本书对我来说,不仅仅是一本技术宝典,更是一位经验丰富的向导,它将引领我深入探索Python爬虫的广阔世界。
评分这本书的装帧设计就足以引起我的注意,那种略显沉稳的色调,搭配上那种可以想象到指尖触碰书页时传来的触感,都让我对这本书充满了美好的憧憬。我对于网络爬虫技术一直抱有浓厚的兴趣,尤其是当它与Python这个强大且易于学习的语言相结合时,更是让我迫不及待地想要深入了解。在我看来,网络爬虫不仅仅是一种技术手段,它更像是一把能够解锁互联网海量信息宝库的万能钥匙。那些潜藏在网页深处的无数信息、那些错综复杂的数据,只要掌握了这项技能,就能够被我们一一发掘、分析和运用。 我之所以选择阅读这本书,是因为在琳琅满目的同类书籍中,“第二版”这个标签就意味着它不仅仅是技术的简单更新,更承载着作者的经验积累、对最新技术趋势的整合,以及对读者反馈的深度吸收。初版可能已经非常优秀,但第二版往往是对原有知识体系的优化、对前沿技术的吸收,以及对学习者痛点的关注。这种持续的迭代和优化,对于我们这些渴望高效学习的人来说,是至关重要的,它能帮助我们规避不必要的弯路,直接接触到经过实践检验的、最前沿的方法论。 我猜想,这本书的作者一定是对Python Web Scraping领域有着深刻理解和丰富实操经验的专家。从封面所传递出的专业感,我能够预见到书中内容会是严谨且富有洞察力的。我非常期待这本书不仅仅停留在“如何抓取”的表层,更能深入地探讨“为何采用这种抓取方式”、“如何实现更高效的抓取”、“以及如何确保抓取行为的合规性”等更深层次的思考。 我尤为关注书中能否详细讲解在面对各种复杂网页结构时的应对策略。例如,那些需要JavaScript动态加载的内容,那些依赖于前端渲染的页面,甚至是那些精心设计的反爬虫机制,它们都是网络爬虫学习者在实践中经常会遇到的“硬骨头”。我希望这本书能够提供一套行之有效的解决方案,让我在面对这些技术难题时,能够更加自信和从容。 这本书的语言风格也是我极其看重的一点。我期待作者能够用清晰、准确、生动的方式来阐述那些原本可能晦涩难懂的技术概念。避免使用过于专业化、让人望而却步的术语,而是能够采用一种循序渐进、娓娓道来的方式,引导读者一步步地走进Python爬虫的精彩世界。对于像我这样的初学者而言,一本能够让人真正读懂、读透的书,其价值远远超过一本充斥着大量专业术语却难以理解的书籍。 我希望这本书能够提供丰富的实际案例和具有挑战性的项目,这样我才能在学习理论知识的同时,通过亲手实践来巩固和加深我的理解。例如,从爬取最基础的静态网页入手,逐步过渡到处理更为复杂的动态网页,最终能够独立完成一个完整的爬虫项目。这样的学习路径,能够帮助我逐步建立起自信,并在实际操作中发现自己的不足,从而进行有针对性的改进。 这本书是否能包含一些关于数据存储和处理的实用建议,也是我非常关心的一个方面。网络爬虫的最终目标往往是为了获取有价值的数据,而如何有效地存储和处理这些数据,同样是整个流程中不可或缺的重要环节。我希望书中能够提供一些关于如何选择合适的数据库、如何进行数据清洗、以及如何进行数据可视化等方面的指导,从而让我的爬虫项目更具实际应用价值。 在学习网络爬虫技术的同时,合规性和道德性的考量也是我十分重视的。我希望这本书在教授技术要点的同时,也能着重强调遵守网站的服务协议、尊重网站的数据版权,以及避免对网站服务器造成不必要的压力。这种负责任的技术学习态度,对于任何一位技术领域的探索者来说,都应该被置于优先地位。 这本书的整体排版和印刷质量,也是我衡量一本书是否值得拥有的重要标准。清晰流畅的文字、合理的页面布局、以及高质量的纸张,这些细节能够极大地提升我的阅读体验。我期待这本书能在这些方面做到尽善尽美,让我在学习的过程中能够感受到一份愉悦和舒适。 总而言之,我对于这本书抱有极其崇高的期待。我坚信,通过深入阅读这本书,我能够全面掌握Python Web Scraping的核心技术,并将其灵活地应用于实际的项目开发中,从而在浩瀚的互联网信息海洋中,成功地发掘出属于自己的宝藏。这本书对我而言,不仅仅是一本技术指南,更像是一位经验丰富、循循善诱的向导,它将引领我在Python爬虫的奇妙世界里,开启一段精彩绝伦的探索旅程。
评分这本书的封面设计就足够吸引人,那种略带复古又不失现代感的色彩搭配,还有那种可以想象到指尖触碰书页的质感,都让我对这本书充满了期待。我一直对网络爬虫技术有着浓厚的兴趣,尤其是在Python这个如此强大且易于上手的语言加持下,更是让我跃跃欲试。在我看来,网络爬虫不仅仅是一种技术,它更像是一把解锁互联网信息宝藏的钥匙。想象一下,那些海量的数据,那些隐藏在网页深处的故事,只要掌握了这项技能,就能够被我们一一发掘和解读。 我之所以选择这本书,是因为在众多同类书籍中,它所传达出的“第二版”概念,让我觉得它不仅仅是技术的更新,更是经验的沉淀和升华。第一版可能已经足够出色,但第二版往往意味着对原有知识的梳理、对最新技术趋势的融合,以及对读者反馈的吸收。这种迭代和优化,对于学习者来说至关重要,它能够帮助我们避免走弯路,直接接触到最前沿、最实用、最经过检验的方法论。 这本书的作者,相信他/她一定是对Python Web Scraping领域有着深入研究和丰富实践的专家。从封面传递出的专业感,我能够预见到书中内容会是扎实且富有洞察力的。我希望这本书能够不仅仅停留在“如何爬取”的层面,更能深入到“为何如此爬取”、“如何高效爬取”、“如何合规爬取”等更深层次的思考。 我特别期待书中能够详细讲解在面对各种复杂网页结构时,如何运用Python的强大库来应对。例如,那些动态加载的内容,那些需要JavaScript渲染的页面,亦或是那些设置了反爬虫机制的网站,它们都是网络爬虫学习者常常会遇到的“拦路虎”。我希望这本书能够提供一套行之有效的解决方案,让我在面对这些挑战时,能够游刃有余。 这本书的语言风格也是我非常看重的一点。我希望作者能够用清晰、简洁、生动的方式来阐述复杂的概念。避免使用过于晦涩难懂的术语,而是能够循序渐进地引导读者进入爬虫的世界。对于我这样的初学者来说,一本能够让人读懂、读透的书,远比一本堆砌了大量专业词汇却难以理解的书更有价值。 我希望这本书能够提供一些实际的案例和项目,让我在学习理论知识的同时,也能通过动手实践来巩固和加深理解。例如,从爬取简单的静态网页,到处理更复杂的动态网页,再到实现一个完整的爬虫项目,这样的循序渐进的学习路径,能够让我逐渐建立起信心,并在实际操作中发现自己的不足,从而有针对性地去改进。 这本书是否能够包含一些关于数据存储和处理的建议,也是我非常关心的一点。网络爬虫的最终目的往往是为了获取数据,而如何有效地存储和处理这些获取到的数据,同样是一个重要的环节。我希望书中能够提供一些关于数据库选择、数据清洗、数据可视化等方面的指导,让我的爬虫项目能够更具实用性。 对于网络爬虫的学习,合规性和道德性也是非常重要的考量因素。我希望这本书能够在讲解技术的同时,也能够强调遵守网站的使用协议,尊重网站的数据所有权,以及避免对网站造成不必要的负担。这种负责任的学习态度,对于任何一个技术从业者来说,都应该被放在首位。 这本书的排版和印刷质量也是我衡量一本书价值的重要标准。清晰的文字、合理的布局、优质的纸张,这些都能极大地提升阅读体验。我希望这本书在这些细节上也能做到尽善尽美,让我在阅读过程中感到舒适和愉悦。 总而言之,我对于这本书充满了极高的期待。我相信,通过阅读这本书,我能够掌握Python Web Scraping的核心技术,并将其应用于实际项目中,从而在互联网信息的海洋中,找到属于自己的那片宝藏。这本书不仅仅是一本技术手册,更像是一位经验丰富的向导,指引我在Python爬虫的世界里,踏上精彩的探索之旅。
评分这本书的封面设计给我一种非常专业的印象,那精心设计的配色和简洁的排版,让我觉得这本书的内容一定也非常精炼且有深度。我一直以来都对Python在网络爬虫领域的强大能力充满好奇,觉得这项技术就像一把能够解锁互联网海量信息宝库的钥匙,让我能够更主动地获取和分析数据。对我而言,学习网络爬虫不仅仅是掌握一项技能,更是获得一种全新的信息获取和分析能力。 选择这本“第二版”的书籍,是因为它代表着一种持续的改进和更新。通常,第二版会基于第一版的反馈,对内容进行优化,融入最新的技术发展,并修正可能存在的不足。这对于我这样想要学习到最前沿、最实用知识的学习者来说,无疑是一个巨大的优势,它能帮助我避免走许多不必要的弯路,直接接触到经过实践检验的、高效的方法。 我非常期待这本书能够详细讲解如何应对各种复杂的网络抓取场景。例如,那些需要通过JavaScript动态加载数据的网页,或者那些设置了精巧的反爬虫机制的网站,它们往往是学习者在实践中遇到的最大挑战。我希望书中能够提供清晰的思路、详细的步骤,以及可运行的代码示例,让我能够从容应对这些技术难题。 除了技术层面的讲解,我也非常关心书中是否会涉及爬虫技术的伦理和法律方面的问题。毕竟,作为一名负责任的开发者,了解并遵守相关的规定是至关重要的。我希望作者能够在书中提供一些关于数据使用、网站合规性等方面的指导,帮助我树立正确的技术观。 对于技术书籍而言,语言的清晰度和易懂性是至关重要的。我希望这本书能够用简洁、流畅、且富有逻辑性的语言来阐述复杂的概念,避免使用过于专业化、令人生畏的术语。如果书中能辅以丰富的图表、流程图,以及可供动手实践的代码片段,那将大大提升我的学习效率和乐趣。 我特别注重书籍的实践性。我希望这本书能够提供一系列由浅入深的项目案例,让我能够在学习理论知识的同时,通过动手实践来巩固和加深理解。从简单的静态网页抓取,到处理更为复杂的动态网页,乃至能够独立构建一个完整的爬虫应用,这样的学习过程能够帮助我建立起扎实的技能基础,并培养解决实际问题的能力。 数据处理和存储也是我非常关心的一环。网络爬虫的最终目的是获取有用的数据,而如何有效地存储、清洗和分析这些数据,是体现爬虫价值的关键。我希望书中能够提供一些关于数据库选择、数据清洗技巧以及数据可视化等方面的实用建议,从而让我的爬虫项目更具实际应用价值。 除了内容本身,书籍的整体呈现方式也直接影响着我的阅读体验。我希望这本书的印刷质量、纸张的触感,以及整体的排版设计都能达到很高的水准,提供一个舒适、愉悦的阅读环境。 总而言之,我对这本书充满了高度的期待。我相信,通过阅读这本书,我能够系统地掌握Python Web Scraping的核心技术,并能够将其熟练地应用于各种实际的项目中,从而在海量的信息时代,发掘出属于自己的那片价值蓝海。这本书对我来说,不仅仅是一本技术宝典,更是一位经验丰富的向导,它将引领我深入探索Python爬虫的广阔世界。
评分 评分 评分 评分 评分相关图书









本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有