
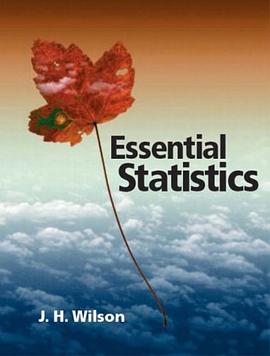

具体描述
For undergraduate psychology statistics courses. This book presents all statistics essential to a student through a conversational style approach, focusing on reducing anxiety about statistics, making statistics relevant and interesting, and incorporating SPSS to show students how to analyze data efficiently. To encourage students enthusiasm of statistics and hold their interest, this book includes only those analyses that are necessary to build skills or will likely be used by them in their future.
作者简介
目录信息
读后感
用户评价
我用了好几周时间消化这本书的内容,坦白说,它成功地将我从对统计学的恐惧中解救了出来,但它在某些高级主题的处理上,确实展现出一种“点到为止”的克制。对于那些期望深入探究回归模型假设检验的细微差别、或者想要精通非参数统计方法的读者来说,这本书的深度可能略显不足。它的大部分篇幅致力于打下坚实的描述性统计和基础推断统计的基础,这对于初学者非常完美,但对于已经有一定基础,想要迈向更精细化分析的人来说,可能很快就会感觉内容有些浅尝辄止。举例来说,在讨论多重共线性时,书中给出的诊断方法和修正建议相对基础,没有过多涉及如岭回归或 Lasso 等更现代、更复杂的处理技术。因此,我更倾向于将这本书定位为一座坚固的“地基”,而非一栋可以承载复杂学术大厦的“主体结构”。如果你需要一本能帮你快速建立框架,理解核心概念,并能自信地解读常见统计报告的书,它无疑是优选;但如果你正处于需要撰写高阶计量论文的阶段,你可能需要寻找更专业、更深入的补充材料来填补它留下的知识空白。它的价值在于普及和入门,而非尖端研究。
评分这本书简直是统计学学习者的福音,特别是对于那些和我一样,初次接触这个领域,面对复杂的公式和抽象的概念感到无从下手的人来说。它的叙述方式极其平易近人,仿佛一位耐心的导师在耳边细细讲解,而不是冷冰冰的教科书。作者在引入每一个核心概念时,都会先用一个贴近日常生活的例子来构建直观的理解基础,比如用抛硬币的频率来解释概率,用班级体重的差异来引入方差的概念。这种“先体验,后定义”的教学法,极大地降低了学习的心理门槛。我特别欣赏它对“为什么”的深入剖析,而不是仅仅停留在“怎么做”的层面。它不仅仅教你如何计算P值,更会花篇幅解释P值背后的哲学含义以及在实际科研或商业决策中可能存在的误用和陷阱。书中大量的图示和流程图也功不可没,它们将原本枯燥的步骤分解得一目了然,使得我在试图用软件进行实证分析时,能够清晰地对照书中的步骤进行操作,有效避免了因为步骤遗漏而导致的错误结果。这种注重逻辑构建和实际应用导向的写作风格,让我感觉我不是在被动地接收知识,而是在主动地构建我的统计思维框架。对于希望真正掌握统计学思想精髓,而非仅仅应付考试的人来说,这本书无疑是极佳的入门读物。
评分从教学工具的角度来看,这本书的配套资源显得非常单薄,这让我的学习过程多了一层不必要的摩擦。虽然书本内容本身组织得还算不错,但缺乏高质量的在线辅助材料,比如可供下载的课后习题答案解析,或者作者提供的用于演示的真实数据集和代码示例,无疑削弱了其实用价值。作为一本统计学著作,实践是检验真理的唯一标准,然而,书后附带的练习题往往只提供了最终的数值结果,完全没有给出详细的解题步骤——尤其是那些涉及到复杂公式转换或假设检验的案例,读者很难判断自己是在哪个环节出现了逻辑错误。我不得不花费大量时间去查阅论坛和向同行求助,才能验证我的计算过程是否正确。如果作者能够提供一个配套的网站,定期更新与书中概念相匹配的R或Python代码片段,并附带详细的注释,说明如何运用软件实现书中的理论推导,那将极大地提升这本书的教学效率和学习的趣味性。目前这种“光有理论,缺乏实操辅导”的状态,使得它的实用性大打折扣,更像是一本知识的展示册,而非一本可以“做中学”的工具书。
评分这本书的作者似乎非常执着于采用一种非常保守和传统的统计学流派来组织内容,这在某些方面是优点,比如保证了理论的经典性和稳定性,但在面对当代数据科学的快速发展时,就显得有些滞后了。我发现书中对贝叶斯统计方法的讨论少得可怜,几乎是蜻蜓点水,这在今天的量化分析领域,尤其是在机器学习和高级预测模型构建中,是一个明显的缺失。现代的数据分析师和统计学家越来越倾向于使用贝叶斯方法来处理小样本数据或需要整合先验知识的复杂问题,而这本书似乎仍然将焦点紧紧锁定在经典的频率学派框架内。此外,对于如何处理现代大数据集带来的挑战,例如维度灾难、高维数据的可视化等,书中也几乎没有涉及。它更像是一本为上世纪八九十年代的社会科学研究者量身定制的指南,强调了正态分布和线性假设的稳健性,却未能充分引导读者走向更具适应性和灵活性的现代统计工具箱。对于想要与时俱进,接触前沿量化方法的读者来说,这本书提供的视角略显狭隘,需要大量补充其他更现代的教材才能跟上行业步伐。
评分阅读体验上,这本书的排版设计简直是一场灾难,完全没有考虑到读者的舒适度。字体选择偏小,行间距又极其局促,使得长时间阅读下来,眼睛非常容易疲劳。更要命的是,那些关键的公式和推导过程,虽然内容上或许是严谨的,但其在页面上的呈现方式却显得十分拥挤,很多重要的下标和上标被挤压在一起,初次接触的人很容易混淆变量的含义。例如,在讲解最大似然估计(MLE)的部分,连续好几页的数学推导堆砌在一起,缺乏必要的留白或者用醒目的框来隔离关键步骤,使得读者在追踪逻辑链条时常常需要反复回溯,极大地打断了思路的连贯性。我不得不经常借助外部的电子笔记软件,将书中的关键图表和公式重新誊抄出来,重新格式化后才能清晰地理解其内在的逻辑关系。对于一本如此强调清晰逻辑和步骤分析的统计教材而言,这种糟糕的视觉呈现无疑是一种巨大的减分项。希望未来再版时,出版商能聘请一位真正懂得如何设计学术书籍版面的人来重新校对和排版,提升读者的实际使用体验。
评分 评分 评分 评分 评分相关图书








本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有