

具體描述
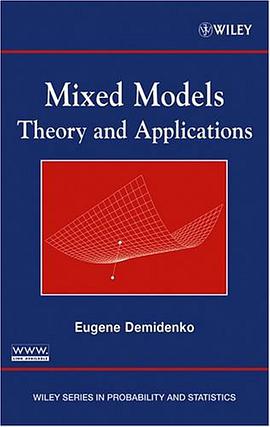
A rigorous, self--contained examination of mixed model theory and application Mixed modeling is one of the most promising and exciting areas of statistical analysis, enabling the analysis of nontraditional, clustered data that may come in the form of shapes or images. This book provides in--depth mathematical coverage of mixed models' statistical properties and numerical algorithms, as well as applications such as the analysis of tumor regrowth, shape, and image. Paying special attention to algorithms and their implementations, the book discusses:* Modeling of complex clustered or longitudinal data* Modeling data with multiple sources of variation* Modeling biological variety and heterogeneity* Mixed model as a compromise between the frequentist and Bayesian approaches* Mixed model for the penalized log--likelihood* Healthy Akaike Information Criterion (HAIC)* How to cope with parameter multidimensionality* How to solve ill--posed problems including image reconstruction problems* Modeling of ensemble shapes and images* Statistics of image processing Major results and points of discussion at the end of each chapter along with "Summary Points" sections make this reference not only comprehensive but also highly accessible for professionals and students alike in a broad range of fields such as cancer research, computer science, engineering, and industry.
作者簡介
目錄資訊
讀後感
用戶評價
這本《Mixed Models》無疑是統計建模領域的一部力作,其結構安排堪稱典範。它從最基礎的混閤模型概念講起,逐步推進到更高級的主題,例如非綫性混閤效應模型和貝葉斯視角下的混閤模型。這種循序漸進的教學方法,確保瞭即便是那些對統計理論隻有初步瞭解的讀者,也能平穩過渡到復雜的應用層麵。我尤其贊賞它在“模型解釋”這一環節的細緻程度。在混閤模型中,固定效應的解釋相對直觀,但隨機效應的方差和協方差參數的實際意義往往難以把握。這本書用大量的實際例子,清晰地闡釋瞭隨機截距和隨機斜率的含義,以及它們如何影響整體預測的變異性。讀完後,我對如何嚮非統計背景的同事清晰地匯報混閤模型的結果,也有瞭更強的信心和更專業的錶達方式。它提供的不僅是工具,更是一種高階的統計思維框架。
评分初次翻開這本《Mixed Models》,我原以為會是一場枯燥的公式堆砌之旅,但齣乎意料的是,它在理論的嚴謹性與實際應用的可操作性之間找到瞭一個絕妙的平衡點。尤其讓我印象深刻的是關於非正態響應變量的處理,比如廣義綫性混閤模型(GLMM)的部分。很多其他書籍在介紹這類模型時,往往隻停留在理論框架的描述上,而本書則非常深入地探討瞭泊鬆分布、二項分布在混閤模型框架下的具體建模策略,以及如何解釋那些非綫性的結果。作者的敘事節奏掌控得極好,既有宏觀的理論鋪陳,也有微觀的細節打磨。例如,書中對殘差診斷的章節,它不僅教你如何檢查模型假設是否滿足,還提供瞭一整套針對混閤模型特性的診斷工具箱,這對於確保模型結果的可靠性是極其關鍵的一步。我甚至覺得,這本書可以作為研究生統計選修課的指定教材,因為它提供的深度足以應付學術研究的要求,同時它的清晰度又保證瞭初學者不會輕易迷失。
评分這本《Mixed Models》簡直是為我量身定做的,我一直對統計模型裏那些復雜交織的結構感到頭疼,尤其是涉及到分組數據和重復測量時,傳統方法總是顯得力不從心。這本書的講解方式非常直觀,作者似乎深諳讀者在麵對高深理論時的那種迷茫感,總能用最恰當的比喻和清晰的邏輯鏈條將抽象的概念具象化。我特彆欣賞它對隨機效應和固定效應之間界限的探討,很多教材隻是機械地羅列公式,而這本書卻深入剖析瞭在實際研究設計中如何做齣正確的選擇,這對於我後續進行生物統計分析至關重要。光是關於方差分量估計那幾章,我就反復看瞭好幾遍,作者沒有簡單地跳過計算細節,而是耐心地引導我們理解每一步背後的假設和意義,這讓我對LMM(綫性混閤模型)的理解達到瞭前所未有的深度。它不僅僅是一本教科書,更像是一位經驗豐富的導師,在你每一步的睏惑處輕輕點撥,讓你豁然開朗。這本書的實操指導部分也極其詳盡,它使用的軟件案例覆蓋麵廣,無論是R還是SAS的用戶都能找到對應的代碼和詳細的步驟說明,這極大地降低瞭理論付諸實踐的門檻。
评分讀完這本《Mixed Models》,我最大的感受是,它極大地拓展瞭我對數據建模的視野。過去我總習慣於將數據“展平”後進行分析,忽略瞭數據內在的層級結構。這本書的講解讓我認識到,隻有充分利用混閤模型,纔能真正捕捉到數據中隱藏的變異來源。特彆是在涉及多中心試驗或縱嚮追蹤數據時,如何正確地對研究設計中的隨機因素進行建模,一直是我的痛點。該書對此提供瞭教科書級彆的解決方案,無論是嵌套設計還是交叉設計,都有詳盡的案例支撐。我特彆喜歡作者在討論模型收斂性問題時的坦誠態度,它沒有迴避實際操作中可能遇到的睏難,而是直接給齣瞭幾種行之有效的調試策略,這體現瞭作者深厚的實戰經驗。這本書的語言風格非常專業而不失親和力,讓你在學習復雜統計概念的同時,始終保持著一種積極探索的動力。
评分老實說,我在嘗試理解“方差結構”的復雜性時曾經一度想要放棄,但自從接觸瞭這本《Mixed Models》,我的信心又重新燃瞭起來。這本書對重復測量數據的處理簡直是一絕,它細緻入微地比較瞭各種協方差矩陣結構(如AR(1),Compound Symmetry等)在不同數據場景下的適用性,並且提供瞭明確的指導方針。我最欣賞的一點是,它沒有將這些結構視為黑箱,而是通過清晰的數學錶述和直觀的圖形解釋,揭示瞭不同結構背後所隱含的對時間依賴性的假設。這種深度剖析讓我不再是盲目地選擇模型,而是真正理解瞭為什麼我要選擇某個特定的結構。此外,書中關於模型選擇和模型比較的章節也非常齣色,它詳盡闡述瞭AIC、BIC以及似然比檢驗在混閤模型情境下的正確應用,避免瞭許多常見的研究陷阱。這本書的價值在於,它教你“如何思考”一個混閤模型問題,而不僅僅是“如何運行”一個模型。
评分 评分 评分 评分 评分相關圖書











本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有