
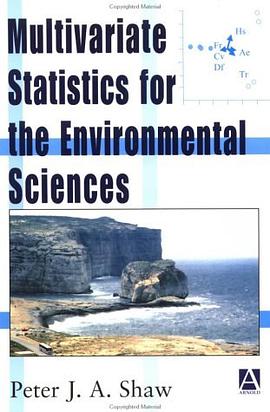
Multivariate Statistics for the Environmental Sciences pdf epub mobi txt 电子书 下载 2026
- Multivariate Statistics
- Environmental Science
- Data Analysis
- Statistical Modeling
- Ecology
- Environmental Monitoring
- R
- SPSS
- Python
- Applied Statistics

具体描述
This book introduces the most commonly used techniques for dealing with multivariate data; the sort of multi-species multi-chemical data sets that are routinely encountered in environmental investigations. It assumes prior knowledge of multivariate analyses and requires no mathematics beyond simple linear equations. The topics covered include diversity indices, multiple regression, cluster analysis, and the commoner ordination techniques (principal components analysis, detreded correspondence analysis and canonical correspondence analysis). Other less used ordinations (Bray-Curtis, Correspondence Analysis) are where this helps understanding of the most commonly used techniques. Where suitable, the author shows how to construct biplots and triplots, and how to run Monte-Carlo testing. Each technique is illustrated by worked examples using simple, familiar data sets, and the key features of the output from standard software packages is explained. Pitfalls for the unwary are highlighted wherever they occur. Appendices list and explain the acronyms that can make some published research impenetrable. The availability of each multivariate technique in all major software packages is listed, to help users choose the software suitable for them. The overall aim of the book is to introduce inexperienced users gently to the multivariate analytical tools available to them.
作者简介
目录信息
读后感
用户评价
我必须承认,这本书的难度曲线相对陡峭,尤其是在处理分类数据和非参数多元方法时,作者毫不避讳地深入探讨了如对应分析(CA)和多维标度(MDS)背后的数学原理。对于那些期待一上来就能看到大量现成代码片段的读者来说,初期可能会感到有些吃力,因为它要求读者具备一定的矩阵代数基础,或者至少愿意花时间去理解那些看似枯燥的矩阵运算如何对应到实际数据的投影和旋转上。然而,一旦你跨过了这个门槛,你会发现对底层机制的理解是多么强大。书中关于“高维数据可视化”的章节尤其值得称赞,它不仅仅展示了如何用散点图矩阵来初步探索数据,还深入探讨了如t-SNE和UMAP等现代降维技术在识别生态群落边界时的潜力与局限性。作者在讨论这些前沿方法时,依然保持着对“环境可解释性”的坚持,时刻提醒我们,统计模型的美观不应以牺牲科学意义为代价。这是一本需要反复研读、并时常回到前面章节查阅参考的工具书,它的价值随着实践经验的增加而愈发凸显。
评分这本书的结构安排极具匠心,它不是按统计方法本身来组织章节,而是更倾向于围绕“环境科学中的核心问题”来组织统计工具的应用。例如,在处理“空间自相关性”这一环境科学的顽疾时,它自然而然地引入了涉及协方差结构矩阵的知识,然后巧妙地将地理加权回归(GWR)和空间滞后模型作为处理空间异质性的高级工具来介绍。这种“问题驱动”的叙述方式,极大地提升了阅读的连贯性和目的性。我发现自己不再是被动地学习一个接一个的统计技术,而是主动地去寻找解决特定环境难题的最佳统计工具组合。书中对时间序列数据的处理部分也十分精彩,它没有泛泛而谈,而是聚焦于环境监测中常见的周期性波动(如季节性)和趋势分解,并详细比较了ARIMA模型与状态空间模型在处理缺失或不规则采样数据时的优劣。对我来说,最大的收获在于理解了如何将不同尺度、不同性质的环境变量(如气象因子、土壤化学指标、生物群落数据)纳入一个统一的、具有可解释性的统计框架内进行综合分析。
评分这本书的语言风格带着一种严谨而又富有激情的学者气息,仿佛作者本人正站在我们面前,耐心地、毫无保留地分享他多年积累的知识财富。我常常被作者在阐述统计推断背后的哲学意义时所吸引。他不仅仅告诉我们“如何做”,更重要的是解释了“为什么这样做是合理的”。比如,在讨论多元回归中的多重共线性问题时,书中的描述远远超出了教科书式的定义,它结合了大气污染物的交互作用模型,解释了变量间高度相关性在环境系统中的自然成因,然后才引出VIF(方差膨胀因子)等诊断工具。这种从宏观环境问题到微观统计解决方法的无缝对接,让学习过程充满了启发性。阅读体验上,虽然涉及矩阵代数和特征值分解等内容,但作者通过大量生动的类比,比如将数据降维比作在复杂地形中寻找最主要的坡度方向,成功地降低了数学上的畏惧感。对于那些寻求深入理解统计模型内在机制而非仅仅停留在软件操作层面的读者,这本书提供了难得的深度。它要求读者投入时间去思考和消化,但所获得的回报是扎实、稳固的知识结构,这在当前信息碎片化的时代显得尤为珍贵。
评分这本书的封面设计充满了宁静而深邃的蓝色调,给人一种置身于广阔海洋或深邃森林的直观感受,非常贴合“环境科学”的主题。内页的排版简洁而专业,大量图表的运用使得原本抽象的多元统计概念变得生动易懂。我尤其欣赏作者在引入复杂模型时的循序渐进,从基础的协方差矩阵开始,逐步过渡到主成分分析、因子分析,再到更高级的判别分析和聚类分析。对于我这种在环境监测领域工作多年,但统计基础相对薄弱的人来说,这种结构设计简直是福音。书中大量的案例研究,比如水质污染源的识别、生态系统多样性的量化等,都直接与我的日常工作息息相关,这极大地增强了阅读的代入感和实用价值。讲解过程中,作者并没有仅仅停留在公式的罗列,而是深入剖析了每种方法背后的统计假设和适用条件,这对于确保我们能正确应用这些工具至关重要。例如,在解释如何选择最优主成分数量时,不仅给出了碎石图(Scree Plot)的判断标准,还结合了环境变异性的解释力百分比进行了深入讨论,使得读者能够形成更加成熟的统计思维。整体来看,它不仅仅是一本统计教科书,更像是一本环境数据分析的实战手册,强烈推荐给所有处理复杂环境数据集的同行们。
评分我必须说,这本书在理论深度上达到了一个令人敬佩的高度,但更令人称道的是它对现代计算方法的集成。不同于一些老旧的统计教材,这本书紧密结合了R语言(虽然书名未明示,但示例代码的风格和函数调用习惯指向性很强)的实际操作环境。章节之间关于“模型诊断与残差分析”的讨论非常细致入微,远超我以往接触的任何一本环境统计入门或进阶书籍。作者对多元正态性检验、同方差性检验的讨论,不仅提供了传统的统计检验方法,还强调了基于图形化的诊断,比如QQ图和残差-拟合值的散点图在多元空间中的解读难度与技巧。特别是关于“结构方程模型(SEM)”的介绍部分,虽然篇幅适中,但清晰地勾勒出了其在环境路径分析中的应用潜力,展示了如何用一个统一的框架来检验复杂的生态假设链条。我个人认为,这本书最适合已经掌握了基本统计概念,并希望将统计工具应用于复杂、多变量环境数据集的硕士研究生或初级研究人员。它不是一本让你迅速学会点鼠标的“速成手册”,而是一本帮你构建稳固分析框架的“基石”。
评分 评分 评分 评分 评分相关图书


本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有