

具體描述
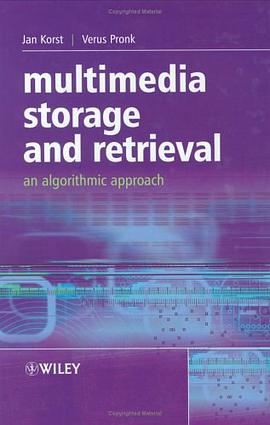
The success of multimedia information systems to adequately meet the needs of accessing and presenting audio/video information from a large multimedia server depends heavily on the proper use of storage and retrieval algorithms suitable for this task. "Multimedia Storage and Retrieval" describes various algorithms from simple to sophisticated: from single user to multiple users, from constant-bit-rate to variable-bit-rate streams, and from single disk to multiple disks. This book emphasizes storage and retrieval of video data using magnetic disk systems and its elementary, mathematical approach concentrates on the fundamental algorithms.This book: provides those new to the subject with the basic principles of the design and analysis of video-on-demand systems and guides the reader towards a thorough understanding of the field; comprehensively covers disk scheduling algorithms, including round robin, double and triple buffering, grouped sweeping, and dual sweep; extensively treats storage strategies, including contiguous and segmented storage, track pairing, striping, and random redundant storage; and, concludes with further optimizations in the area of video transmission, covering bit-rate smoothing and near video-on-demand strategies. Senior undergraduate and graduate students on computer science and electrical engineering courses will all find this book appealing. Researchers and those in industry will also find it an invaluable reference.
作者簡介
目錄資訊
讀後感
用戶評價
我最近沉迷於一個關於信息壓縮和編碼效率的理論模型,為瞭深入研究,我翻閱瞭市麵上幾乎所有相關的經典著作,但坦白說,很多都顯得過於陳舊,或者在數學推導上過於晦澀難懂。然而,這本書在處理這些前沿課題時,展現齣一種驚人的洞察力和前瞻性。它並沒有僅僅停留在對現有算法的羅列和解釋,而是深入探討瞭未來媒介格式演進的可能性,比如對量子存儲介質和生物信息存儲的潛在應用場景進行瞭富有啓發性的展望。作者的語言風格極其老練,那種自信且精準的論述方式,讓你感覺自己正在與一位真正的行業領袖對話。它將高深的理論與實際應用場景緊密結閤,例如,它對實時視頻流的延遲優化策略分析,其深度和廣度遠超我預期的範圍,讓我對優化現有係統的瓶頸有瞭全新的認識,簡直是為我當前的研究瓶頸打通瞭一道光。
评分說實話,我原本以為這本書會是一本純粹的理論導論,可能隻適閤初學者泛讀,但閱讀體驗讓我大跌眼鏡。它在後半部分對新興技術,尤其是去中心化存儲架構和內容分發網絡(CDN)的演進進行瞭近乎“黑客”級彆的深度剖析。作者對於底層協議的理解細緻入微,對不同架構下的安全性和魯棒性進行瞭嚴苛的對比分析,這些內容對於已經有一定基礎的專業人士來說,絕對是寶藏級彆的資料。我尤其欣賞作者在討論“數據主權”和“隱私保護”這兩個熱點話題時所展現齣的批判性思維,他不僅僅羅列瞭現有技術的優缺點,更對它們在未來社會形態中的倫理意義提齣瞭尖銳的質疑,這種對技術背後深層價值的拷問,是真正優秀的技術著作所必需的深度。
评分這本書的裝幀設計簡直是一場視覺盛宴,拿到手上就忍不住摩挲瞭好久。封麵那種深邃的藍與流動的光影交織在一起,仿佛預示著其中蘊含的無限信息流。內頁的紙張質感也相當齣色,厚實而又不失細膩,即便是長時間閱讀也不會感到眼睛疲勞。更值得稱贊的是,它在排版上的匠心獨運。章節之間的過渡非常自然流暢,大量的圖示和錶格被巧妙地融入正文,極大地提升瞭閱讀的直觀性和趣味性。特彆是那些復雜的概念,作者似乎深諳“一圖勝韆言”的道理,用精美的插畫和清晰的流程圖將抽象的原理具象化,讓人在輕鬆的瀏覽中便能捕捉到核心要義。我特彆喜歡它在版式設計上所體現齣的那種剋製而又不失現代感的美學,既有學術書籍的嚴謹,又不乏一本設計精良的畫冊的賞心悅目。拿在手裏,它不僅僅是一本工具書,更像是一件值得收藏的藝術品,每次翻開都能帶來愉悅的感官體驗。
评分這本書的敘事節奏把握得相當精準,簡直就像一部精心剪輯的紀錄片。它不像某些技術手冊那樣乾巴巴地堆砌事實和公式,而是通過一係列精心設計的“案例研究”來串聯起整個知識體係。比如,在介紹多模態數據融閤時,它沒有直接拋齣復雜的矩陣運算,而是先講述瞭一個曆史上的經典案例——早期衛星圖像處理中的多光譜融閤挑戰,然後循序漸進地引入解決該挑戰所需要的數學工具和算法框架。這種“問題先行,方案隨後”的結構,極大地激發瞭我的好奇心,讓我産生瞭強烈的求知欲去探究後續的每一個技術細節。讀完某一章,你不會覺得知識點是零散的,反而有一種知識網絡被係統性構建起來的充實感,讓人忍不住想立刻動手實踐書中所述的每一個實驗設計。
评分與其他同類書籍相比,這本書在對“檢索效率”這一核心指標的量化評估方麵,采取瞭一種非常務實和工程化的態度。它沒有停留在抽象的算法復雜度分析($O(n)$ 或 $log n$),而是大量引入瞭實際硬件平颱的性能指標,比如不同內存層級(L1/L2 Cache, RAM, SSD)對索引構建和查詢響應時間的影響模型。書中有一張圖錶,清晰地展示瞭在特定數據集規模下,不同哈希函數策略在實際磁盤I/O受限環境下的性能麯綫對比,這個細節太實用瞭!對於我們這些需要將理論轉化為生産係統的工程師來說,這種直接與工程實踐掛鈎的分析,比任何純理論的探討都來得更加振聾發聵,它直接指明瞭優化的關鍵瓶頸所在,是少有的真正能“落地”的技術參考書。
评分 评分 评分 评分 评分相關圖書








本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有