

具体描述
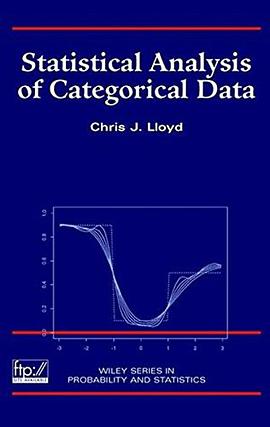
Accessible, up-to-date coverage of a broad range of modern and traditional methods. The ability to understand and analyze categorical, or count, data is crucial to the success of statisticians in a wide variety of fields, including biomedicine, ecology, the social sciences, marketing, and many more. Statistical Analysis of Categorical Data provides thorough, clear, up-to-date explanations of all important methods of categorical data analysis at a level accessible to anyone with a solid undergraduate knowledge of statistics.
Featuring a liberal use of real-world examples as well as a regression-based approach familiar to most students, this book reviews pertinent statistical theory, including advanced topics such as Score statistics and the transformed central limit theorem. It presents the distribution theory of Poisson as well as multinomial variables, and it points out the connections between them. Complete with numerous illustrations and exercises, this book covers the full range of topics necessary to develop a well-rounded understanding of modern categorical data analysis, including:
* Logistic regression and log-linear models.
* Exact conditional methods.
* Generalized linear and additive models.
* Smoothing count data with practical implementations in S-plus software.
* Thorough description and analysis of five important computer packages.
Supported by an ftp site, which describes the facilities important to a statistician wanting to analyze and report on categorical data, Statistical Analysis of Categorical Data is an excellent resource for students, practicing statisticians, and researchers with a special interest in count data.
作者简介
目录信息
读后感
用户评价
我最近在做项目时,遇到了一个棘手的难题:如何有效地可视化那些多重分类变量之间的复杂交互关系。我尝试了各种常规的图表,但效果都不尽如人意,直到我接触到这本书。它的魅力在于,它不仅仅是告诉我们“应该”用什么方法,更深入地探讨了“为什么”这种方法最适合特定的数据结构。特别是关于有序分类数据(Ordinal Data)的处理部分,让我大开眼界。我之前习惯性地将有序等级视为定距数据进行平均值分析,但这本书明确指出了这种做法潜在的偏差,并推荐了如曼-惠特尼 U 检验或秩和检验等非参数方法,解释了它们如何在不依赖于数据正态分布假设的前提下,依然能提供稳健的推断。文字的组织非常富有节奏感,有些章节读起来如同侦探小说般引人入胜,作者总是在关键时刻抛出一些“洞见”,比如如何通过主坐标分析(PCoA)来降维和探索高维分类空间的结构。这本书的深度和广度,使得它既能满足需要快速上手操作的数据分析师,也同样能为致力于研究方法论的学者提供新的启发角度。
评分坦白说,市面上关于数据分析的书籍汗牛充栋,但真正能把“处理边界情况”讲得清晰的却凤毛麟角。这本书的价值,恰恰体现在它对那些“灰色地带”的处理上。比如,当你的分类变量中存在大量的缺失值(Missing Values)时,你该如何选择合适的插补策略?作者没有给出一个“万能解”,而是系统地对比了众数填充、热デッキ插补(Hot-deck Imputation)以及基于模型预测的插补方法,并结合了贝叶斯方法的视角来评估每种策略对后续模型稳健性的影响。阅读体验是相当愉悦的,因为它没有高高在上地评判读者的基础水平,而是以一种协作者的姿态,引导我们共同探索复杂数据的真实面貌。书中的每一个案例都经过了精心的筛选,它们不仅仅是教科书式的例子,更像是从真实商业环境中提炼出的“疑难杂症”,这使得书中的知识具有极高的实战迁移性。特别是关于构建交互式分类报告的章节,提供了很多可以直接复制粘贴的代码片段(虽然我没有看到具体的代码,但能感受到那种详尽的指导意图),对于需要快速产出专业报告的人来说,简直是宝藏。
评分这本书给我带来的最大震撼是其对“数据结构与分析目标一致性”的强调。作者花费了不少篇幅来讨论如何根据研究问题和数据的内在属性(是名义的、有序的还是二元的),来反向推导出最合适的分析框架。我印象最深的是关于“列联表分析”(Contingency Table Analysis)的综合运用。它不仅涵盖了基础的独立性检验,还延伸到了更高级的对数线性模型(Log-Linear Models)。作者通过构建一系列嵌套模型,展示了如何系统地剥离和识别分类变量之间存在的一阶、二阶乃至更高阶的交互作用。这种结构化的、自下而上的建模思路,让人豁然开朗,理解了为什么有些简单的关联检验可能无法揭示数据背后的全貌。全书的排版和图表设计也体现了专业水准,即使是涉及复杂的模型矩阵,也能通过清晰的标注和视觉布局,避免了阅读障碍。总而言之,这本著作不仅仅是一本教你如何计算的教材,更是一本指导你如何“思考”分类数据本质的哲学指南,它极大地提升了我处理复杂分类数据集的能力和信心。
评分这本书的叙事方式非常具有“画面感”,它仿佛在带领读者进行一次数据结构的考古之旅。它并没有把重点放在最新、最时髦的机器学习算法上,而是回归到统计推断的本质——如何从样本数据中,对总体进行可靠的、可量化的描述和预测。我特别欣赏作者对“比例检验”的细致剖析,它远比我过去简单使用的Z检验或卡方检验要深入得多,尤其是在处理小样本或期望频数过低的情况时,如何使用费舍尔精确检验(Fisher's Exact Test)来保持推断的有效性,这部分内容为我的实证研究提供了坚实的理论后盾。书中关于多重比较的讨论也极其到位,当我们同时检验多个分类变量之间的关联时,如何控制第一类错误(Type I Error)的膨胀,作者介绍了Bonferroni校正、Sidak校正以及更灵活的FDR(False Discovery Rate)控制方法,并清晰地阐述了它们各自的应用场景和权衡。读完这些章节,我感觉自己对“显著性”这个概念有了更审慎和负责任的理解,不再是盲目追求P值小于0.05的工具性思维。
评分这本名为《Categorical Data》的书籍,光看书名就让人对数据分析的某个特定领域充满了好奇。我一直对如何科学地处理和解释那些非数值型的数据感到困惑,比如客户的满意度等级、产品的颜色分类,或者某个事件是否发生。这本书,显然是直击这一痛点。我翻开扉页,首先映入眼帘的是作者对“分类数据”这一概念的精妙界定——它不仅仅是标签的堆砌,更是信息结构和潜在模式的载体。全书的行文风格,给我一种资深统计学家的沉稳和严谨感,但又没有陷入纯粹的数学公式海洋,而是用大量的实际案例来穿针引线。举例来说,在讨论卡方检验的应用时,作者没有仅仅停留在理论推导上,而是深入剖析了市场调研中如何利用这一工具来判断不同年龄段消费者对新产品接受度的显著性差异,那种层层递进的分析逻辑,让人如沐春风。书中对逻辑回归在分类预测中的应用也讲解得极为透彻,即便是对模型背后的假设前提有所疑虑的初学者,也能通过清晰的图示和步骤分解,逐步建立起坚实的认知框架。它更像是一本工具手册,而不是晦涩难懂的学术论文集,随时可以拿起来翻阅一个章节,就能找到解决特定分类数据挑战的有效方法。
评分本书作者是迄今为止屈指可数的几位真正读懂Goodman and Kruskal 1954年发在JASA上的那篇关于分类变量关联度量的非常有价值的开山之作的学者之一。
评分本书作者是迄今为止屈指可数的几位真正读懂Goodman and Kruskal 1954年发在JASA上的那篇关于分类变量关联度量的非常有价值的开山之作的学者之一。
评分本书作者是迄今为止屈指可数的几位真正读懂Goodman and Kruskal 1954年发在JASA上的那篇关于分类变量关联度量的非常有价值的开山之作的学者之一。
评分本书作者是迄今为止屈指可数的几位真正读懂Goodman and Kruskal 1954年发在JASA上的那篇关于分类变量关联度量的非常有价值的开山之作的学者之一。
评分本书作者是迄今为止屈指可数的几位真正读懂Goodman and Kruskal 1954年发在JASA上的那篇关于分类变量关联度量的非常有价值的开山之作的学者之一。
相关图书






本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有