

具体描述
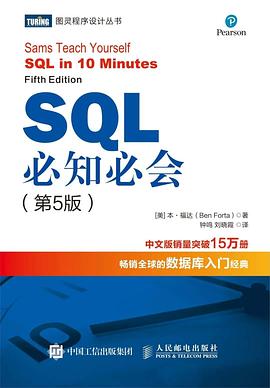
SQL是使用最为广泛的数据库语言,几乎所有重要的DBMS都支持SQL。本书是麻省理工学院、伊利诺伊大学等众多大学的参考教材,由浅入深地讲解了SQL的基本概念和语法,涉及数据的排序、过滤和分组,以及表、视图、联结、子查询、游标、存储过程和触发器等内容,实例丰富,便于查阅。与其他同类图书不同,本书没有过多阐述数据库基础理论,而是专门针对一线软件开发人员,直接从SQL SELECT开始,讲述实际工作环境中最常用和最必需的SQL知识,实用性极强。新版对书中的案例进行了全面的更新,并增加了章后挑战题,便于读者巩固所学知识。
作者简介
本·福达是世界知名的技术作家,在计算机产品开发、支持、培训和营销等方面拥有20多年的丰富经验。曾任Adobe公司开发者关系部总监。多年来,他撰写了SQL、正则表达式、JSP、WAP和Windows开发等方面的十多部技术图书,其中不少是世界畅销书,已被翻译为多种语言在全世界出版发行。
目录信息
1.1 数据库基础 1
1.2 什么是SQL 6
1.3 动手实践 7
1.4 小结 9
第2 课 检索数据 10
2.1 SELECT 语句 10
2.2 检索单个列 11
2.3 检索多个列 13
2.4 检索所有列 14
2.5 检索不同的值 15
2.6 限制结果 17
2.7 使用注释 20
2.8 小结 22
2.9 挑战题 22
第3 课 排序检索数据 23
3.1 排序数据 23
3.2 按多个列排序 25
3.3 按列位置排序 26
3.4 指定排序方向 27
3.5 小结 30
3.6 挑战题 30
第4 课 过滤数据 31
4.1 使用WHERE 子句 31
4.2 WHERE 子句操作符 33
4.3 小结 37
4.4 挑战题 38
第5 课 高级数据过滤 39
5.1 组合WHERE 子句 39
5.2 IN 操作符 43
5.3 NOT 操作符 45
5.4 小结 47
5.5 挑战题 47
第6 课 用通配符进行过滤 49
6.1 LIKE 操作符 49
6.2 使用通配符的技巧 55
6.3 小结 56
6.4 挑战题 56
第7 课 创建计算字段 58
7.1 计算字段 58
7.2 拼接字段 59
7.3 执行算术计算 65
7.4 小结 67
7.5 挑战题 67
第8 课 使用函数处理数据 68
8.1 函数 68
8.2 使用函数 69
8.3 小结 77
8.4 挑战题 77
第9 课 汇总数据 78
9.1 聚集函数 78
9.2 聚集不同值 85
9.3 组合聚集函数 86
9.4 小结 87
9.5 挑战题 88
第10 课 分组数据 89
10.1 数据分组 89
10.2 创建分组 90
10.3 过滤分组 92
10.4 分组和排序 95
10.5 SELECT 子句顺序 97
10.6 小结 97
10.7 挑战题 98
第11 课 使用子查询 99
11.1 子查询 99
11.2 利用子查询进行过滤 99
11.3 作为计算字段使用子查询 103
11.4 小结 106
11.5 挑战题 107
第12 课 联结表 108
12.1 联结 108
12.2 创建联结 111
12.3 小结 118
12.4 挑战题 118
第13 课 创建高级联结 . 120
13.1 使用表别名 120
13.2 使用不同类型的联结 121
13.3 使用带聚集函数的联结 127
13.4 使用联结和联结条件 129
13.5 小结 129
13.6 挑战题 129
第14 课 组合查询 131
14.1 组合查询 131
14.2 创建组合查询 132
14.3 小结 138
14.4 挑战题 139
第15 课 插入数据 140
15.1 数据插入 140
15.2 从一个表复制到另一个表 147
15.3 小结 148
15.4 挑战题 149
第16 课 更新和删除数据 150
16.1 更新数据 150
16.2 删除数据 152
16.3 更新和删除的指导原则 154
16.4 小结 155
16.5 挑战题 156
第17 课 创建和操纵表 157
17.1 创建表 157
17.2 更新表 162
17.3 删除表 165
17.4 重命名表 165
17.5 小结 166
17.6 挑战题 166
第18 课 使用视图 167
18.1 视图 167
18.2 创建视图 170
18.3 小结 177
18.4 挑战题 177
第19 课 使用存储过程 178
19.1 存储过程 178
19.2 为什么要使用存储过程 179
19.3 执行存储过程 181
19.4 创建存储过程 182
19.5 小结 187
第20 课 管理事务处理 . 188
20.1 事务处理 188
20.2 控制事务处理 190
20.3 小结 195
第21 课 使用游标 196
21.1 游标 196
21.2 使用游标 197
21.3 小结 202
第22 课 高级SQL 特性 203
22.1 约束 203
22.2 索引 210
22.3 触发器 212
22.4 数据库安全 214
22.5 小结 215
附录A 样例表脚本 216
附录B SQL 语句的语法 223
附录C SQL 数据类型 228
附录D SQL 保留字 234
常用SQL 语句速查 238
索 引 240
· · · · · · (收起)
读后感
给小白的教程,内容要浅显,这本书做到了,但是还有更加重要的一个特点,就是要讲明白逻辑,便于理解。 新手和老手的一个重要区别,就是老手对熟悉的东西在脑海里自动就会脑补出干什么的,有什么逻辑关系,而新手却总是会问为什么,为什么要这样做,这样做有什么好处? 所以,...
评分看了这本书后最深的感觉就是,有时候薄薄的一本小册子,比很多大砖头实用有效的多 ---- 当然前提是这本书的作者要很清楚自己在写什么。 其实SQL的书可以写的很厚,虽然这本书没有涉及太多的数据库理论知识,特别是范式系列。但是从实用角度来看,书里没有一个字是废话,正如书...
评分------------------------------------------------------------------- -- Sams Teach Yourself SQL in 10 Minutes, 5th Edition -- http://forta.com/books/0135182794/ -- Example table population scripts for Oracle (and Oracle Express) -----------------------------...
评分急我所需啊,正如引言部分所说,没有介绍过多的数据库的内容,一上来就时介绍SQL语句怎么用,还是我现在最想了解的select知识,我只用到查询功能,也只想学习查询,其他的都不care。 准备好了实例数据,直接复制粘贴即可,可以一边看一边实践,这样学习语言才最好。 书中讲解语...
评分名副其实,书中的内容的确是关系型数据库使用者“必须知道必须会”的,如果你连这些都不知道,那就太…… 这本书讲得实在有够浅,只适合彻底的新手和入门者。而对于一个有SQL使用经验的人来说,本书前17章和20、22章的内容你一定了如指掌;如果你对18、 19、21章讲解的视图、存...
用户评价
**评价四:** 这本书的实用性简直令人发指。我一直觉得,学习数据库语言,最怕的就是纸上谈兵。但这本书似乎完全避免了这个问题,它提供的每一个代码示例,我都忍不住在自己的本地环境中敲了一遍。而且,这些示例都不是那种简单到毫无意义的“Hello World”级别,它们往往包含了多表关联、条件聚合以及复杂的数据清洗步骤,完美模拟了真实世界的脏数据处理场景。我特别喜欢它在介绍事务和锁机制时所采用的比喻,那些生动的场景描述,让我这个以前只敢在应用层处理并发问题的家伙,第一次真正理解了数据库层面的并发控制是多么精妙和重要。看完之后,我在设计数据修改脚本时,会下意识地考虑回滚的策略和隔离级别的影响,这种思维上的转变,绝对是这本书带来的最大财富,远超书本本身的定价。
评分**评价三:** 我是在一个非常紧迫的项目需求下接触到这本书的。当时我们需要快速上手一套新的数据库系统,时间压力巨大。这本书的结构设计非常适合这种“战时”学习环境。它的内容组织逻辑性极强,从最基本的SELECT语句开始,层层递进,难度曲线平滑得令人惊叹。我不需要跳过晦涩的章节去寻找我需要的知识点,因为作者很巧妙地将复杂的JOIN类型、窗口函数这些高级主题,融入到了一系列递增难度的实战场景中。读起来就像在玩一个精心设计的闯关游戏,每通过一关,你的能力就自然而然地提升了一截。更重要的是,它对不同数据库方言(比如MySQL和PostgreSQL的细微差别)的处理方式非常到位,这对于跨平台工作的工程师来说简直是福音。它不是让你死记硬背语法,而是让你理解这些语法背后的设计哲学。
评分**评价二:** 坦白说,在我学习SQL的旅程中,我尝试过好几本不同的教材,但大多要么过于理论化,要么就是案例陈旧、脱离实际。直到我发现了这本“秘籍”,才真正体会到什么叫做“少即是多”。它的排版清爽简洁,每一章的切入点都非常精准,直击痛点。我尤其欣赏作者在讲解函数和子查询时的逻辑推导过程,它不是简单地罗列函数的功能,而是构建了一个清晰的思维框架,告诉你“什么时候该用它”以及“为什么这么用效率更高”。对我而言,这本书最大的价值在于它建立了一种“SQL工程师”的思维模式,而不是一个简单的“SQL编写者”。它教会了我如何像数据库引擎那样思考问题,如何用更少的资源完成同样甚至更好的查询目标。对于任何希望从“能用”迈向“精通”的开发者来说,这本书都是一本不可多得的工具书和思维导图。
评分**评价五:** 从一个资深数据分析师的角度来看,这本书的价值在于它极大地拓宽了我处理数据的边界。过去我可能只会依赖于ETL工具或者Python库来清洗数据,但这本书让我重新审视了数据库自身强大的数据操作能力。特别是对于那些涉及到复杂分组(GROUP BY的高级用法)和动态报告生成的部分,作者的讲解细致入微,几乎是手把手地教你如何用纯SQL实现Python中`groupby().agg()`才能做到的效果。这种对数据库原生能力的深度挖掘,极大地提高了我的工作效率,减少了对其他工具的依赖。它不是那种让你成为数据库管理员的书,而是让你成为一个能用SQL搞定绝大多数数据挑战的“全能选手”。这本书的结构清晰,内容紧凑,没有一句废话,对于追求效率和深度的专业人士来说,绝对是案头必备的经典参考资料。
评分**评价一:** 初次翻开这本书,我就被它那种直截了当的风格所吸引。它不像那些动辄掉书袋、故作高深的教科书,而是更像一位经验丰富的同行,手把手教你如何在实际工作中应对各种棘手的SQL问题。我印象最深的是它对基础概念的讲解,比如索引的底层原理和执行计划的分析,这些内容通常被其他书籍一带而过,但这本书却用非常直观的方式将其剖析得淋漓尽致。读完后,我感觉自己对SQL的理解不再停留在“会写查询语句”的层面,而是上升到了“理解数据库如何工作”的高度。尤其是书中关于性能调优的部分,提供的那些小技巧和实战案例,让我回头去优化手头项目的几条慢查询时,效果立竿见影。这本书的价值不在于涵盖了所有冷僻的SQL语法,而在于它精准地抓住了日常开发中最核心、最常用,也是最容易出错的那些关键点,并用一种非常“接地气”的方式将其阐述清楚,让人读起来毫不费力,收获颇丰。
评分简单易懂手头工具书
评分有时候会思考这类书的作用,大部分的工具书都建立了一个框架,如果真的在building中发现了一些新问题很容易让人往书里代入,而几篇blogs(或者doc)基本上能覆盖90%以上的内容。这类书可能等产生一定需求再去读效用最大,与我,我好奇sql92到图灵完备sql的过程,以及sql设计思想和实现原理是什么
评分SQL基础知识,通俗易懂
评分感谢微信阅读。
评分用「每天 10 分钟入门 SQL 」形容这本书再合适不过了,如果对 SQL 已有基本解后了,可能不是很适合,但对于小白用户来说真的很友好。书里的练习都做一次,我相信已经能在日常工作中进行简单的查询运用了。最重要的是,如果对自己有更高要求的话,按照书里的内容,在执行超 10000 条记录的多工作表查询计算时,SQL 真的可以替代 Excel 。
相关图书





本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有