
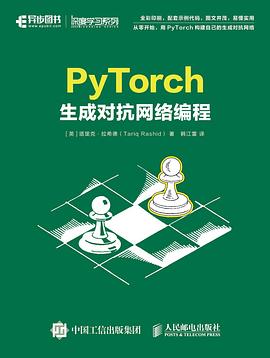

具体描述
畅销书《Python神经网络编程》作者最新力作;
全彩印刷,配套示例代码,图文并茂,易懂实用;
从零开始,用PyTorch构建自己的生成对抗网络。
生成对抗网络(Generative Adversarial Network,GAN)是神经网络领域的一颗新星,被誉为“机器 学习领域近 20 年来最酷的想法”。
本书以直白、简短的方式向读者介绍了生成对抗网络,指导读者如何使用PyTorch 按部就班地编写生成对抗网络。
全书共3章和5个附录,分别介绍了PyTorch基础知识,用PyTorch开发神经网络,改良神经网络以提升效果,引入CUDA和GPU以加速GAN训练,以及生成高质量图像的卷积GAN、条件式GAN等话题。附录部分介绍了在很多机器学习相关教程中被忽略的主题,包括计算平衡GAN的理想损失值、概率分布和采样,以及卷积如何工作,还简单解释了为什么梯度下降不适用于对抗式机器学习。
本书适合想初步了解GAN以及其工作原理的读者,也适合想要学习如何构建GAN的机器学习从业人员。对于正在学习机器学习相关课程的学生,本书可以帮助读者快速入门,为后续的学习打好基础。
作者简介
作者简介:
塔里克·拉希德(Tariq Rashid),拥有物理学学士学位、机器学习和数据挖掘硕士学位。他常年活跃于伦敦的技术圈子,领导并组织伦敦Python聚会小组(近3000名成员)。
译者简介:
韩江雷,新加坡南洋理工大学计算机专业博士,思爱普公司(新加坡)数据科学家。他的研究兴趣有自然语言处理、文本数据分析、数据挖掘等项目的落地及运维。
目录信息
1.1 PyTorch入门 001
1.2 初试PyTorch神经网络 018
1.3 改良方法 043
1.4 CUDA基础知识 054
第 2 章 GAN初步 064
2.1 GAN的概念 064
2.2 生成1010格式规律 072
2.3 生成手写数字 090
2.4 生成人脸图像 117
第 3 章 卷积GAN和条件式GAN 140
3.1 卷积GAN 140
3.2 条件式GAN 166
3.3 结语 176
附录A 理想的损失值 178
A.1 MSE损失 178
A.2 BCE损失 179
附录B GAN学习可能性 186
B.1 GAN不会记忆训练数据 186
B.2 简单的例子 187
B.3 从一个概率分布中生成图像 188
B.4 为图像特征学习像素组合 189
B.5 多模式以及模式崩溃 190
附录C 卷积案例 191
C.1 例1: 卷积,步长为1,无补全 191
C.2 例2: 卷积,步长为2,无补全 192
C.3 例3: 卷积,步长为2,有补全 193
C.4 例4: 卷积,不完全覆盖 194
C.5 例5: 转置卷积,步长为2,无补全 194
C.6 例6: 转置卷积,步长为1,无补全 196
C.7 例7: 转置卷积,步长为2,有补全 197
C.8 计算输出大小 197
附录D 不稳定学习 199
D.1 梯度下降是否适用于训练GAN 199
D.2 简单的对抗案例 199
D.3 梯度下降并不适合对抗博弈 203
D.4 为什么是圆形轨迹 204
附录E 相关数据集和软件 205
E.1 MNIST数据集 205
E.2 CelebA数据集 205
E.3 英伟达和谷歌 206
E.4 开源软件 206
· · · · · · (收起)
读后感
跟着作者的make your own neural network而来,在美亚上找到作者的新作。看豆瓣还没有,就给搬了过来。希望更多的人读到。目前读到第56页,跟着代码一步步走来。self.optimiser = torch.optim.Adam(self.parameters()) Rashid, Tariq. Make Your First GAN With PyTorch (p. 56...
评分跟着作者的make your own neural network而来,在美亚上找到作者的新作。看豆瓣还没有,就给搬了过来。希望更多的人读到。目前读到第56页,跟着代码一步步走来。self.optimiser = torch.optim.Adam(self.parameters()) Rashid, Tariq. Make Your First GAN With PyTorch (p. 56...
评分跟着作者的make your own neural network而来,在美亚上找到作者的新作。看豆瓣还没有,就给搬了过来。希望更多的人读到。目前读到第56页,跟着代码一步步走来。self.optimiser = torch.optim.Adam(self.parameters()) Rashid, Tariq. Make Your First GAN With PyTorch (p. 56...
评分跟着作者的make your own neural network而来,在美亚上找到作者的新作。看豆瓣还没有,就给搬了过来。希望更多的人读到。目前读到第56页,跟着代码一步步走来。self.optimiser = torch.optim.Adam(self.parameters()) Rashid, Tariq. Make Your First GAN With PyTorch (p. 56...
评分跟着作者的make your own neural network而来,在美亚上找到作者的新作。看豆瓣还没有,就给搬了过来。希望更多的人读到。目前读到第56页,跟着代码一步步走来。self.optimiser = torch.optim.Adam(self.parameters()) Rashid, Tariq. Make Your First GAN With PyTorch (p. 56...
用户评价
我花了相当一段时间研究了书中关于模型结构优化的那几个章节,发现作者在阐述复杂概念时,所采用的类比和比喻非常巧妙,使得那些原本晦涩难懂的数学原理和网络拓扑图,瞬间变得具象化和易于理解。例如,在解释梯度消失问题时,作者引用了一个现实生活中的“信息传递链”的比喻,让初学者也能迅速抓住问题的核心所在,而不是被公式推导绕晕。这种叙述方式,显然是建立在对目标读者群深刻洞察的基础之上的。它不仅仅是知识的堆砌,更像是一次耐心的、循序渐进的引导。我尤其欣赏作者在引入新概念之前,总是会先回顾前置知识点,构建起一个坚实的知识脚手架,确保读者不会因为知识断层而感到迷茫。这种教学设计的匠心独运,使得本书在众多理论性较强的著作中脱颖而出,真正做到了“深入浅出”。
评分令人印象深刻的是,本书对“模型评估与调优”这个环节给予了极大的篇幅和细致的关注,这往往是其他同类书籍容易一带而过的地方。作者没有将重点仅仅放在如何搭建网络上,而是花了很多笔墨讲解了如何科学地解读评估指标,以及如何系统性地进行超参数搜索。特别是关于防止过拟合和欠拟合的诊断流程图,逻辑清晰,步骤明确,直接可以作为工作中的参考手册来使用。更妙的是,书中还穿插了一些关于“模型可解释性”的讨论,尽管篇幅不长,但提出了很多值得深思的问题,提醒我们在追求高性能的同时,也不能忽视模型决策过程的透明度。这种全局观的培养,体现了作者深厚的专业素养和对行业发展趋势的深刻把握,让这本书的价值远超一本单纯的技术操作指南,更像是一份全面的、面向未来的“实战思维指南”。
评分从实战操作的角度来看,本书的案例设计极具前瞻性和实用价值。书中提供的项目代码不仅是教科书式的标准模板,更融入了大量工业界常用的技巧和陷阱规避方法。比如,关于数据增强策略的选择,作者没有停留在理论层面,而是通过对比不同增强方法在特定数据集上的性能变化,直观地展示了“选择比努力更重要”的实践真理。此外,书中对环境配置和依赖管理的部分也处理得非常细致,提供了详尽的步骤说明和可能遇到的错误排查指南,这对于经常在配置环境上浪费大量时间的开发者来说,无疑节省了宝贵的调试时间。我个人认为,一本好的技术书必须是“能跑起来”的书,而本书在这方面做得非常出色,每一个示例都经过了严格的验证,保证了读者的学习曲线的平滑过渡,从理论走向实践的阻力被降到了最低。
评分这本书的行文风格非常独特,它既有严谨的学术论证的底色,又不失一种充满激情的探索精神。作者在描述研究历程和遇到的挑战时,展现出了一种近乎“工程师日记”的真诚感,让人感觉不是在阅读一本冰冷的教材,而是在与一位经验丰富的同行进行深度交流。这种文风有效地消解了技术学习中常常伴随的枯燥感。特别是在讨论到一些前沿优化算法的局限性时,作者敢于提出质疑,并引导读者思考更深层次的改进方向,而不是盲目推崇某种“万能药”。这种鼓励批判性思维的引导方式,让我受益匪浅,它促使我不再满足于代码的运行结果,而是更深层次地去理解其背后的设计哲学和局限边界,极大地拓宽了我对该领域认知的深度和广度。
评分这本书的排版和印刷质量实在让人惊喜,拿到手的时候就感觉沉甸甸的,很有分量。装帧设计简洁大气,封面上的插图虽然抽象,但隐约能感觉到一种技术与艺术结合的美感。内页纸张选用得很好,触感细腻,即使用力去翻阅也不会有廉价感。更值得称赞的是,书中的代码示例部分,字体清晰,间距适中,注释详尽且格式统一,这对于需要长时间盯着代码学习的读者来说,简直是福音。很多技术书籍在排版上都显得粗糙随意,但这本书明显看得出编辑团队在细节上的用心。尤其是章节标题和图表的编号系统,逻辑性极强,让人在快速定位信息时能事无虚度。这种对物理载体品质的重视,无疑提升了整体的阅读体验,让人更愿意沉下心来,慢慢品味书中的每一个知识点。对于我这种偏爱实体书的读者来说,一本制作精良的书籍本身就是一种享受,它让学习过程多了一份仪式感和舒适度,极大地增强了阅读的持久性。
评分只能用屌炸天来形容!!!
评分写的很好,深入浅出。GAN的核心思想,共分3步,第一,向鉴别器展示一个真实的样本,并告诉它分类为真;第二,向鉴别器展示一个生成器的输出,并告诉它分类为假;第三,向鉴别器展示一个生成器的输出,并告诉【生成器】分类为真(让生成器优化生成权重,以生成更好的图片)
评分写的很好,深入浅出。GAN的核心思想,共分3步,第一,向鉴别器展示一个真实的样本,并告诉它分类为真;第二,向鉴别器展示一个生成器的输出,并告诉它分类为假;第三,向鉴别器展示一个生成器的输出,并告诉【生成器】分类为真(让生成器优化生成权重,以生成更好的图片)
评分由浅入深逐步引导,非常适合入门
评分刚开始翻看的时候觉得内容很少,感觉会很水。但是读完之后,里面的基础讲的很有味道,也令人深思。对GAN问题和提出的一些想法剖析的很不错,原因讲的很清楚。
相关图书



本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有