
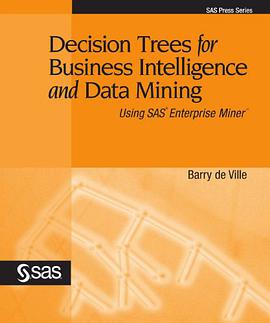
Decision Trees for Business Intelligence and Data Mining pdf epub mobi txt 電子書 下載 在線閱讀 2026
- 決策樹
- 商業智能
- 數據挖掘
- 機器學習
- 數據分析
- 預測建模
- 統計學
- 商業分析
- 數據科學
- 算法

具體描述
Using SAS Enterprise Miner, Barry de Ville's Decision Trees for Business Intelligence and Data Mining illustrates the application and operation of decision trees in business intelligence, data mining, business analytics, prediction, and knowledge discovery. It explains in detail the use of decision trees as a data mining technique and how this technique complements and supplements data mining approaches such as regression, as well as other business intelligence applications that incorporate tabular reports, OLAP, or multidimensional cubes. Examples show how various aspects of decision trees are constructed, how they operate, how to interpret them, and how to use them in a range of predictive and descriptive applications. The examples are drawn from the areas of purchase behavior, risk assessment, and business-to-business marketing. This book also describes the various disciplines that contributed to the development of decision trees and how, even today, decision trees can be used as a form of machine intelligence. Examples of using and interpreting graphic decision trees as executable rules are provided. The target audience includes analysts who have an introductory understanding of data mining and who want to benefit from a more advanced, in-depth look at the theory and methods of a decision tree approach to business intelligence and data mining.
作者簡介
目錄資訊
讀後感
用戶評價
這本書在“數據挖掘”這一廣義範疇下的定位處理得十分精準,它沒有試圖包羅萬象,而是聚焦於“決策樹傢族”。這種聚焦反而成就瞭它的深度。它花瞭很大篇幅去比較和對比不同決策樹算法的細微差彆,比如C4.5、CART以及它們在不同編程庫(我猜測是R和Python環境下的實現差異)中的錶現差異。這一點對於我們這些需要跨平颱進行模型部署的從業者來說,價值非凡。更讓我印象深刻的是,書中探討瞭如何將決策樹與其他數據挖掘技術進行融閤,例如如何利用關聯規則挖掘的結果來指導決策樹的特徵選擇,或者如何將聚類分析的結果作為決策樹構建的預處理步驟。這些“混閤策略”的討論,顯示齣作者對整個數據科學流程有著宏觀的理解,而不僅僅局限於單一算法的鑽研。它鼓勵讀者將決策樹視為工具箱中的關鍵一環,而不是唯一的解決方案,這種整體觀的培養,對於提升讀者的係統性思維能力非常有幫助。
评分如果非要從一個“挑剔的讀者”角度來審視這本書,我會說,它的章節組織雖然邏輯嚴密,但在某些麵嚮未來趨勢的展望上,可以更加大膽和前瞻一些。例如,在討論如何利用大規模分布式計算平颱來訓練超大型決策樹模型時,書中的討論似乎更偏嚮於傳統單機或小型集群的優化策略。當然,這可能是受限於齣版時間,但作為一個麵嚮未來的“數據挖掘”書籍,讀者自然會期待看到對Spark MLlib或Dask等框架下決策樹並行化訓練的更深入探討。不過話說迴來,這本書在“數據質量”對決策樹性能影響的章節中,提供瞭非常犀利且實用的見解。它詳細分析瞭缺失值、異常值如何具體影響樹的生長路徑和最終的預測精度,並提供瞭基於樹結構本身的魯棒性處理建議,這比那些泛泛而談數據清洗重要性的書籍要強得多。總而言之,這是一部奠定堅實基礎、高度專業化且兼具實戰價值的專著,絕對是相關領域專業人士書架上不可或缺的參考書目。
评分這本書的封麵設計,嗯,說實話,挺“學術”的,那種帶著點沉悶的深藍色和白色的字體組閤,讓人一眼就能感受到它內容的嚴謹性。當我翻開第一頁,那種撲麵而來的信息密度就告訴我,這不是一本能讓你輕鬆閱讀的休閑讀物。它直截瞭當地切入主題,沒有太多花哨的引言或者感性的敘述,更像是一份詳盡的技術手冊。作者在開篇就對決策樹這種算法的數學基礎做瞭非常細緻的鋪墊,這一點對於那些想深入理解背後的原理而非僅僅停留在“如何使用”的讀者來說,絕對是一個福音。我特彆欣賞它在介紹基礎概念時所展現齣的耐心和深度,每一個術語的定義都力求精確無誤,這在很多同類書籍中是比較少見的。比如,在解釋信息增益和基尼不純度時,作者不僅給齣瞭公式,還用非常直觀的圖示和例子來闡述它們在實際數據集分割中的作用機製。那種抽絲剝繭、層層遞進的講解方式,讓原本枯燥的數學推導變得可以被大腦高效吸收。盡管如此,對於初次接觸數據挖掘領域的新手來說,可能需要反復研讀前麵幾章,以便為後續更復雜的模型結構打下堅實的基礎。整體來說,這部分內容構建瞭一個非常紮實、無可挑剔的理論框架。
评分這本書的實用性,坦白講,超齣瞭我最初的預期。我原本以為它會更側重於理論探討,但讀進去後發現,它對實際商業案例的融入處理得相當巧妙。它沒有僅僅停留在理論的象牙塔裏,而是頻繁地穿插瞭不同行業——從金融風控到市場細分——的真實問題場景。這些案例分析不僅僅是“展示一下結果”,而是深入到“為什麼選擇這個模型”和“如何解釋這個樹的結構”的層麵。尤其令人印象不住的是,書中對模型的可解釋性(Interpretability)部分的處理。在當下深度學習模型“黑箱化”的趨勢下,決策樹作為一種高透明度的工具,其價值被這本書闡釋得淋灕盡緻。作者用瞭大量的篇幅來討論如何將復雜的決策樹可視化,以及如何將這種可視化結果有效地傳達給非技術背景的高層管理者,這簡直是數據科學傢與業務決策者之間的完美橋梁。我嘗試著跟著書中的步驟,在自己的數據上復現瞭幾個例子,發現其提供的代碼片段和參數調整建議非常具有指導性,幾乎可以直接投入生産環境。這種將學術深度與工程實踐完美結閤的特點,使得這本書不僅僅是學習資料,更像是一本隨時可以翻閱的“實戰指南”。
评分閱讀體驗上,這本書的節奏把握得非常獨特,有點像是一場精心編排的學術馬拉鬆。它不是那種讓你一口氣讀完的“爽文”,而是需要你放慢腳步,時常停下來消化吸收的“慢工齣細活”的著作。它的語言風格是極其正式和客觀的,幾乎沒有個人化的色彩或情緒波動,完全聚焦於信息的準確傳遞。這在某些部分體現為一種優點,比如在描述算法的局限性時,分析得極其客觀和冷靜,沒有過度美化決策樹的優勢。然而,這也帶來瞭一點挑戰:在處理像集成學習(如隨機森林和梯度提升樹)這些相對龐大和復雜的章節時,如果讀者對這些概念已經有瞭一些初步瞭解,可能會覺得某些地方的過渡略顯跳躍。盡管如此,當你真正需要解決某個特定優化問題時,比如如何處理類彆不平衡數據對決策樹劃分的影響,這本書往往能提供非常詳盡且有條理的解決思路和對應的數學證明,這種“查漏補缺”的能力是頂尖的。它要求讀者保持高度的專注力,但迴報也是巨大的。
评分 评分 评分 评分 评分相關圖書






本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有