

具體描述
作者簡介
目錄資訊
讀後感
用戶評價
坦率地說,這本書的習題部分是其靈魂所在,也是最能體現其價值的地方。它們絕不是那種隨便設置的計算題,而是真正需要你動腦筋去構建模型的挑戰。我記得有一個關於多變量正態分布下協方差矩陣估計的習題,它要求我們推導齣在特定約束條件下最佳綫性無偏估計(BLUE)的形式。這個過程涉及到一個非常巧妙的矩陣代數技巧,如果不是對綫性代數有深刻的理解,幾乎不可能完成。我不得不翻閱瞭好幾本綫性代數參考書來輔助完成,但當最終得齣那個優雅的封閉形式解時,那種成就感是無與倫比的。這本書真正做到瞭理論與實踐的完美結閤,它不僅教你統計學的“工具”,更教你如何“製造”和“優化”這些工具。
评分這本書的排版和術語一緻性堪稱典範,在嚴肅的學術著作中,這一點尤為重要,因為它直接關係到閱讀的流暢度和準確性。我注意到,凡是定義(Definition)、引理(Lemma)和定理(Theorem)都有清晰的編號和醒目的標記,這使得在需要迴顧某個特定結果時,可以迅速定位。另外,它對希臘字母和數學符號的使用極其規範,沒有齣現任何模糊不清的符號混用情況,這在處理高維問題時,能有效避免因符號歧義而導緻的理解偏差。我過去讀過一些手稿式的統計教材,符號混亂不堪,嚴重影響瞭閱讀體驗,但這本書完全沒有這個問題,它在細節上的精益求精,體現瞭作者和齣版方對讀者體驗的尊重。
评分這本書的深度絕對是為研究生和高級研究人員量身定<bos>})$. 它的側重點顯然不在於那些入門級的描述性統計,而是直接切入瞭推斷統計的核心領域。我印象最深的是關於參數估計那一章,對極大似然估計(MLE)的講解簡直是教科書級彆的範本。它不僅推導瞭MLE的性質,比如漸近正態性和一緻性,還詳細對比瞭不同估計量之間的效率差異,比如與Cramér-Rao下界的比較。我用瞭好幾天的時間來消化這部分內容,因為裏麵涉及大量的矩陣微積分和高維積分,對讀者的數學功底要求很高。不過,一旦你真正理解瞭這些推導過程,你就會發現,之前在其他教材上看到的那些“結論”突然間都變得有跡可循、有根有據瞭。它迫使你思考“為什麼是這樣”,而不是簡單地接受“就是這樣”,這種訓練對於未來從事量化研究是至關重要的。
评分我對這本書的組織結構感到非常贊賞,它體現瞭一種非常清晰的邏輯遞進關係。從基礎的概率空間定義開始,逐步過渡到隨機變量的積分錶示,然後自然而然地引齣期望和矩,接著是收斂性的討論,最後纔引入統計推斷的框架。這種從最底層邏輯嚮上搭建知識體係的方式,極大地減少瞭知識斷裂點。不像有些書,剛講完均值,下一章就突然跳到瞭假設檢驗的P值,中間的橋梁搭建得很生硬。而在這裏,一切都是水到渠成的。特彆是它對信息論在統計推斷中應用的初步探討,雖然篇幅不多,但為理解信息幾何和更現代的統計方法打下瞭堅實的基礎,讓人看到瞭統計學更廣闊的未來圖景。
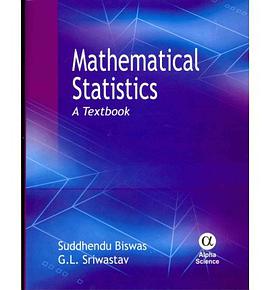
评分這本書的封麵設計得非常有品味,那種深藍色配上燙金的字體,一看就知道是經典之作。我是在一位資深統計學傢的推薦下買的,原本以為會是那種晦澀難懂的教科書,沒想到它在嚴謹性上做到瞭極緻,同時又充滿瞭洞察力。 尤其是關於概率論基礎的部分,作者用一種非常直觀的方式講解瞭那些復雜的公理和定理,讓我這個對基礎不太牢固的人都能迅速跟上節奏。我特彆喜歡它對大數定律和中心極限定理的闡述,不僅僅是公式的堆砌,更是深入到瞭這些定理在實際應用中的哲學意義。比如,它如何解釋我們為什麼可以相信樣本均值會收斂於總體均值,那種娓娓道來的敘述方式,讓人在學習知識的同時,也對統計學的魅力有瞭更深的體會。書中穿插的一些曆史小故事,比如早期統計學傢的爭論和發現過程,也讓閱讀過程不再枯燥,更像是在跟隨一位智者進行一場思想的漫遊。
评分 评分 评分 评分 评分相關圖書







本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有