
Classifiers pdf epub mobi txt 电子书 下载 在线阅读 2026
- 量词
- 语言学
- 語言學
- linguistics
- 机器学习
- 分类算法
- 数据挖掘
- 模式识别
- 人工智能
- 统计学习
- 预测模型
- 算法
- 数据分析
- Python

具体描述
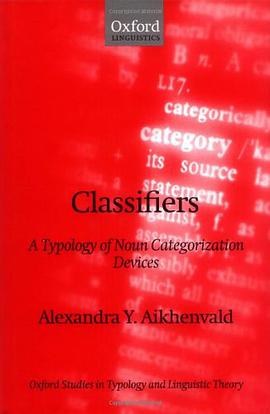
Almost all languages have some grammatical means for the linguistic categorization of nouns. Well-known systems such as the lexical numeral classifiers of South-East Asia, on the one hand, and the highly grammaticalized gender agreement classes of Indo-European languages, on the other, are the extremes of a contiuum. They can have a similar semantic basis, and one can develop from the other. Classifiers come in different morphological forms; they can be free nouns, clitics, or affixes. Some languages combine several varieties of classifiers. Different types of classifiers show varying correlations with other grammatical categories. In addition, they differ in their semantics, in the way they develop, and in the way they become obsolescent and disappear. These parameters are the basis for the typology of classifiers presented here. This book is almost certainly the most substantial cross-linguistic account of classifiers ever published. Its range of exemplification includes major and minor languages from every continent (several from the author's own fieldwork).The work combines original research with innovative analysis and will interest typologists, those working in the field of morphosyntactic variation and lexical semantics, and exponents of formal theories who wish to explain the range of linguistic diversity found in natural language.
作者简介
目录信息
读后感
用户评价
这本《Classifiers》简直是为我这种对数据科学和机器学习领域心怀好奇却又常常感到迷茫的初学者量身定做的“导航图”。我刚接触这个领域的时候,各种术语和算法像迷雾一样笼罩着我,什么逻辑回归、支持向量机、决策树,听起来都像是一门高深的学问,让人望而却步。然而,这本书的叙事方式极其亲切自然,它没有一上来就抛出那些复杂的数学公式,而是从最基础的“分类”这个概念入手,用我们日常生活中遇到的实际例子来逐步引入核心思想。比如,它会用区分猫和狗的图片,或者判断一封邮件是垃圾邮件还是正常邮件的场景,将抽象的算法具象化。我特别欣赏作者在解释每一个分类器原理时所采用的类比手法,生动形象,一下子就抓住了关键。读完关于线性分类器的章节,我不再只是死记硬背定义,而是真正理解了“找到最佳决策边界”的含义。那种豁然开朗的感觉,就像在黑暗中摸索了许久,终于被一束光照亮。这本书的结构安排也十分合理,从基础到进阶,层层递进,每完成一章,都能感觉到自己对整个分类体系的认知又向前迈进了一大步。它让我明白,理解背后的逻辑比单纯地调用库函数重要得多。
评分这本书的排版和设计风格,给我的感觉是既专业又富有现代气息,这一点非常难得。很多技术书籍为了追求内容的密度,往往牺牲了阅读的舒适度,导致大段文字堆砌,密密麻麻,让人望而生畏。《Classifiers》在这方面做得非常出色。它的字体选择清晰易读,段落之间的留白恰到好处,更重要的是,那些关键的数学公式和算法流程图,都被精心设计和放置在了最合适的位置。我尤其喜欢它在解释复杂算法时所使用的那些流程图,简洁明了,一下子就把复杂的步骤梳理得井井有条,避免了读者在冗长的文字描述中迷失方向。对于一个视觉学习者来说,这种清晰的结构化呈现方式是学习效率的倍增器。此外,作者在关键概念的强调上也把握得很好,使用了不同的字体或颜色块来突出那些需要特别注意的陷阱或常见误区,这简直是“过来人”的经验总结。我甚至会把它当作一本工具书来翻阅,因为清晰的布局使得查找特定算法的介绍或特定参数的解释变得异常快捷,省去了我过去翻阅旧笔记时那种费时费力的过程。
评分这本书带给我的最大启发是关于“模型选择”的哲学思考。在机器学习项目中,很多初级从业者往往陷于对最新、最复杂模型的盲目追求,认为模型越深、参数越多,效果就一定越好。《Classifiers》通过一系列对比实验和案例分析,有力地论证了“奥卡姆剃刀”原则在分类问题中的重要性。书中反复强调,首先应该从最简单、可解释性最强的模型开始尝试,只有在简单模型达到性能瓶颈时,才需要引入更复杂的机制,例如深度学习模型。作者通过对不同数据集规模和特征维度下,朴素贝叶斯、逻辑回归和随机森林性能的对比,清晰地展示了这种成本效益分析的重要性。这不仅仅是算法层面的讨论,更是一种项目管理和资源分配的智慧体现。它教会了我如何根据业务约束(如计算资源、解释需求、维护成本)来选择最恰当的工具,而不是被技术本身牵着鼻子走。这本书,与其说是一本算法手册,不如说是一本指导我们在复杂技术世界中做出明智决策的指南。
评分我是一名有着多年开发经验的资深工程师,这次翻阅《Classifiers》,主要是想系统性地梳理一下自己脑海中那些零散的分类模型知识点,并期待能找到一些能优化现有生产系统性能的“黑科技”。坦白说,市面上讲解分类算法的书籍大多偏重理论推导或工程实现二选一,鲜有能将两者平衡得如此优雅的。这本书的深度远超我的预期,尤其是在讨论集成学习方法,比如Bagging和Boosting的细节处理上,作者没有停留在表面,而是深入剖析了它们在处理偏差(Bias)和方差(Variance)时的微妙权衡。比如,书中关于梯度提升机(Gradient Boosting Machines)在处理异常值敏感性时的优化策略,以及如何通过正则化手段来控制模型复杂度,这些内容对于我这种追求极致性能的实践者来说,提供了非常宝贵的参考价值。作者在引证现代研究成果时,标注得非常清晰,使得读者在对某一特定算法产生浓厚兴趣后,能够迅速追溯到更前沿的研究论文。它不是一本满足于“告诉你怎么做”的书,而是在引导你“思考为什么”。阅读过程中,我时不时地会停下来,对着书中的图表和伪代码进行思考和复现,这种主动的参与感,让学习过程变得极其充实和高效。
评分说实话,我是一个非常注重批判性思维培养的学习者,我对那种只罗列事实而不探讨局限性的书籍持保留态度。《Classifiers》最让我赞叹的一点,就是它极其坦诚地讨论了每种分类方法固有的“阿喀琉斯之踵”。它不会神化任何一个算法,而是客观地剖析了它们的适用边界。例如,在详细介绍神经网络分类器时,作者并没有回避它们对大规模标注数据的依赖性、训练过程中的黑箱特性,以及梯度消失/爆炸问题的潜在风险。更进一步,它没有止步于指出问题,而是立刻跟进介绍了当前社区正在探索的解决方案,比如迁移学习的应用、注意力机制的引入等等。这种“指出问题—分析根源—提供前沿对策”的结构,让阅读体验非常扎实和可靠。读完这本书,我感觉自己建立起来的知识体系是完整的,而不是只有光鲜亮丽的成功案例,却没有应对失败和挑战的准备。它培养了一种健康的怀疑精神,让我明白在实际应用中,永远没有“万能钥匙”式的分类器存在。
评分近年来比较有总结性质的关于classifier的类型学研究,写得简洁明了,资料也丰富
评分近年来比较有总结性质的关于classifier的类型学研究,写得简洁明了,资料也丰富
评分近年来比较有总结性质的关于classifier的类型学研究,写得简洁明了,资料也丰富
评分论文用
评分论文用
相关图书








本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有