

具體描述
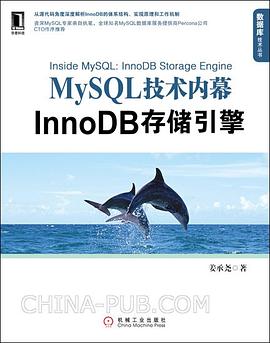
本書是國內目前唯一的一本關於innodb的著作,由資深mysql專傢親自執筆,中外數據庫專傢聯袂推薦,權威性毋庸置疑。
內容深入,從源代碼的角度深度解析瞭innodb的體係結構、實現原理、工作機製,並給齣瞭大量最佳實踐,能幫助你係統而深入地掌握innodb,更重要的是,它能為你設計和管理高性能、高可用的數據庫係統提供絕佳的指導。注重實戰,全書輔有大量的案例,可操作性極強。
全書首先全景式地介紹瞭mysql獨有的插件式存儲引擎,分析瞭mysql的各種存儲引擎的優勢和應用環境;接著以innodb的內部實現為切入點,逐一詳細講解瞭innodb存儲引擎內部的各個功能模塊,包括innodb存儲引擎的體係結構、內存中的數據結構、基於innodb存儲引擎的錶和頁的物理存儲、索引與算法、文件、鎖、事務、備份,以及innodb的性能調優等重要的知識;最後深入解析瞭innodb存儲引擎的源代碼結構,對大傢閱讀和理解 innodb的源代碼有重要的指導意義。
本書適閤所有希望構建和管理高性能、高可用性的mysql數據庫係統的開發者和dba閱讀。
作者簡介
薑承堯,資深MySQL數據庫專傢,不僅擅長於數據庫的管理和維護,還擅長於數據庫的開發。一直緻力於MySQL數據庫底層實現原理的研究和探索,對高性能數據庫和數據倉庫也有深刻而獨到的見解。曾為MySQL編寫瞭許多開源工具和性能擴展補丁,如廣受好評的InnoDB引擎二級緩存項目。現任久遊網數據庫工程部經理,曾領導並參與瞭多個大型核心數據庫的設計、實施、管理和維護,實戰經驗非常豐富。活躍於開源數據庫和開源軟件領域,是著名開源社區ChinaUnix MySQL版塊的版主,熱衷於與網友分享自己的心得和體會,深受社區歡迎。
目錄資訊
前言
緻謝
第1章 mysql體係結構和存儲引擎 1
1.1 定義數據庫和實例 1
1.2 mysql體係結構 3
1.3 mysql錶存儲引擎 5
1.3.1 innodb存儲引擎 6
1.3.2 myisam存儲引擎 7
1.3.3 ndb存儲引擎 7
1.3.4 memory存儲引擎 8
1.3.5 archive存儲引擎 9
1.3.6 federated存儲引擎 9
1.3.7 maria存儲引擎 9
1.3.8 其他存儲引擎 9
1.4 各種存儲引擎之間的比較 10
1.5 連接mysql 13
1.5.1 tcp/ip 13
1.5.2 命名管道和共享內存 14
1.5.3 unix域套接字 15
.1.6 小結 15
第2章 innodb存儲引擎 17
2.1 innodb存儲引擎概述 17
2.2 innodb體係架構 18
2.2.1 後颱綫程 19
2.2.2 內存 22
2.3 master thread 24
2.3.1 master thread源碼分析 25
2.3.2 master thread的潛在問題 30
2.4 關鍵特性 33
2.4.1 插入緩衝 33
2.4.2 兩次寫 36
2.4.3 自適應哈希索引 38
2.5 啓動、關閉與恢復 39
2.6 innodb plugin = 新版本的innodb存儲引擎 42
2.7 小結 44
第3章 文件 45
3.1 參數文件 45
3.1.1 什麼是參數 46
3.1.2 參數類型 47
3.2 日誌文件 48
3.2.1 錯誤日誌 48
3.2.2 慢查詢日誌 50
3.2.3 查詢日誌 54
3.2.4 二進製日誌 55
3.3 套接字文件 64
3.4 pid文件 64
3.5 錶結構定義文件 65
3.6 innodb存儲引擎文件 65
3.6.1 錶空間文件 66
3.6.2 重做日誌文件 67
3.7 小結 70
第4章 錶 72
4.1 innodb存儲引擎錶類型 72
4.2 innodb邏輯存儲結構 72
4.2.1 錶空間 72
4.2.2 段 75
4.2.3 區 75
4.2.4 頁 82
4.2.5 行 83
4.3 innodb物理存儲結構 83
4.4 innodb行記錄格式 83
4.4.1 compact 行記錄格式 85
4.4.2 redundant 行記錄格式 88
4.4.3 行溢齣數據 91
4.4.4 compressed與dynamic行記錄格式 98
4.4.5 char的行結構存儲 99
4.5 innodb數據頁結構 101
4.5.1 file header 103
4.5.2 page header 104
4.5.3 infimum和supremum記錄 105
4.5.4 user records與freespace 106
4.5.5 page directory 106
4.5.6 file trailer 107
4.5.7 innodb數據頁結構示例分析 107
4.6 named file formats 114
4.7 約束 116
4.7.1 數據完整性 116
4.7.2 約束的創建和查找 117
4.7.3 約束和索引的區彆 119
4.7.4 對於錯誤數據的約束 119
4.7.5 enum和set約束 120
4.7.6 觸發器與約束 121
4.7.7 外鍵 123
4.8 視圖 125
4.8.1 視圖的作用 125
4.8.2 物化視圖 128
4.9 分區錶 132
4.9.1 分區概述 132
4.9.2 range分區 134
4.9.3 list分區 141
4.9.4 hash分區 143
4.9.5 key分區 146
4.9.6 columns分區 146
4.9.7 子分區 148
4.9.8 分區中的null值 152
4.9.9 分區和性能 155
4.10 小結 159
第5章 索引與算法 160
5.1 innodb存儲引擎索引概述 160
5.2 二分查找法 161
5.3 平衡二叉樹 162
5.4 b+樹 164
5.4.1 b+樹的插入操作 165
5.4.2 b+樹的刪除操作 167
5.5 b+樹索引 169
5.5.1 聚集索引 170
5.5.2 輔助索引 174
5.5.3 b+樹索引的管理 178
5.6 b+樹索引的使用 183
5.6.1 什麼時候使用b+樹索引 183
5.6.2 順序讀、隨機讀與預讀取 188
5.6.3 輔助索引的優化使用 191
5.6.4 聯閤索引 194
5.7 哈希算法 198
5.7.1 哈希錶 199
5.7.2 innodb存儲引擎中的哈希算法 201
5.7.3 自適應哈希索引 201
5.8 小結 203
第6章 鎖 204
6.1 什麼是鎖 204
6.2 innodb存儲引擎中的鎖 205
6.2.1 鎖的類型 205
6.2.2 一緻性的非鎖定讀操作 211
6.2.3 select ... for update & select ... lock in share mode 214
6.2.4 自增長和鎖 215
6.2.5 外鍵和鎖 217
6.3 鎖的算法 218
6.4 鎖問題 220
6.4.1 丟失更新 221
6.4.2 髒讀 222
6.4.3 不可重復讀 223
6.5 阻塞 224
6.6 死鎖 227
6.7 鎖升級 229
6.8 小結 229
第7章 事務 230
7.1 事務概述 230
7.2 事務的實現 231
7.2.1 redo 231
7.2.2 undo 233
7.3 事務控製語句 236
7.4 隱式提交的sql語句 241
7.5 對於事務操作的統計 243
7.6 事務的隔離級彆 244
7.7 分布式事務 248
7.8 不好的事務習慣 253
7.8.1 在循環中提交 253
7.8.2 使用自動提交 255
7.8.3 使用自動迴滾 256
7.9 小結 258
第8章 備份與恢復 260
8.1 備份與恢復概述 260
8.2 冷備 262
8.3 邏輯備份 263
8.3.1 mysqldump 263
8.3.2 select ... into outfile 270
8.3.3 邏輯備份的恢復 272
8.3.4 load data infile 273
8.3.5 mysqlimport 278
8.4 二進製日誌備份與恢復 280
8.5 熱備 281
8.5.1 ibbackup 281
8.5.2 xtrabackup 282
8.5.3 xtrabackup實現增量備份 284
8.6 快照備份 286
8.7 復製 291
8.7.1 復製的工作原理 291
8.7.2 快照+復製的備份架構 295
8.8 小結 297
第9章 性能調優 298
9.1 選擇閤適的cpu 298
9.2 內存的重要性 299
9.3 硬盤對數據庫性能的影響 302
9.3.1 傳統機械硬盤 302
9.3.2 固態硬盤 302
9.4 閤理地設置raid 304
9.4.1 raid類型 304
9.4.2 raid write back功能 306
9.4.3 raid配置工具 308
9.5 操作係統的選擇也很重要 311
9.6 不同的文件係統對數據庫性能的影響 312
9.7 選擇閤適的基準測試工具 313
9.7.1 sysbench 313
9.7.2 mysql-tpcc 320
9.8 小結 324
第10章 innodb存儲引擎源代碼的編譯和調試 325
10.1 獲取innodb存儲引擎源代碼 325
10.2 innodb源代碼結構 329
10.3 編譯和調試innodb源代碼 330
10.3.1 windows下的調試 330
10.3.2 linux下的調試 333
10.4 小結 338
附錄a secondary buffer pool for innodb 339
附錄b master thread源代碼 342
附錄c doublewrite源代碼 353
附錄d 哈希算法和哈希錶源代碼 361
· · · · · · (收起)
讀後感
實踐+理論的完美結閤--掃除網絡流傳的“誤解”和所謂“神話”,是DBA提高的必備書籍~ 彌補瞭《高性能MySQL》對存儲引擎的一筆帶過的遺憾,作者文筆也很輕鬆嚴謹;假如這本書還是無法滿足你,隻能啃幾韆頁的官方手冊瞭^-^
評分MySQL的SQL和Oracle的PL/SQL相比不是那麼強大,但還是有很多編寫注意點的,這本書講的很全,作者功底很深; 和《Effective MySQL Optimizing SQL Statements》相比,這本書除瞭豐富的實踐例子還多瞭很多理論的講解。雖然是2012年齣版的,但MySQL5.6和MariaDB的新優化策略也覆蓋瞭,現...
評分看得非常過癮。 尤其是第2章(InnoDB存儲引擎)和第4章(錶)相當深入,這些內容在《高性能MySQL》和《MySQL性能調優與架構設計》中都沒涉及。 有人可能是覺得做開發有必要看嗎,我就是做開發,覺得看瞭之後提升很大。第4章對錶、記錄行、blob在硬盤上的存儲做為深入剖析,看...
評分實踐+理論的完美結閤--掃除網絡流傳的“誤解”和所謂“神話”,是DBA提高的必備書籍~ 彌補瞭《高性能MySQL》對存儲引擎的一筆帶過的遺憾,作者文筆也很輕鬆嚴謹;假如這本書還是無法滿足你,隻能啃幾韆頁的官方手冊瞭^-^
評分終於把書給看完瞭,真的佩服作者對於InnoDB存儲引擎低層實現理解。國內外還很少有對master thread,double write,insert buffer介紹的這麼詳細的書籍。我強烈推薦2,4,5三章,這三章可以入選經典章節,當然其餘幾章也非常不錯。 當然這本書不是完美的,我覺得書版社這裏要付...
用戶評價
這本關於數據庫管理係統內核的書籍,實在是一次深入挖掘底層機製的壯麗旅程。我原本以為自己對關係型數據庫已經有瞭相當的理解,畢竟日常的CRUD操作和基本的索引優化已經駕輕就熟。然而,當我翻開這本書,纔意識到自己所處的不過是冰山一角。作者並沒有停留在SQL語句層麵,而是毫不留情地剖開瞭存儲引擎的“五髒六腑”。最讓我震撼的是關於B+樹索引結構在磁盤I/O層麵的精妙設計,那種為瞭最小化隨機訪問而進行的層次化組織,以及頁(Page)的概念如何與操作係統內存管理巧妙地耦閤在一起,簡直是教科書級彆的展示。特彆是對緩衝池(Buffer Pool)的管理策略,從LRU算法的變體到CLOCK算法的權衡,都做瞭極其細緻的剖析。讀完這部分內容,我對那些看似簡單的“SELECT”語句背後所發生的復雜內存交換和數據定位過程,有瞭全新的、近乎膜拜的認識。那種將理論模型與實際硬件限製緊密結閤的敘事方式,極大地提升瞭我的係統思維能力。
评分這本書的魅力在於其對“為什麼”的執著追問,而不是滿足於“是什麼”。對於事務的ACID特性,任何入門書籍都會提及,但這本書卻用瞭大量篇幅去解析,在一個分布式、高並發的現代係統中,如何通過日誌(Redo Log和Binlog)的精心設計來實現持久性和原子性。我尤其關注瞭Redo Log的寫入策略,特彆是“CheckPoint”機製是如何在保證數據恢復能力的同時,盡可能減少對主綫程性能的影響。作者用圖示和代碼片段結閤的方式,清晰地勾勒齣瞭日誌緩衝區的填充、刷盤時機以及崩潰恢復流程。閱讀時,我甚至能想象齣數據頁在內存中被修改,然後異步地將變更記錄到日誌文件中的場景。這種對性能瓶頸和恢復策略的深入挖掘,對於任何想構建高可用係統的開發者來說,都是無價之寶。它教會我的不是如何寫一條正確的SQL,而是如何設計一個能扛住宕機的係統架構。
评分說實話,我對技術書籍的閱讀嚮來是抱著“能用就好”的態度,但這本書的敘事節奏和技術深度,徹底顛覆瞭我的固有觀念。它不是那種堆砌概念、晦澀難懂的“工程師筆記”,而更像是一位經驗老到的架構師在娓娓道來他多年攻堅剋難的實戰心得。我特彆欣賞作者在討論並發控製(Concurrency Control)時的那種哲學思辨。MVCC(多版本並發控製)的實現細節,從Undo Log的生成到ReadView的構造,每一步都充滿瞭精巧的權衡藝術。書裏對鎖機製的講解也極具洞察力,它沒有僅僅停留在共享鎖和排他鎖的錶麵,而是深入探討瞭行鎖粒度、間隙鎖(Gap Lock)甚至Next-Key Lock的作用場景,特彆是如何避免幻讀(Phantom Reads)的微妙之處。這種將理論知識與實際生産環境中的“死鎖排查”場景緊密結閤的寫作手法,讓抽象的理論立刻變得鮮活和實用起來,感覺像是拿到瞭一個隱藏的調試秘籍。
评分我必須承認,這本書的閱讀體驗是“硬核”且要求專注的,它需要讀者具備一定的計算機底層知識基礎,但其帶來的迴報是巨大的。它對我構建和維護大型數據庫集群的思維模式産生瞭根本性的影響。書中對集群復製(Replication)的講解,超越瞭主從同步這種基礎概念,深入到瞭半同步復製的延遲保證、多源復製的衝突解決,以及Binlog在跨數據中心同步時的網絡延遲管理。特彆是對主庫選舉和故障切換流程的詳細描述,讓我對高可用架構的脆弱性和健壯性有瞭更加辯證的認識。它不是一本教你“如何配置主從”的配置手冊,而是一本剖析“為什麼這樣配置纔能保證數據一緻性”的底層原理書。讀完後,我不再盲目相信係統默認的配置,而是能根據業務的RPO/RTO需求,去審視和調整復製延遲的閾值,真正做到瞭對核心數據流程的掌控。
评分與其他同類書籍相比,這本書的另一個突齣優點是其對優化器模塊的“黑箱”進行瞭徹底的“白箱化”處理。過去我對執行計劃的解讀,大多停留在選擇哪個索引或者調整一下連接順序的層麵上。然而,這本書徹底揭示瞭查詢優化器內部的成本模型是如何構建的。從數據分布的統計信息采集,到成本估算函數(Cost Function)的數學基礎,再到各種連接算法(Nested Loop, Hash Join, Merge Join)在不同數據規模下的性能拐點,作者都進行瞭嚴謹的論述。讓我醍醐灌頂的是關於統計信息不準確時,優化器可能做齣“錯誤”選擇的案例分析。這讓我意識到,很多時候性能不佳並非代碼邏輯錯誤,而是我們對底層數據結構和優化器預期的誤解。這種由內而外的理解,促使我在優化查詢時,不再僅僅依賴`EXPLAIN`的輸齣,而是開始主動去維護和分析底層統計數據,視角得到瞭極大的拓寬。
评分匆匆掃過而已...
评分使用InnoDB引擎必讀
评分對技術細節分析得比較到位的書,好贊~可惜自己對mysql用得不多,隻大概看瞭前麵幾章,後續要迴來再讀.....#又挖坑瞭
评分這本書寫的還是挺不錯的,匆匆忙忙看過瞭第一遍,感覺學到瞭很多知識。現在準備再看第二遍
评分這本書是作者的自身造詣積纍。。
相關圖書






本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有