
Ensemble Machine Learning pdf epub mobi txt 电子书 下载 2026
- 机器学习
- MachineLearning
- 集成方法
- Ensemble
- 机器学习
- 集成学习
- 模型融合
- 算法
- 数据挖掘
- 人工智能
- Python
- Scikit-learn
- 统计学习
- 预测建模

具体描述
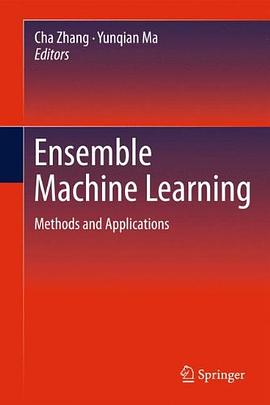
It is common wisdom that gathering a variety of views and inputs improves the process of decision making, and, indeed, underpins a democratic society. Dubbed "ensemble learning" by researchers in computational intelligence and machine learning, it is known to improve a decision system's robustness and accuracy. Now, fresh developments are allowing researchers to unleash the power of ensemble learning in an increasing range of real-world applications. Ensemble learning algorithms such as "boosting" and "random forest" facilitate solutions to key computational issues such as face recognition and are now being applied in areas as diverse as object tracking and bioinformatics. Responding to a shortage of literature dedicated to the topic, this volume offers comprehensive coverage of state-of-the-art ensemble learning techniques, including the random forest skeleton tracking algorithm in the Xbox Kinect sensor, which bypasses the need for game controllers. At once a solid theoretical study and a practical guide, the volume is a windfall for researchers and practitioners alike.
作者简介
目录信息
读后感
用户评价
阅读这本书的过程,与其说是学习,不如说是一场与作者的深度对话。作者的文笔极其严谨,几乎没有使用任何口语化的表达,每一个句子都像是经过了精密的逻辑校准。这种风格的好处是保证了信息的绝对精确性,没有一丝含糊的空间,使得读者可以完全信赖书中所述的每一个论断。但同时,它也带来了一种不易亲近的冷峻感。我感觉自己像是站在一个高耸的学术殿堂前,仰望着那些宏伟的理论结构,却鲜少感受到一种循序渐进的引导。对于初学者来说,书中假定的先验知识门槛设置得过高了,很多地方一笔带过,认为读者应该已经掌握了相关的背景知识。这迫使我不得不频繁地在搜索其他入门级资料来填补知识空缺,这无疑打断了阅读的连贯性。这本书的价值在于它提供了一个知识体系的“顶层蓝图”,但它没有提供“如何爬上去”的脚手架,使得其对广大希望快速入门的群体来说,实用性打了折扣。
评分这本书的封面设计着实抓人眼球,那种深邃的蓝色调配上未来感的银色字体,让人一眼就觉得内容非同小可。我是在一个朋友的推荐下购入的,他信誓旦旦地说,这本书是理解现代数据科学领域那些“黑箱子”工作原理的钥匙。然而,当我沉下心来翻阅前几章时,我发现它更像是一份详尽的理论指南,而不是我期待的那种能快速上手实践的“工具箱”。作者在引言部分就强调了理论基础的重要性,花费了大量篇幅去阐述概率论和统计推断的基石,这对于我这种更偏向应用层面的学习者来说,阅读起来略显吃力。那些关于高维空间投影和损失函数优化的数学推导,如同迷宫一般复杂,我不得不时常停下来,查阅一些更基础的数学参考资料才能勉强跟上思路。可以说,如果你希望在不触及底层数学机制的情况下,只是想学会调用几个库函数来跑模型,这本书可能会让你感到挫败。但反过来说,对于那些渴望彻底弄明白“为什么”的模型构建者,它无疑提供了极其坚实且深入的理论支撑,绝对能让你对算法的内在运作机制有一个脱胎换骨的认识,远超那些浅尝辄止的在线教程。
评分这本书最让我印象深刻的是它对模型解释性和鲁棒性问题的深刻剖析。在很多市面上流行的书籍只忙于追求更高的预测精度时,这本书却花了整整一个部分来探讨“模型为什么会犯错”以及“我们如何才能相信这个模型的结果”。作者没有回避那些令人头疼的、关于模型可信度的灰色地带。他对对抗性攻击的防御策略的探讨,以及如何量化模型决策的不确定性,这些内容在当时市场上是相当前沿和稀缺的。这部分内容,真正体现了作者不仅仅是一个算法的布道者,更是一个审慎的科学思考者。他教导我们,在将模型投入关键决策领域之前,必须先学会如何对其进行“压力测试”。遗憾的是,在讨论这些高级验证方法时,作者更多地停留在了概念层面,缺乏足够多实际案例来展示这些防御机制在真实世界数据集上的具体效果和局限性。如果能附带一些关于如何评估和对比不同解释性方法的实战演练,这本书的指导意义将会更加完善和立体。
评分我对这本书的结构安排感到非常惊喜,它不是那种按照算法名称简单罗列的教科书。作者似乎有意地将不同的模型族群按照它们解决问题的哲学进行了分组,这让我在阅读过程中产生了一种“融会贯通”的感觉。比如,他将那些依赖于决策边界划分的算法放在一起进行对比分析,然后紧接着讨论那些基于迭代优化路径的模型。这种叙事方式使得复杂的概念之间产生了有机的联系,不再是孤立的知识点。我特别欣赏其中关于“偏差-方差权衡”的章节,作者用一个生动的类比,将抽象的数学概念转化为实际的模型选择困境,让我茅塞顿开。不过,书中对某些新兴的深度学习架构的讨论篇幅相对保守,似乎更倾向于经典的机器学习范式,这在当前这个以神经网络驱动的时代,显得有些许滞后。尽管如此,它为我理解那些更底层的、构建现代复杂模型所必需的“积木”打下了不可动摇的基础,让我能更自信地去探索那些前沿的、尚未完全定论的技术领域。
评分老实说,这本书的排版和图示设计是我见过最需要改进的地方之一。虽然内容本身的深度无可挑剔,但视觉体验实在不敢恭维。很多关键的流程图为了塞进A4纸的版面,显得异常拥挤和扁平化,箭头和节点之间的层级关系常常需要反复揣摩才能理清。特别是涉及到多层嵌套的算法流程时,作者似乎偏爱使用纯文本描述而非更直观的流程图来解释,这对于习惯了视觉化学习的我来说,无疑是一个巨大的障碍。我经常需要自己动手,在白板上重新绘制那些图示,才能真正理解算法的每一步逻辑分支。在讨论那些计算复杂度较高的优化算法时,缺乏清晰的伪代码展示也是一个遗憾。如果能配上一些清晰、简洁的编程语言(比如Python或R)的伪代码片段,将能极大地方便读者将其理论知识快速转化为实际可运行的程序框架。这本书更像是为那些拥有强大心智建构能力的学者准备的,对于需要快速验证想法的工程师而言,它需要读者付出额外的“翻译”努力。
评分1 2 5 chapter
评分1 2 5 chapter
评分1 2 5 chapter
评分1 2 5 chapter
评分1 2 5 chapter
相关图书








本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有