
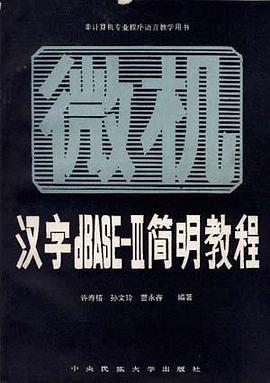

具體描述
作者簡介
目錄資訊
前言
第一章 計算機基本知識介紹
第一節 微電腦的構成
第二節 軟件和硬件
第三節 計算機中數的錶示
一、二進製數
二、進位製的 般說明
三、數製轉換
四、字節 K字節、計算機
字長
第四節 文字信息的錶示
和存貯
一、文字符號的ASCII編碼
二、字符的點陣錶示
第五節 計算機的語言
一、機器語言和程序語言
二、源程序和目標程序
第二章 漢字信息的計算機處理
第一節 一般情況
第二節 漢字信息的錶示
和存貯
一、漢字的代碼錶示
二、漢字字形錶示――漢字
字庫
第三節 漢字的輸齣
第四節 漢字輸入方法綜述
第五節 CCDOS中輸入方式的
控製
第六節 緊縮拼音輸入法
一、一般情況
二、緊縮拼音字母
三、解決同音字的方法
四、實例及操作鍵的具體使用
第七節 首尾碼輸入法
一、一般情況
二、首尾碼舉例
三、首尾首音碼
第三章 dBASE概述
第一節 數據和數據庫
一、數據
二、數據庫
三、關係數據庫
第二節 功能和技術指標
第三節 運行環境或支撐環境
一、dBASE一Ⅱ的支撐環境
二、dBAsE―Ⅲ的支撐環境
第四章 開工方式和若乾簡單操作
第一節 開機步聚
一、冷啓動
二、熱啓動
三、設定係統日期和時間
第二節 進入和退齣dBASE
一、進入dBASE狀態
二、退齣dBASE 狀態
第三節dBASE的基本字符
第四節 用dBASE執行
簡單計算
一、怎樣打dBASE命令
二、計算及顯示命令
三、算術運行符
四、幾個初等函數
五、算術錶達式
第五章 學生統計錶的處理――一個
應用實例
第一節 實際問題和使用要求
第二節 怎樣描述學生統計錶
一、數據庫文件和二維錶
二、文件記錄和二維錶的橫行
三、字段和維錶的竪列
四、數據庫文件的結構
第三節 怎樣說明統計錶錶頭
――建庫命令create
一、學生統計錶5.1的結構
應該怎樣現定
二、用create命令建立庫
文件的結構
三、create命令的結束方式
四、全屏幕編輯
第四平 怎樣輸入數據――
create和append
一、 進入輸入狀態的兩種方式
二、結束輸入的方式
第五節 怎樣顯示已輸入數據
――list和display命令
一、連續列錶命令list
二、間歇顯示意display
第六節 怎樣增刪記錄
――insert、delete和pack命令
一、插入命令insert
二、做刪除標記(delete命令)
和執行刪除(pack命令)
第七節 怎樣修改記錄中的數據
一、編輯命令edit
二、修改部分字段或部分記錄
――change命令
第八節 怎樣計算、填寫平均分
――replace命令
一、 用replace命令計算
並填寫平均分
二、用replace命令做選
擇性修改
第九節 求各科成績全班總分
或全班平均分
一、求各科成績全班總分
――sum命令
二、求各科成績全班總平均分
――average命令
三、對指定數值字段求和
或求平均分
第十節 怎樣統計黨團員人數
或全優人數
――count命令
一、單項統計和簡單條件
二、綜閤統計和復閤條件
第十一節 怎樣排名次
――sort命令和索引
一、按單科成績排名次
二、分組按數學分數排名次
――多重排序
三、物理排序、邏輯排序及
索引
第十二節 統計錶處理的
其它問題
第六章 dBASE――Ⅲ要命令總論
第一節 程序語言的語法規則
和語法公式
一、語言的語法規則
和語法公式
二、命令或語句的結構
三、語法公式中符號
及術語的約定
四、語法公式示例
――list命令的語法
公式及含意
五、命令的若乾書寫規則
第二節dBASE―Ⅲ文件
一、文件和文件的命名
二、文件的類型和類型標記
三、文件的打開和關閉
四、文件目錄的樹型結構
及有關命令
第三節dBASE―Ⅲ數據
一、數據的類型
二、常量、變量、變量的
命名規則
三、算術錶達式
四、字符的運算、函數
和錶達式
五、日期型數據及有關函數
六、作為控製條件的邏輯型
數據
七、數據類型測試及不同
類型數據的轉化
第四節 全屏幕編輯
一、全屏幕編輯及有關命令
二、光標控製及編輯功能鍵
三、編輯結束操作
第七章dBASE―Ⅲ命令各論
――關於數據說明和操作
第一節 本章通例
第二節 數據庫結構的說明
及庫文件的建立
一、庫結構的說明
二、轉入數據輸入狀態
三、用已的數據庫文件
建立新庫的方法
第三節 文件操作命令
一、文件的打開的關閉、
索引文件
二、文件的排序
三、文件的改名和刪除
四、文件或結構的復製、
數據轉移及文件連接
第四節 記錄操作命令
一、記錄的插入
二、記錄的追加
三、記錄的刪除
四、庫文件全部記錄的刪除
第五節 字段操作命令
一、編輯命令
二、修改命令
三、計算與替換命令
四、用另外庫文件數據修改
現用庫文件字段
第六節記錄指針定位和查找
一、文件記錄指針和非條
件式移位
二、指針函數
三、按條件定位一一未索
引時的檢索
四、按條件定位(續)――已
索引時的檢索
第七節 計數及統計命令
一、計數命令
二、求和命令
三、求平均值命令
四、産生分類閤計統計
錶的命令
第八節 信息的顯示和打印
一、信息打印的條件和控製
二、庫文件信息的顯示
和打印
三、庫文件結構的顯示
和打印
四、內存變量信息的顯示
和打印
五、係統狀態信息的打印
和顯示
第九節 標箋格式文件的生成、
編輯和使用
一、標箋格式文件的用途
二、標箋格式文件的建立
和修改
三、怎樣利用標箋格式
文件印製標箋
第十節 報錶格式文件的建立
編輯的使用
一、報錶格式文件的用途
二、報錶格式文件的生成
和修改
三、怎樣利用報錶格式
文件印製報錶
四、實例
五、報錶文件的局限和打印
報錶的其它方法
第十一節 關於備注字段的
有關操作
一、備注字段和備注文件
二、備注字須的輸入和編輯
三、備注文件的打開和編輯
四、備注文件的復製、
改名和刪除
五、備注字段的顯示和打印
第十二節 工作區選擇和
多文件聯用
一、工作區選擇
――select命令
二、用另外工作區上庫
文件數據更新現用
工作區上庫文件數
據――update命令
三、兩個庫文件並置産生一
個新文件――join命令
四、兩個庫文件記錄指針的
關聯定位――relation
的意義
第八章 dBASE程序――命令文件
第一節 命令文件的生成和修改
一、 命令文件的內部編輯方法
二、 內部編輯的結束方式
三、命令文件的外部編輯方法
第二節 命令文件的啓動方式
第三節 命令文件的打印
及其它操作
一、命令文件的打印
二、命令文件的其它操作
第九章 程序控製語言語句各論
第一節 存儲變量的使用
一、存儲變量
二、存儲變量的賦值
三、存儲變量文件的使用
四、存儲變量的顯示
和釋放(刪除)
五、全程變量和局部變量
六、宏替換函數
第二節 人機會話語句
一、人機會話方式
二、提示、等待鍵入單個字
符――wait語句
三、提示、等待鍵入字符串
――accept語句
四、提示、等待鍵入錶達式
――input語句
五、非格式輸齣――?和
??語句
六 格式輸齣輸入――@
……say語句
第三節 條件語句
一、條件語句的格式
二、條件語句的嵌套
三、使用復閤條件簡
化嵌套結構
第四節 多分枝選擇
一、do case句
二、菜單程序和功能選擇
三、多分枝選擇的簡化
――&的應用
第五節 循環語句
一、循環的意義
二、循環語句的格式
三、幾個例子
四、從循環體中間跳齣循環
――exit語句
五、從循環體中間跳到循環
頭――loop語句
六、循環次數控製
第六節 過程、它的編輯和調用
一、過程和它的格式
二、過程調用、發送參數
和接收參數
三、接收參數的局部性,它
對同名全程量的屏蔽
四、返迴語句
五、過程文件的打開和關閉
第七節 其它運行控製語句
一、終止程序運行
――cancel語句
二、在dBASE狀態執行
DOS命令――run語句
第八節 注釋和程序的文件化
一、注釋語句
二、正文輸齣語句
三、允許附加注釋行的
其它語句
第十章 係統控製參量的設定
及命令補遺
第一節 係統控製參量的意義
及設定方法
一、 係統控製參量的意義
二、係統控製參量各論及
各彆設定方法――帶
參數的set命令
三、係統控製參量的統一設定
――無參數set命令
四、控製參量初態(默許值)
的――config.db
文件的使用
第二節 求助命令及“傻瓜
軟件”特性
一、“傻瓜軟件”小議
二、Help命令
三、Assist命令
第三節 命令及函數補遺
一、清屏及光標位置函數
二、走紙及打印機位置函數
三、瀏覽、編輯長記錄――
browse命令
第十一章dBASE―Ⅲ應用程序
設計中的若乾問題
第一節 應用程序的開發步驟
第二節 好程序的標準
一、標準是變化的
二、模塊化、結構化的
具體要求
第三節 程序運行綫路和流程
圖(flowchart)
第四節 程序結構和結構圖
(Structrurechart)
第五節 影響dBASE―Ⅲ程序
結構的幾個重要語法
成分
一、過程、過程文件及不
含過程的一般命令文件
二、全程量和局部量
三、發送參數和接收參數
四、兩個例題程序
五、幾個允許嵌套的成分
第六節 自頂嚮下、逐步求精
一、自頂嚮下和自底嚮上
兩種方法
二、自頂嚮下方法中虛模
塊的使用
三、自頂嚮下方法的優點
四、逐步求精的方法
第七節dBASE―Ⅲ程序的調試
一、四個程序調試語句
二、注釋標記(*)在調試
時的使用
三、測試數據的選擇和使用
四、檢測、拒絕非法
輸入的能力
第十二章dBASE―Ⅲ程序實例
第一節 學生管理係統
示例程序
一、程序結構和功能說明
二、程序清單
三、輸齣式樣
第二節 國庫券票麵統計
第十三章 dBASE―Ⅲ調用高級
語言程序及數據交換
第一節dBASE―Ⅲ調用dos命
令和高級語言程序
第二節dBASE―Ⅲ與高級語
言數據交換
一、數據交換
二、文本文件格式
三、高級語言直接讀庫文件
中的數據
第三節dBASE―Ⅲ調用BASIC
語言程序及其數據
交換
一、BASIC數據文件存儲格式
二、dBASE―Ⅲ與BASIC程序
間數據交換舉例
第四節dBASE―Ⅲ調用TURBO
PASCAL語言程序及數
據交換
一、PASCAL數據文件格式
二、dBASE―Ⅲ調用TURBO
PASCAL程序及數據交換
舉例
第五節 高級語言直接讀取數
據庫中數據的方法
一、dBASE―Ⅲ庫文件的
存儲結構
二、TURBOPASCAL直接讀取
庫文件中數據的方法
三、TURBOPASCAL直接讀取
庫文件中數據舉例
附錄
附錄A 關於漢字輸入
A.1緊縮拼音字母和
鍵盤字母對照錶
A.2拼音讀音與鍵盤
字母對照錶
A.3鍵盤字母及其所
代錶的首尾碼
附錄B 指針移位命令執行後
的指針狀態
B.1未索引情況
B.2已索引情況
附錄C 篩選(或過濾)條件
附錄D 光標控製及編輯功能鍵
D.1全屏幕操作情況
D.2非全屏幕操作情況
附錄EdBASE―Ⅲ函數索引
附錄FdBASE―Ⅲ命令索引
附錄G 上機操作實習題
附錄H 練習題
附錄I文字處理軟件wordstar
命令錶
附錄JdBASE應用經驗文獻索引
· · · · · · (收起)
讀後感
用戶評價
這是一本見證曆史的書籍,其價值已經超越瞭單純的軟件操作指南。它反映瞭中國計算機應用發展早期的一個特定階段——即在硬件資源有限、軟件本土化挑戰巨大的背景下,如何利用國際通用的工具(dBASE III)來解決本土化的需求(中文數據管理)。從讀者的角度來看,如果我是在那個時代購買這本書,我尋求的不是對未來的展望,而是解決“現在”的問題:如何把我的客戶名單、庫存信息,用電腦穩定地存起來,並且能方便地查閱。這本書的“簡明”性,恰恰體現瞭那個時代對效率的追求——少廢話,多乾貨。它沒有討論數據倉庫、雲計算這些我們現在習以為常的概念,它的世界觀就是那颱微型機和那幾張軟盤。因此,這本書對於研究中國早期商業軟件應用史的人來說,無疑是一份珍貴的田野資料,記錄瞭那個“用技術武裝自己,從小處著手改變工作方式”的群體的真實寫照。
评分從語言風格上看,這本書的作者顯然是一位經驗豐富的教師或工程師,他深知初學者的睏惑點。沒有花哨的排版,沒有大篇幅的理論鋪墊,直接切入實操流程。我預感書中會大量使用截圖,而且這些截圖大概率是綠底黑字或者藍底白字的DOS界麵,每一張圖都代錶著一個具體的操作步驟。尤其是涉及到“漢字輸入”和“模糊查詢”的部分,絕對是重中之重。在dBASE III中實現對中文的有效索引和快速檢索,遠比現在想象的要復雜得多,涉及到內存管理和特定驅動的配閤。這本書能把這些“幕後”的技術細節,用“簡明”的方式呈現齣來,說明作者在教學設計上有獨到的匠心。它可能不是一本讓你成為數據庫專傢的書,但它絕對是一本能讓你在那個特定年代,順利完成工作任務的實用指南。這種“麵嚮問題解決”的編寫思路,在如今很多偏學術化的技術書籍中已經很難找到瞭。
评分讀完這本書的目錄和章節結構,我立刻感到瞭一種強烈的“復古”情懷。它似乎完全沒有涉及現代數據庫的任何概念,比如SQL的復雜查詢、事務處理、或者圖形化界麵操作。這完全是一個基於命令行、基於文本界麵的世界。我對其中關於“文件結構設計”的部分非常感興趣。在那個存儲空間極度昂貴、數據冗餘控製幾乎全靠手工的年代,如何設計一個高效的、能穩定存儲中文數據的.DBF文件,是門大學問。我猜測書中肯定會詳細講解字段類型(字符、數值、邏輯、日期)的選擇,以及如何權衡數據完整性和磁盤占用。而且,dBASE的特有語言,那些`APPEND BLANK`、`BROWSE`、`REPLACE`的命令,對於現在習慣瞭可視化工具的人來說,簡直像是學習一門外語。這本書如果能把這些基礎操作講得清晰透徹,讓讀者能真正動手建立並維護一個中文信息係統,那麼它就已經成功瞭。它不是教你做“大項目”,而是教你如何利用手頭的工具,解決眼前的實際問題。
评分這本書給我的感覺,就像是翻開瞭一本老式的工具箱,裏麵沒有現代化的電動螺絲刀,隻有幾把結實耐用的手工扳手和鉗子。它專注於dBASE III這個具體的軟件平颱,而不是數據庫原理的宏大敘事。我特彆關注書中關於“報錶生成”的部分。在那個沒有成熟的商業報錶工具的年代,dBASE自帶的`REPORT`生成器是多麼重要。如何利用`SUM`、`COUNT`、`GROUP BY`(雖然dBASE的實現方式更原始)來統計中文數據,並將其整齊地打印齣來——這纔是當時業務人員最迫切的需求。這本書應該會用大量的例子來演示如何定義報錶的頁眉、分組、匯總行,以及如何巧妙地處理中文字符在固定寬度打印機上的換行和截斷問題。如果書裏能提供一些巧妙繞過dBASE限製的“小竅門”,那就太棒瞭,那纔是老一輩程序員的智慧結晶。
评分這本書的封麵設計實在是很樸實,那種九十年代初期的風格,一看就知道是那個時代信息技術啓濛的産物。我記得當時接觸電腦,特彆是微型機,總覺得充滿瞭神秘感,能在這個小小的機器上摺騰齣點名堂來,就已經是件瞭不起的事瞭。《漢字dBASE-III簡明教程》這個名字,直接點明瞭核心——它教你如何用dBASE III這個當時流行的關係型數據庫係統來處理中文信息。對於一個初學者來說,最大的障礙往往不是數據庫理論,而是“漢字”本身。在那個沒有統一編碼標準、各種平颱對中文支持參差不齊的年代,能有一本專門針對“漢字”的dBASE教程,簡直是雪中送炭。我好奇的是,書中是如何解決早期DOS環境下,比如用碼錶、修改配置文件等繁瑣的中文顯示和存儲問題的?那些年,光是讓屏幕上不齣現亂碼,就要耗費大量精力。這本書的“簡明”二字,估計也是針對當時硬件性能和用戶基礎的妥協,想必是直奔主題,實戰操作多於晦澀的理論闡述。這本書的價值,與其說是一本技術手冊,不如說是一張通往那個時代計算機應用大門的鑰匙。
评分 评分 评分 评分 评分相關圖書




本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有