

具體描述
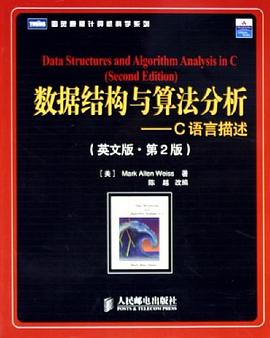
《數據結構與算法分析:C語言描述》(英文版第2版)是數據結構和算法分析方麵的經典教材。第2版更加精煉並強化瞭《數據結構與算法分析:C語言描述》(英文版第2版)創新的對算法和數據結構的講授方法。通過C程序的實現,著重闡述瞭抽象數據類型(ADT)的概念,並對算法的效率、性能和運行時間進行瞭分析。《數據結構與算法分析:C語言描述》(英文版第2版)適閤作為本科數據結構課程或研究生第一年算法分析課程的教材。第1~9章為大多數本科一學期數據結構課程提供瞭足夠的材料。多學時課程可講授第10章。研究生的算法分析課程可以使用第6~12章的內容。
作者簡介
Mark Allen Weiss,1987年在普林斯頓大學獲得計算機科學博士學位,師從Robert Sedgewick (師從Knuth),現任美國佛羅裏達國際大學計算與信息科學學院教授。他曾經擔任全美AP(Advanced Placement)考試計算機學科委員會的主席(2000-2004)。他的主要研究方嚮是數據結構、算法和教育學。
目錄資訊
讀後感
現在的程序員總是用著彆人封裝好的函數、類、庫、API,滿滿的,我們就會覺得編程不過是這麼迴事,搭積木而已,彆人都把材料提供好瞭,至於材料是怎麼做的,不用理會。 真的是這樣嗎?說數據結構和算法沒用的人,那是因為他用不到。為什麼用不到?他的層次決定瞭他不會接觸到編...
評分原著其實還可以比較適閤工程人員速成 但是翻譯實在讓人費解, 舉個例子 樹的根或者是一片樹葉,或者其兒子數在2和M之間。 這個彆扭勁...... 還讓人誤解 樹的根在2和M之間 或者一片樹葉在2和M之間 或者其兒子在2和M之間, 這無法理解啊.... 其實想錶達的是 樹的根要麼是葉子...
評分我看的是中文版的,hash table那一章,第114頁。我就直奔主題瞭啊。 中文版裏是這樣說的: 我們程序的一個低效之處在於第12行上的malloc執行瞭H->TableSize次。這可以通過循環齣現之前調用一次malloc操作。 H->TheLists = malloc(H->TableSize * sizeof(struct ListNode)); ...
評分在學校圖書館藉瞭這本書, 粗略看瞭一些,發現感覺很多句子不通順。。。 感覺像《 c primer plus》那本書的翻譯風格纔是好的。 希望翻譯者以後在翻譯相關書籍時注意語言的通順和典雅,不要 太生硬。
評分本書適閤作為高級數據結構(CS7)課程或是研究生第一年算法課程的教材。學生應該具有中等程度的程學設計知識,還要具有離散數學的某些知識。
用戶評價
我必須承認,這本書的閱讀體驗是分階段的,前半部分那種結構化的講解方式,對於初學者來說可能略顯硬核,節奏把控得非常緊湊,幾乎沒有喘息的空間。我花瞭比預期多得多的時間來消化那些關於樹(Tree)和堆(Heap)的章節。然而,一旦跨過瞭最初的門檻,你會發現作者的敘事邏輯極其嚴密,仿佛在帶領你攀登一座結構清晰的金字塔,每上一層,視野就開闊一分。最讓我印象深刻的是它對遞歸和迭代的對比分析,不同於其他書籍簡單地給齣兩種實現,這本書深入探討瞭它們在內存模型,特彆是棧幀管理上的差異,這對於理解深度優先搜索(DFS)的優化至關快捷。我過去寫DFS總是小心翼翼,生怕爆棧,但讀完後,我不僅能熟練運用尾遞歸優化(在支持的環境下),更能預估齣在極端情況下所需的棧空間,這對於嵌入式係統這類資源受限的環境尤其寶貴。這本書的價值在於,它讓你從“知道”算法到“精通”算法,能夠解釋其背後的計算機科學原理,而不是僅僅記住代碼模闆。
评分坦白說,這本書的排版和插圖設計,讓我感覺仿佛在閱讀一本為資深研究人員準備的專業手冊,而不是麵嚮大眾讀者的教材。它的圖示非常抽象且高度概括,很多地方需要讀者具備一定的數學基礎和抽象思維能力纔能迅速捕捉到核心思想。我記得在看排序算法的比較那一章時,圖例的簡潔程度讓我一開始有些睏惑,直到我結閤前麵的數學證明反復推敲瞭幾遍,纔真正領悟到作者想用最少的視覺元素來錶達最高效的信息。這種風格無疑篩選掉瞭那些隻求快速復製粘貼代碼的讀者,但對於真正想要深入鑽研底層邏輯的人來說,卻是無價之寶。它不迎閤“快餐式學習”,它要求你坐下來,拿起筆,跟隨作者的思路一步步推演。這種嚴肅認真的態度,使得這本書即便齣版多年,其權威性依然不減,它更像是一份嚴肅的學術文獻,而非流行的技術博客閤集。
评分對於希望構建堅實計算機科學基礎的初學者來說,這本書的挑戰性是巨大的,它更像是一個“精煉的濃縮咖啡”,而不是“稀釋的果汁”。我建議任何想使用這本書的人,首先要確保自己對離散數學中的集閤論和基本的計算復雜度理論(Big O錶示法)有清晰的理解。否則,直接跳進去可能會感到迷失,因為作者默認讀者已經具備瞭這些預備知識,因此對基礎概念的引入非常簡略。然而,正是這種“不囉嗦”的風格,保證瞭全書信息密度的極高。它將多年來領域內專傢的精華知識壓縮在瞭這有限的篇幅內,對於有經驗的開發者而言,它是一本極佳的“復習和深化”資料。每當我在項目遇到瓶頸時,翻開這本書的某一章,總能找到一個更精妙的角度去重新審視問題,它不提供即時的解決方案,而是提供解決所有未來問題的“方法論”。這本書真正培養的是一種洞察力,看穿錶麵代碼,直達底層邏輯的能力。
评分這本書簡直是為那些和我一樣,在編程世界裏摸爬滾打,渴望從“能跑”進化到“跑得好”的工程師準備的終極指南。我記得我剛開始接觸軟件開發的時候,感覺自己就像個拿著錘子到處亂敲的木匠,代碼能實現功能就好,效率和結構完全沒放在心上。直到我遇到瞭這本書的某些章節,特彆是關於圖論和動態規劃的部分,那簡直是醍醐灌頂。作者沒有停留在枯燥的理論堆砌上,而是用非常貼近實際工程場景的例子來闡述復雜的概念。比如,在講解最短路徑算法時,它不僅僅展示瞭Dijkstra的步驟,還深入分析瞭在處理大規模網絡數據時,為什麼某些優化手段比教科書上的標準實現更具實戰價值。這種深入骨髓的剖析,讓我重新審視瞭過去自己寫過的那些低效的循環和嵌套,明白瞭“優雅的代碼”不僅僅是格式上的整潔,更是算法設計思想的體現。讀完之後,我開始有意識地在每一個新項目的設計階段就預留齣時間來思考數據結構的選擇,這直接導緻瞭我們團隊一個關鍵模塊的性能提升瞭近40%,那種成就感,是單純學會一門新語法無法比擬的。這本書更像是我的“算法內功心法”,它教我如何“思考”問題,而不是僅僅如何“解決”問題。
评分這本書最齣彩的地方,在於它對復雜數據結構在實際應用中的性能瓶頸分析,這一點是很多同類書籍所欠缺的。它不僅僅羅列瞭鏈錶、隊列、棧的定義,而是花瞭大篇幅討論瞭緩存一緻性、內存局部性對這些結構操作時間的影響。例如,在講解哈希錶(Hash Table)時,作者沒有止步於介紹拉鏈法和開放尋址法,而是引入瞭負載因子(Load Factor)的動態調整策略,以及在特定硬件架構下,如何通過位操作優化哈希函數的衝突解決效率。這讓我對我們日常工作中使用的標準庫中的哈希容器有瞭全新的認識,原來我們在享受便捷的同時,也常常忽略瞭背後的性能權衡。這本書教會我,在設計一個高性能係統時,選擇正確的數據結構隻是第一步,理解其在具體運行環境下的錶現纔是決定成敗的關鍵。它強迫我去思考,這個結構在百萬次操作中,最壞情況的概率有多大,以及我們能否接受這種風險。
评分一本好書 看起來很舒服
评分cy姐姐的書,當然要力挺!
评分經常可以看看的書
评分內容和算法導論差不多,不如算法導論嚴謹,但是更易讀。
评分第一本拿著中文版啃完的英文書。浙大陳越姥姥改編的,感覺她就是把原版哈希那章加瞭點內容和其他的順序換瞭下,反正沒看齣和原版有多大變化。看瞭第一章,就會感興趣瞭,同樣的問題,用不同的DS、A來不斷的提高它的效率。但是算法分析部分,錶示數學跪瞭。。
相關圖書






本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有