
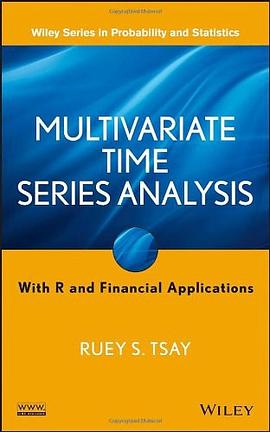
Multivariate Time Series Analysis pdf epub mobi txt 电子书 下载 2026
- R
- TimeSeries
- 金融
- 统计学
- 统计
- 经济学
- 科普
- 时间序列
- 时间序列分析
- 多元时间序列
- 统计学
- 计量经济学
- 数据分析
- 预测
- 建模
- 金融
- 机器学习
- 信号处理

具体描述
Since the publication of his first book, Analysis of Financial Time Series, Ruey Tsay has become one of the most influential and prominent experts on the topic of time series. Different from the traditional and oftentimes complex approach to multivariate (MV) time series, this sequel book emphasizes structural specification, which results in simplified parsimonious VARMA modeling and, hence, eases comprehension. Through a fundamental balance between theory and applications, the book supplies readers with an accessible approach to financial econometric models and their applications to real-world empirical research. The book utilizes the freely available R software package to explore complex data and illustrate related computation and analyses in a user-friendly way. An author-maintained website features additional data sets in R, Matlab and Stata scripts so readers can create their own simulations and test their comprehension of the presented techniques.
作者简介
RUEY S. TSAY, PhD, is H.G.B. Alexander Professor of Econometrics and Statistics at The University of Chicago Booth School of Business. He has written over 125 published articles in the areas of business and economic forecasting, data analysis, risk management, and process control. A Fellow of the American Statistical Association, the Institute of Mathematical Statistics, and Academia Sinica, Dr. Tsay is author of Analysis of Financial Time Series, Third Edition and An Introduction to Analysis of Financial Data with R, and coauthor of A Course in Time Series Analysis, all published by Wiley.
目录信息
读后感
用户评价
总的来说,这本书的价值远超出了一个单纯的工具书范畴。它更像是一位经验丰富、治学严谨的导师,引导你在浩瀚的时间序列海洋中,建立起一套科学、系统的分析框架。它的覆盖面极广,从基础的平稳性、ARIMA家族的扩展,到前沿的非线性模型、状态空间方法,以及高维数据的降维处理,都有涉猎,且不流于表面。我发现,这本书的结构设计非常适合作为研究生阶段的课程教材,因为它要求读者具备一定的数理基础,但又不会因为理论的艰深而劝退初学者。尤其是对于那些致力于在复杂系统(如能源消耗、气候变化、大规模传感器网络)中寻找潜在耦合关系的研究人员来说,这本书提供了必要的理论武装和操作指引。阅读完毕后,我感觉自己对于如何科学地“提问”时间序列数据——即如何正确设定模型结构以反映潜在的物理或经济规律——有了更深刻的理解和更坚定的信心。
评分深入阅读了关于状态空间模型和卡尔曼滤波的部分后,我必须承认,作者在处理这些高阶话题时的阐述逻辑达到了一个相当高的水准。很多其他教材在介绍卡尔曼滤波时,往往直接给出复杂的递推公式,读者只能死记硬背,却不明白背后的物理或统计学意义。这本书的处理方式则完全不同,它花了相当的篇幅,从贝叶斯更新的角度,一步步引导读者理解“预测”和“校正”这两个核心步骤是如何动态平衡的。作者巧妙地使用了历史数据模拟,展示了当传感器噪声或过程噪声发生变化时,滤波器是如何自适应调整权重的。更让我印象深刻的是,他没有止步于标准的线性卡尔曼滤波,而是拓展到了扩展卡尔曼(EKF)和无迹卡尔曼(UKF)的应用场景,特别是在非线性系统辨识上的局限性和应对策略,讲解得极其透彻。这种对细节的把控和对理论基础的坚实回归,使得即便是相对抽象的随机过程理论,也变得可以被工程师和数据分析师们有效地吸收和应用。这部分内容,我已经反复阅读了好几遍,每一次都有新的领悟。
评分关于多元时间序列的协整性(Cointegration)分析部分,是这本书真正体现其专业深度的试金石。我以前接触过一些关于单变量的单位根检验,但多变量情况下,协整关系的识别和向量误差修正模型(VECM)的建立,总是让我感到云里雾里。这本书在这里的讲解,可以说是教科书级别的典范。它首先清晰地界定了格兰杰因果关系、超前滞后关系与协整关系的本质区别,避免了常见的混淆。随后,在介绍恩格尔-格兰杰两步法和约翰森检验时,作者不仅给出了严谨的数学推导,更重要的是,他针对实际操作中常遇到的“秩不足”或“模型设定不当”等问题,提供了详实的诊断流程图。例如,如何通过残差的自相关性图来判断协整阶数,以及在VECM中如何选择适当的滞后项(p值与AIC/BIC准则的权衡)。这些实操层面的指导,远比单纯的理论介绍有价值得多,它真正帮助我将理论知识转化为了可以在实际金融或经济模型中应用的工具。
评分这本书在处理模型选择和模型诊断方面的细致程度,是我此前阅读的许多经典教材所不及的。通常,教材会罗列一大堆检验方法,但很少有人会系统地讨论如何在模型复杂性和拟合优度之间找到最佳平衡点。这本书专门设置了一个章节,探讨了基于信息准则(如AIC、BIC、HQIC)的VAR模型阶数选择,并结合了模型稳定性的图形化验证。我特别欣赏作者提出的“稳健性测试”概念,即不只依赖单一最优模型,而是要考察多个合理模型下的预测结果是否具有一致性。在模型诊断方面,作者强调了对残差白噪声特性的检验,特别是多元残差的交叉相关性检验,这在单变量分析中容易被忽略。通过大量的代码示例(虽然没有明确指出是R还是Python,但逻辑清晰),读者可以直观地看到一个“坏模型”的残差图与一个“好模型”的残差图之间的巨大差异。这种强调“实践检验高于理论推导”的写作风格,极大地提升了阅读的实用价值。
评分这本书的封面设计,坦率地说,第一眼看到的时候,并没有立刻抓住我的眼球。那种设计风格,有点像是上世纪末统计学教科书的复古感,配色偏向于沉稳的深蓝和米白,字体选择也比较传统和严肃。我当时有点犹豫,担心内容会过于陈旧或者晦涩难懂。不过,翻开目录后,我的态度开始转变。作者在绪论部分就非常清晰地勾勒出了时间序列分析在现代数据科学中的核心地位,特别是强调了多变量数据的复杂性和重要性,这让我感到欣慰。他没有一上来就陷入复杂的数学推导,而是先用几个生动的实际案例,比如金融市场的联动性分析和环境监测数据的相互影响,来阐述为什么要研究多变量模型。这种“先入情景,再入理论”的铺垫方式,对于我这种更注重应用层面的读者来说,是非常友好的开端。而且,书中的排版非常注重可读性,大量的图表和公式都被恰当地穿插在文字说明中,不像有些专业书籍那样,把所有数学符号堆砌在一起,让人望而生畏。整体来说,初次接触的感受是:这本书外表朴实,内里却蕴含着对教学和理解深度思考的痕迹,让人愿意继续往下读。
评分研究生级别的教材,写得挺好,就是这个领域现在发展挺快的,很多新进展还没有包括进来。
评分研究生级别的教材,写得挺好,就是这个领域现在发展挺快的,很多新进展还没有包括进来。
评分研究生级别的教材,写得挺好,就是这个领域现在发展挺快的,很多新进展还没有包括进来。
评分研究生级别的教材,写得挺好,就是这个领域现在发展挺快的,很多新进展还没有包括进来。
评分研究生级别的教材,写得挺好,就是这个领域现在发展挺快的,很多新进展还没有包括进来。
相关图书





本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有