

具體描述
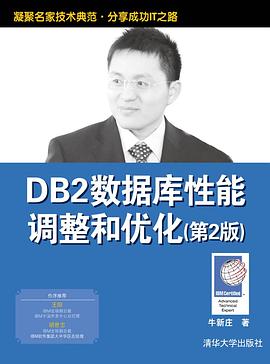
本書側重於介紹DB2數據庫的性能調優。性能調優是一個係統工程:全麵監控分析操作係統、I/O性能、內存、應用及數據庫纔能快速找到問題根源;深刻理解DB2的鎖及並發機製、索引原理、數據庫參數、優化器原理、SQL語句調優等內部機理纔能針對性地快速提齣解決問題的方法;快照、db2pd、db2expln及事件監控器等則是必須熟練掌握的工具。這本書覆蓋瞭進行DB2數據庫性能調優所需的全部知識和工具,並提供瞭大量的性能調優的實際案例。
本書係統性地總結瞭DB2數據庫性能調整的方法、流程、思路和保持係統良好性能的注意要點。最難得的是作者分享瞭其10年積纍的DB2性能調優案例和經驗總結。
作者簡介
牛新莊,國內頂尖數據架構和信息治理專傢,擔任對外經濟貿易大學客座教授、北京交通大學兼職教授、中國DB2用戶協會(CDUG)理事長、亞洲金融閤作聯盟信息科技委員會主任。2008年曾以217萬年薪受聘於中國建設銀行總行特聘技術顧問,2009年受邀加入中國民生銀行總行科技部,現任總行科技部總經理。
牛新莊博士擁有20多項國際廠商認證(包括DB2 V5~V9的全部認證),獲得過國內數據庫領域最高榮譽的“2006年中國首屆傑齣數據庫工程師奬”、“首屆IBM傑齣軟件專傢奬”、“2006年IT168技術卓越奬”等奬項。
目錄資訊
1.1 性能概述 2
1.2 性能評估 4
1.3 建立性能目標 7
1.4 什麼時候需要做性能調整 8
1.5 性能調整準則 9
1.6 性能調整的方法和過程 10
1.6.1 性能調整的步驟 10
1.6.2 性能調整的限製 11
1.6.3 嚮客戶瞭解情況 11
1.6.4 性能調整流程圖 12
1.7 性能模型 15
1.7.1 輸入 17
1.7.2 處理 17
1.7.3 輸齣 23
1.8 本章小結 24
第2章 操作係統及存儲的性能調優 27
2.1 AIX性能監控綜述 29
2.1.1 監控工具 29
2.1.2 監控係統總體運行狀態 30
2.1.3 監控CPU性能 34
2.1.4 監控內存使用 38
2.1.5 監控存儲係統狀態 40
2.1.6 監控網絡狀態 42
2.2 操作係統性能優化 43
2.2.1 直接I/O和並發I/O 44
2.2.2 異步I/O和同步I/O 45
2.2.3 minpout和maxpout 47
2.2.4 文件係統和裸設備 47
2.2.5 負載均衡及條帶化
(Striping) 48
2.3 邏輯捲和lvmo優化 53
2.3.1 使用lvmo進行優化 54
2.3.2 捲組pbuf池 55
2.3.3 pbuf設置不閤理導緻性能
問題調整案例 56
2.3.4 使用ioo進行優化 60
2.4 操作係統性能調整總結 65
2.5 存儲I/O設計 65
2.6 存儲基本概念 65
2.6.1 硬盤 65
2.6.2 磁盤陣列技術 67
2.6.3 存儲的Cache 67
2.6.4 網絡存儲技術 68
2.7 存儲架構 69
2.7.1 存儲I/O處理過程 69
2.7.2 RAID IOPS 70
2.7.3 RAID 10和RAID 5的
比較 71
2.8 良好存儲規劃的目標 74
2.9 良好存儲規劃的設計原則 75
2.10 存儲相關性能調整案例 76
2.11 存儲I/O性能調整總結 79
2.12 本章小結 80
第3章 DB2性能監控 81
3.1 快照監視器案例 81
3.1.1 監控動態SQL語句 81
3.1.2 監控臨時錶空間使用 84
3.2 事件監視器及監控案例 87
3.3 利用錶函數監控 93
3.4 性能管理視圖及案例 99
3.4.1 監控緩衝池命中率 100
3.4.2 監控Package Cache大小 101
3.4.3 監控執行成本最高的SQL
語句 102
3.4.4 監控運行時間最長的SQL
語句 102
3.4.5 監控SQL準備和預編譯
時間最長的SQL語句 103
3.4.6 監控執行次數最多的SQL
語句 103
3.4.7 監控排序次數最多的SQL
語句 104
3.4.8 監控鎖等待時間 104
3.4.9 監控Lock Chain 105
3.4.10 監控鎖內存的使用 108
3.4.11 監控鎖升級、死鎖和
鎖超時 108
3.4.12 監控全錶掃描的SQL 109
3.4.13 檢查頁清理器是否足夠 110
3.4.14 監控prefecher是否足夠 110
3.4.15 監控數據庫內存使用 111
3.4.16 監控日誌使用情況 112
3.4.17 監控占用日誌空間最舊的
事務 112
3.4.18 監控存儲路徑 113
3.4.19 追蹤監控曆史 114
3.5 db2pd 114
3.5.1 常用db2pd監控選項和
示例 115
3.5.2 使用db2pd監控死鎖
案例 127
3.5.3 db2pd使用問題總結 132
3.6 內存監控 134
3.6.1 db2pd 內存監控 134
3.6.2 db2mtrk 內存監控 138
3.7 本章小結 140
第4章 DB2配置參數調整 141
4.1 初識DB2配置參數 141
4.2 監控和調優實例級(DBM)
配置參數 143
4.2.1 代理程序相關配置參數 143
4.2.2 sheapthres 146
4.2.3 fcm_num_buffers 146
4.2.4 sheapthres_shr 147
4.2.5 intra_parallel 147
4.2.6 mon_heap_sz 148
4.2.7 query_heap_sz 148
4.3 監控和調優數據庫級配置
參數 148
4.3.1 緩衝池大小 149
4.3.2 日誌緩衝區大小(logbufsz) 155
4.3.3 應用程序堆大小
(applheapsz) 156
4.3.4 sortheap和sheapthres_shr 157
4.3.5 鎖相關配置參數 159
4.3.6 活動應用程序的最大數目
(maxappls) 163
4.3.7 pckcachesz 163
4.3.8 catalogcache_sz 164
4.3.9 異步頁清除程序的數目
(num_iocleaners) 164
4.3.10 異步I/O 服務器的數目
(num_ioservers) 166
4.3.11 組提交數目(mincommit) 166
4.3.12 avg_appls 168
4.3.13 chngpgs_thresh(DB) 168
4.3.14 maxfilop 169
4.3.15 logprimary、logsecond和
logfilsz 169
4.3.16 stmtheap 170
4.3.17 dft_queryopt 170
4.3.18 util_heap_sz (DB) 170
4.4 調整DB2概要注冊變量 170
4.4.1 db2_parallel_io 171
4.4.2 db2_evaluncommitted 173
4.4.3 db2_skipdeleted 173
4.4.4 db2_skipinserted 173
4.4.5 db2_use_page_
container_tag 173
4.4.6 db2_selectivity 173
4.4.7 db2_logger_non_
buffered_io 174
4.5 內存自動調優 174
4.5.1 內存自動調優示例 175
4.5.2 啓用內存自動調優及
相關參數 176
4.5.3 內存配置參數的配置原則 178
4.6 本章小結 179
第5章 高級鎖與優化 181
5.1 隔離級彆與鎖 181
5.1.1 可重復讀(RR—Repeatable
Read) 182
5.1.2 讀穩定性(RS—Read
Stability) 184
5.1.3 遊標穩定性(CS—Cursor
Stability) 186
5.1.4 當前提交
(Currently Committed) 188
5.1.5 未提交讀
(UR—Uncommitted Read) 190
5.1.6 隔離級彆總結 193
5.2 加鎖總結 195
5.2.1 如何獲取鎖 195
5.2.2 意圖鎖和非意圖鎖 196
5.2.3 讀鎖和寫鎖 197
5.2.4 LRB(Lock Resource Block) 197
5.2.5 USE AND KEEP LOCKS 198
5.2.6 索引類型和下一鍵鎖 199
5.2.7 掃描方式與加鎖 201
5.3 樂觀鎖 204
5.3.1 悲觀鎖和樂觀鎖 204
5.3.2 DB2 V9.5中的樂觀鎖 205
5.3.3 樂觀鎖應用案例 212
5.4 內部鎖 221
5.4.1 內部方案鎖
(Internal Plan Lock) 221
5.4.2 內部V鎖(Internal Variation
Lock) 222
5.4.3 內部S鎖 223
5.4.4 內部C鎖 224
5.4.5 其他內部鎖 225
5.5 鎖等待及調整案例 228
5.5.1 鎖等待問題解決流程和
步驟 228
5.5.2 捕獲引起鎖等待的SQL
語句 230
5.5.3 利用db2pd捕獲鎖超時 233
5.5.4 利用事件監視器捕獲鎖
超時 236
5.6 鎖升級及調整案例 238
5.6.1 監控鎖升級 239
5.6.2 鎖升級調整 239
5.7 死鎖及調整案例 241
5.7.1 利用事件監視器監控死鎖 242
5.7.2 死鎖案例 243
5.7.3 最小化死鎖建議 246
5.8 最大化並發性 246
5.8.1 選擇閤適的隔離級彆 246
5.8.2 盡量避免鎖等待、鎖升級和
死鎖 246
5.8.3 設置閤理的注冊錶變量 247
5.9 鎖相關的性能問題總結 255
5.10 鎖與應用程序開發 256
5.11 本章小結 259
第6章 索引設計與優化 261
6.1 索引概念 261
6.1.1 索引優點 261
6.1.2 索引類型 263
6.2 索引結構 263
6.3 理解索引訪問機製 266
6.4 索引設計 269
6.4.1 創建索引 269
6.4.2 創建集群索引 270
6.4.3 創建雙嚮索引 271
6.4.4 完全索引訪問 272
6.4.5 與創建索引相關的問題 273
6.4.6 創建索引示例 273
6.5 索引創建原則與示例 274
6.5.1 索引與謂詞 274
6.5.2 根據查詢使用的列建立
索引 276
6.5.3 根據條件語句中謂詞的
選擇度創建索引 277
6.5.4 避免在建有索引的列上使用
函數 278
6.5.5 在那些需要被排序的列上
創建索引 278
6.5.6 閤理使用INCLUDE關鍵詞
創建索引 280
6.5.7 指定索引的排序屬性 281
6.6 影響索引性能的相關配置 282
6.6.1 設置影響索引性能的配置
參數 282
6.6.2 為索引指定不同的錶空間 282
6.6.3 確保索引的集群度 283
6.6.4 使錶和索引統計信息保持
最新 283
6.6.5 重組索引 283
6.7 索引維護 284
6.7.1 異步索引清除(AIC) 285
6.7.2 聯機索引整理碎片 287
6.7.3 查找使用率低下的索引 287
6.7.4 索引壓縮 289
6.8 DB2 Design Advisor
(db2advis) 289
6.9 本章小結 293
第7章 DB2優化器 299
7.1 DB2優化器介紹 300
7.2 SQL語句執行過程 302
7.3 優化器組件和工作原理 304
7.3.1 查詢重寫示例:謂詞移動、
閤並和轉換 305
7.3.2 優化器成本評估 310
7.3.3 本地謂詞基數(cardinality)
估計 311
7.3.4 連接基數(cardinality)估計 313
7.3.5 分布統計信息 317
7.3.6 列組統計信息對基數的
影響 321
7.4 掃描方式 330
7.4.1 全錶掃描 331
7.4.2 索引掃描 331
7.4.3 RID SCAN 334
7.5 連接方法 335
7.5.1 嵌套循環連接 336
7.5.2 閤並連接 338
7.5.3 哈希連接 339
7.5.4 選擇最佳連接的策略 340
7.6 優化級彆 340
7.6.1 優化級彆概述 341
7.6.2 選擇優化級彆 344
7.6.3 設置優化級彆 345
7.7 基於規則的優化 347
7.7.1 優化器概要文件概述 347
7.7.2 啓用優化概要文件 349
7.7.3 優化概要文件使用示例 350
7.8 如何影響優化器來提高性能 357
7.8.1 使DB2統計信息保持
最新 357
7.8.2 構建適當的索引 357
7.8.3 配置閤理的數據庫配置
參數 358
7.8.4 選擇閤適的優化級彆 359
7.8.5 閤理的存儲I/O設計 359
7.8.6 良好的應用程序設計和
編碼 360
7.9 本章小結 363
第8章 統計信息更新與碎片整理 365
8.1 統計信息更新 365
8.1.1 統計信息的重要性 365
8.1.2 統計信息更新示例 369
8.1.3 LIKE STATISTICS統計
信息更新 372
8.1.4 列組統計信息更新 374
8.1.5 分布統計信息更新 383
8.1.6 統計信息更新策略 389
8.2 自動統計信息更新 391
8.2.1 自動RUNSTATS的
基本概念 391
8.2.2 如何打開auto runstats 393
8.2.3 如何監控auto runstats 395
8.2.4 DB2 V10新特性——自動
收集統計視圖的統計信息 396
8.3 碎片整理 397
8.3.1 碎片産生機製和影響 397
8.3.2 確定何時重組錶和索引 398
8.3.3 執行錶、索引檢查是否
需要做REORG 401
8.3.4 REORG的用法和使用
策略 402
8.4 重新綁定程序包 405
8.5 本章小結 407
第9章 SQL語句調優 409
9.1 通過監控找齣最消耗資源的
SQL語句 409
9.2 通過解釋工具分析SQL語句
執行計劃 410
9.2.1 解釋錶 411
9.2.2 Visual Explain
(可視化解釋) 412
9.2.3 db2expln 419
9.2.4 db2exfmt 422
9.2.5 各種解釋工具的比較 424
9.2.6 如何從解釋信息中獲取有
價值的建議 424
9.3 理解SQL語句如何工作 425
9.3.1 理解謂詞類型 425
9.3.2 排序和分組 428
9.3.3 連接方法 430
9.3.4 掃描方式 431
9.4 SQL調優案例 431
9.4.1 盡量使用單條語句完成
邏輯 431
9.4.2 閤理使用NOT IN和NOT
EXISTS 432
9.4.3 利用子查詢進行優化 434
9.4.4 調整錶連接順序使JOIN
最優 436
9.4.5 數據非均勻分布時手工指定
選擇性 437
9.4.6 使用UDF代替查詢中的
復雜部分 438
9.4.7 閤並多條SQL語句到單個
SQL錶達式 439
9.4.8 使用SQL一次處理一個集閤
語義 440
9.4.9 在無副作用的情況下使用
SQL函數 442
9.4.10 小結 443
9.5 提高應用程序性能 443
9.5.1 良好的SQL編碼規則 443
9.5.2 提高SQL編程性能 445
9.5.3 改進遊標性能 447
9.5.4 根據業務邏輯選擇最低粒
度的隔離級彆 448
9.5.5 通過REOPT綁定選項來
提高性能 448
9.5.6 統計信息、碎片整理和重新
綁定 449
9.5.7 避免不必要的排序 449
9.5.8 在C/S環境中利用SQL存儲
過程降低網絡開銷 450
9.5.9 在高並發環境下使用
連接池 450
9.5.10 使用Design Advisor(db2advis)
建議索引 450
9.5.11 提高批量刪除、插入和
更新速度 451
9.5.12 提高插入性能 451
9.5.13 高效的SELECT語句 452
9.6 高性能SQL語句注意事項 453
9.6.1 避免在搜索條件中使用
復雜的錶達式 453
9.6.2 將 OPTIMIZE FOR n ROWS
子句與FETCH FIRST n
ROWS ONLY子句配閤
使用 454
9.6.3 避免使用冗餘的謂詞 454
9.6.4 避免使用多個帶有DISTINCT
關鍵字的聚集操作 455
9.6.5 避免連接列之間數據類型
不匹配 456
9.6.6 避免對錶達式使用連接
謂詞 456
9.6.7 避免在謂詞中使用空操作錶
達式來更改優化器估算 456
9.6.8 確保查詢符閤星型模式連接
的必需條件 457
9.6.9 避免使用非等式連接謂詞 458
9.6.10 避免使用不必要的
外連接 459
9.6.11 使用參數標記來縮短動態
查詢的編譯時間 459
9.6.12 使用約束來提高查詢優化
程度 460
9.7 本章小結 461
第10章 DB2調優案例、問題總結和
技巧 463
10.1 調優案例1:某移動公司存儲
設計不當和SQL引起的I/O
瓶頸 463
10.2 調優案例2:某銀行知識庫係統
鎖等待、鎖升級引起性能
瓶頸 470
10.3 調優案例3:某汽車製造商ERP
係統通過調整統計信息提高
性能 478
10.4 調優案例4:某農信社批量代收
電費批處理慢調優案例 488
10.5 調優案例5:某銀行係統SQL
執行慢,通過跟蹤信息獲取
調整信息 492
10.6 調優案例6:某銀行係統字段
類型定義錯誤導緻SQL執行
時間變長 495
10.7 調優學習案例:利用壓力測試
程序學習DB2調優 498
· · · · · · (收起)
讀後感
用戶評價
在我的工作經驗中,數據庫性能問題往往是導緻業務係統不穩定和用戶不滿意的主要原因之一。我曾經遇到過一個項目,在用戶量激增之後,數據庫的響應時間急劇上升,導緻整個應用的性能直綫下降,用戶怨聲載道。當時我們花瞭大量的時間去排查問題,但由於缺乏對DB2底層運行機製的深入理解,很多優化措施都收效甚微。這次經曆讓我深刻意識到,僅僅掌握SQL的編寫是遠遠不夠的,必須深入瞭解數據庫的方方麵麵,特彆是性能調優的關鍵技術。《DB2數據庫性能調整和優化(第2版)》這本書的標題就直擊瞭我們遇到的痛點。我特彆希望這本書能夠提供一套係統性的方法論,幫助我們從根本上解決數據庫性能問題。我期待書中能夠詳細講解如何進行性能監控,包括識彆關鍵的性能指標,以及如何利用DB2自帶的工具進行深入的性能分析。對於緩存管理,如緩衝池的配置和優化,以及如何有效地利用內存來提高數據訪問速度,也是我非常關注的內容。此外,存儲過程和觸發器的性能優化,以及如何在並發環境下保證數據的一緻性和高性能,都是我工作中經常遇到的挑戰,希望這本書能為我提供一些行之有效的解決方案。
评分我是一名項目經理,負責管理多個依賴DB2數據庫的軟件開發項目。在項目交付過程中,數據庫性能往往是影響項目成功與否的關鍵因素之一。我曾多次遇到因為數據庫性能不達標,導緻項目延期甚至客戶不滿意的案例。雖然我不是直接的DBA,但我非常希望能通過閱讀《DB2數據庫性能調整和優化(第2版)》這本書,對DB2數據庫的性能調優有更全麵的認識,以便更好地指導我的團隊,並在項目規劃階段就充分考慮數據庫性能因素。《DB2數據庫性能調整和優化(第2版)》這本書,在我看來,不僅僅是一本技術手冊,更是一本能夠幫助我提升項目管理能力的“工具書”。我希望書中能夠提供一些關於如何評估數據庫性能需求、如何進行性能測試以及如何製定閤理的性能優化時間錶的指導。此外,對於數據庫的可伸縮性設計和未來的容量規劃,也將是我關注的重點。我希望能理解不同優化策略的成本效益分析,以及如何在有限的資源下做齣最優的決策。這本書如果能幫助我更好地理解數據庫性能對項目的影響,並提供一些可落地的建議,從而幫助我的項目團隊更高效地完成任務,那就是這本書的巨大價值所在。
评分在過去的工作中,我曾多次因為數據庫性能問題而焦頭爛額。尤其是在我們開發的新一代客戶管理係統中,隨著用戶數的增加和數據量的增長,原有的數據庫設計和配置已經無法滿足需求,導緻查詢響應速度緩慢,嚴重影響瞭用戶體驗。我們團隊投入瞭大量精力去優化SQL語句,調整數據庫參數,但效果始終不盡如人意。這種經曆讓我意識到,數據庫性能優化並非簡單的“頭痛醫頭,腳痛醫腳”,而是一個需要係統性、理論性和實踐性相結閤的工程。《DB2數據庫性能調整和優化(第2版)》這本書,正是我一直在尋找的“指南針”。我非常看重書中關於“問題診斷”的章節,希望能夠從中學習到一套科學的方法論,來快速準確地定位數據庫性能瓶頸。例如,如何通過各種監控指標來判斷是CPU、內存、I/O還是鎖的問題,以及如何利用DB2的診斷工具來收集和分析相關信息。此外,我還特彆希望書中能夠深入講解存儲過程和用戶定義函數(UDF)的性能優化技巧,因為這些是我們係統中不可避免的一部分,但往往也是性能問題的重災區。這本書如果能為我提供一些實用的“秘籍”,幫助我成為一名能夠快速解決數據庫性能問題的專傢,那將是對我職業生涯的巨大提升。
评分我所在的電商平颱,在雙十一、618等大型促銷活動期間,數據庫承受的壓力是空前的。以往的經驗告訴我,DB2數據庫的穩定性和性能是整個促銷活動成功的關鍵。我們經常會在這些高峰期遇到各種各樣的問題,例如慢查詢頻發、連接數飆升、甚至數據庫服務不穩定。雖然我們有專業的DBA團隊,但麵對如此巨大的壓力,也常常感到力不從心,需要不斷地進行臨時的調整和優化。《DB2數據庫性能調整和優化(第2版)》這本書,可以說是為我們準備的“應急手冊”和“長期指導”。我非常期待書中能夠提供一些針對高並發、大數據量的場景下的優化策略。例如,在海量交易數據下如何設計高效的索引,如何進行分區錶和分片策略的規劃,以及如何優化事務處理,減少鎖等待。我還希望書中能夠詳細介紹DB2的集群和高可用性方案,以及在這些復雜環境中如何進行性能調優。對於數據庫的容量規劃和未來的性能趨勢預測,也是我非常感興趣的內容。這本書如果能幫助我們提前預判並規避潛在的性能風險,那將極大地提升我們應對大型活動的能力,確保業務的平穩運行。
评分我對DB2數據庫的感情,就像是一個從零開始學習新技能的初學者。在接觸它之前,我主要使用的是另一種主流的數據庫係統,並在那裏積纍瞭一些性能調優的經驗。然而,當我開始接觸DB2平颱,並被要求負責其性能優化工作時,我發現自己麵臨著許多新的挑戰。《DB2數據庫性能調整和優化(第2版)》這本書,就像是我在DB2學習旅途中的一位“良師益友”。我非常期待這本書能夠幫助我建立起一套完整的DB2性能調優知識體係。我希望書中能夠係統地講解DB2的各類性能參數,並詳細說明它們是如何影響數據庫性能的,以及在不同場景下應該如何進行調整。對於如何進行底層的性能分析,比如如何查看係統日誌、性能視圖,以及如何利用Tracing功能來捕獲和分析數據庫的運行細節,也是我非常希望從中學習的。此外,書中關於數據庫安全性和性能之間平衡的討論,以及如何進行數據歸檔和清理以保持數據庫的健康狀態,也對我非常有吸引力。我希望這本書能幫助我從一個“菜鳥”蛻變為一名能夠獨立解決DB2性能問題的“老手”,為我未來的職業發展打下堅實的基礎。
评分作為一名曾經從事過Oracle數據庫管理的工作者,我深知數據庫性能調優的復雜性和重要性。現在轉戰DB2平颱,雖然在基本概念上有一些相似之處,但在具體的實現和優化策略上,我發現DB2有著自己獨特的體係。《DB2數據庫性能調整和優化(第2版)》這本書,對於我這樣一位從其他平颱過來的DBA來說,無疑是一個絕佳的學習機會。我希望這本書能夠幫助我快速理解DB2的架構特點,並與我已有的知識體係進行對接。我特彆想瞭解DB2在內存管理、I/O調度以及查詢優化器方麵與Oracle的主要區彆,以及在這些方麵應該如何進行針對性的調優。書中關於並行處理、分布式數據庫以及大數據集成等高級特性的性能優化,也將是我重點關注的內容。我期望這本書能夠提供一些實用的工具和技巧,幫助我更快地診斷和解決DB2數據庫的性能問題。例如,如何有效地利用DB2的監控工具,如何解讀性能視圖,以及如何對數據庫參數進行精細化的調整,都是我非常希望從中獲得指導的方麵。這本書如果能幫助我成為一名閤格的DB2 DBA,那將是非常有價值的。
评分我是一名在金融行業工作的DB2 DBA,我們負責的交易係統對數據庫性能的要求極高,任何微小的延遲都可能導緻嚴重的後果。之前,我們主要依靠經驗和一些基礎的工具來監控和調整數據庫,但隨著業務復雜度的增加和數據量的爆炸式增長,這種方式顯得越來越力不從心。係統時不時會齣現響應緩慢、甚至宕機的情況,排查起來也非常睏難,常常花費大量時間和精力卻收效甚微。正是抱著解決這些痛點的目的,我購入瞭《DB2數據庫性能調整和優化(第2版)》。這本書的齣現,無疑為我們提供瞭一個更權威、更係統的指導。我注意到書中提到瞭許多我之前從未接觸過的概念和技術,比如“靜默調優”的理念,以及如何通過“工作負載管理”來精細化控製資源分配。這些內容讓我眼前一亮,感覺這本書不僅僅是講解一些簡單的SQL優化技巧,而是從更宏觀、更深層次的角度去探討數據庫的性能問題。我尤其期待書中關於如何識彆和解決“鎖爭用”以及“死鎖”的章節,因為這些是我們係統中最常見也是最棘手的性能問題之一。我還想知道書中是如何講解I/O性能優化的,包括磁盤配置、緩存策略以及如何減少不必要的I/O操作。此外,對於在綫升級和維護過程中如何保證性能穩定性的討論,也將對我日常工作有極大的幫助。
评分在接觸到《DB2數據庫性能調整和優化(第2版)》這本書之前,我對DB2的理解僅停留在基礎的安裝和一些簡單的SQL查詢層麵。我所在的團隊負責維護一套關鍵的業務係統,該係統的數據量逐年增長,用戶量的攀升也帶來瞭巨大的並發壓力,導緻係統響應時間越來越慢,用戶體驗直綫下降。數據庫的性能瓶頸是我們團隊最頭疼的問題。我嘗試過閱讀一些零散的在綫文檔和博客文章,但這些資料往往碎片化,缺乏係統性和深度,很難真正解決我們遇到的實際問題。當我看到這本書的書名時,我的內心燃起瞭希望。一本專注於DB2性能調整和優化的書籍,這正是我和我的團隊急需的。這本書的齣版,可以說是恰逢其時,為我們指明瞭一條走齣睏境的道路。我期待通過閱讀這本書,能夠係統地學習DB2的底層機製,掌握科學的性能分析方法,並找到切實有效的優化手段,從而顯著提升我們係統的運行效率,讓用戶再次感受到流暢的操作體驗。我特彆關心書中關於查詢優化器的工作原理、索引策略的深入講解,以及在復雜查詢場景下如何進行有效的性能診斷和調優。此外,對於參數配置的解釋以及它們對性能的影響,也是我非常關注的重點。我希望能從中學習到如何構建一個高效、穩定的DB2數據庫環境,為業務的持續發展提供堅實的技術支撐。
评分作為一名剛入職的數據庫工程師,我對DB2數據庫的掌握還處於學習階段,尤其是在性能調優這塊,感覺自己像是在黑暗中摸索。我發現很多時候,寫齣來的SQL語句運行效率不高,但又不清楚具體是哪裏齣瞭問題,應該如何改進。網上雖然有很多關於SQL優化的文章,但很多都比較淺顯,或者針對的是其他數據庫係統,對我來說參考價值有限。《DB2數據庫性能調整和優化(第2版)》這本書,在我看來,就像是為我量身定做的一本“武功秘籍”。我非常渴望能夠通過這本書,係統地學習DB2性能調優的理論基礎和實踐方法。我希望書中能詳細解釋SQL語句是如何被DB2處理的,包括查詢重寫、謂詞推斷等過程,並教會我如何利用EXPLAIN PLAN工具來分析查詢的執行計劃,從而找齣性能瓶頸。此外,關於索引的創建、使用和維護,以及如何根據業務場景選擇最閤適的索引類型,也是我非常期待的內容。我希望這本書能提供一些循序漸進的案例,讓我能夠跟著書中的步驟一步步進行實踐,積纍實際操作經驗。對於數據庫參數的深入解讀,以及如何根據不同的硬件環境和業務需求進行配置,也非常吸引我。這本書如果能幫助我構建起一套紮實的性能調優知識體係,那將是我職業生涯中非常寶貴的財富。
评分作為一個在傳統企業IT部門工作的技術人員,我們經常需要維護各種遺留係統,其中不少係統還在使用DB2數據庫。這些係統往往存在一些曆史遺留的性能問題,而由於年代久遠,相關的文檔資料和技術支持也越來越少,使得維護工作變得異常睏難。《DB2數據庫性能調整和優化(第2版)》這本書的齣現,對於我們這樣麵臨挑戰的團隊來說,簡直是雪中送炭。我期待這本書能夠提供一些針對老版本DB2的優化建議,以及如何在不進行大規模係統改造的情況下,最大程度地提升現有數據庫的性能。書中關於數據庫的“健康檢查”和“性能基綫”的建立,將是幫助我們瞭解當前係統狀況的關鍵。我希望能夠學習到如何通過這些方法,發現潛在的性能風險,並製定相應的優化計劃。此外,對於數據庫的備份和恢復策略對性能的影響,以及如何在保證數據安全的前提下,最大程度地縮短備份和恢復時間,也是我非常關心的問題。如果這本書能夠為我們提供一些關於遺留係統性能優化的“實用技巧”和“解決方案”,那將極大地減輕我們團隊的工作負擔,並提升我們對這些關鍵係統的支持能力。
评分 评分 评分 评分 评分相關圖書





本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有