

具体描述
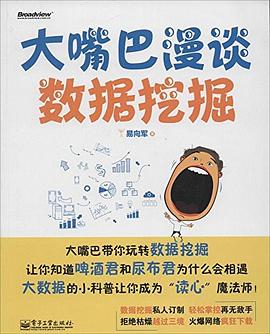
《大嘴巴漫谈数据挖掘(全彩)》从最基本的概率统计学开始,全面、系统、形象而又深入地描述了数据挖掘的基础概念、应用领域以及常用算法。其中每一种数据挖掘算法都辅以通俗易懂的实例,读者能够在直观性、趣味性中学习算法的具体流程,明白算法的实现过程。通过《大嘴巴漫谈数据挖掘(全彩)》的学习,读者可以对数据挖掘的概念、应用和算法技术有一个清晰的理解和认识,并可以熟悉相关统计学的基本原理。
《大嘴巴漫谈数据挖掘(全彩)》适合想从事数据挖掘方面的工作的初学者、数据分析爱好者、分析师,以及一线的数据挖掘开发人员参考阅读,也适合客户经理针对如何开展针对性的营销活动,避免客户流失而阅读学习,更适合产品经理阅读,因为针对如何预测产品的目标用户,促进用户活跃和业务有效使用,靠经验已经不行了,数据才最有说服力,更适合企业管理者将其作为一本通俗易懂的数据挖掘基础读物阅读学习,对下属的工作方向给予指导,以及适合教师学生数据挖掘课程辅导之用。
作者简介
易向军:北京科技大学计算机硕士学历,长期工作于互联网和电信领域,目前创办dazui8.com,致力于数据挖掘知识的宣传推广以及相关技术的研发探索。新浪微博:http://weibo.com/yixiangjun78 @易向军-数据
浅醉斛觞意渐乱,浮生聚散人堪愁
目录信息
第一境昨夜西风凋碧树。独上高楼,望尽天涯路…… /10
1.1数据挖掘简介 / 11
开篇点题引五问 /12
大数据中求价值 /13
定义概述归特点 /14
知识决策跨领域 /15
架构特征多形式 /17
数据立方展多维 /19
功能挖掘四大类 /22
分类刻画类标识 /23
数据聚类辨亲疏 /24
预测未来训模型 /25
关联源自购物篮 /27
模型过程方法论 /28
十大算法成经典 /32
1.2数据挖掘应用 /33
行业推广多应用 /34
用户为王放心中 /36
指导运营全周期 /37
定位目标寻用户 /38
精准营销成闭环 /39
交叉产品有关联 /40
细分用户刻画像 /41
用户体验模型化 /43
指标评测建体系 /44
流失预警保用户 /45
跟踪评估验效果 /47
第二境衣带渐宽终不悔,为伊消得人憔悴…… /48
2.1概率定义 /49
浮生难料尽偶然 /50
一枚硬币抛正反 /51
引出随机小试验 /53
样本空间样本点 /54
事件三分包万象 /55
试验频率需频繁 /58
次数无限值极限 /59
描述概率定特点 /60
古典概型等可能 /61
事件B后A在前 /62
求出概率称条件 /65
独立事件A和B /67
抽签中奖公平性 /71
常用概率两公式 /76
交空并全划样本 /77
综合状态全概率 /78
前因后果贝叶斯 /80
2.2随机变量 /81
随机试验数量化 /82
统计规律双类型 /83
离散变量分布律 /84
硬币抛掷是一零 /85
分布函数连续型 /87
函数求导得密度 /89
高斯分布称正态 /91
标准正态分位点 /95
2.3数字特征 / 98
随机变量有特征 /98
平均取值是期望 /100
方差衡量偏离值 /101
标准开根同量纲 /103
变量关系协方差 /104
相关系数相关度 /105
研究总体要抽样 /108
抽样分布统计量 /109
2.4参数估计 /111
最小二乘估参数 /112
极大似然大概率 /116
区间估计置信度 /119
2.5假设检验 / 123
总体假设来检验 /124
服从正态抽样本 /125
统计量中验假设 /126
弃真取伪两错误 /127
显著检验小概率 /128
小概率中拒绝域 /130
检验流程出决策 /131
已知总体方差值 /132
检验中验均值 /133
第三境众里寻她千百度,蓦然回首,那人却在,灯火阑珊处。 /134
3.1关联规则 / 135
购物篮中找关联 /136
数据事务若干项 /137
事务空间含项集 /138
置信支持提升度 /142
规则源于频繁项 /145
k项连接和剪枝 /146
生成非空规则集 /148
关联效果来评估 /149
3.2决策树 /155
决策思维成树形 /156
分类预测工作流 /161
原理基于信息熵 /162
信息增益条件熵 /164
节点拆分选特征 /170
3.3贝叶斯 /186
预测分类贝叶斯 /187
类别概率要最大 /188
分类数据新预测 /195
3.4聚类分析 / 196
物以类聚人以群 /197
样本变量定矩阵 /198
R型Q型换空间 /199
距离度量相似度 /200
系数聚类统计量 /202
标准样本选欧氏 /203
层次聚合归大类 /205
3.5神经网络 /209
神经网络神经元 /210
神经元中有加权 /211
输入映射输出层 /213
求出误差调参数 /214
权重偏置学习率 /216
实例分析模型流 /217
3.6线性回归 /222
研究身高引回归 /223
单自变量归一元 /224
最小二乘估回归 /226
数据差异总离差 /228
分为解释和误差 /229
判定系数拟合度 /230
多元回归建方程 /231
回归面中展二元 /233
求得回归系数解 /234
衡量拟合验效果 /236
3.7逻辑回归 /237
因变量中二分类 /238
二项逻辑回归式 /240
极大似然解方程 /242
预测分类符合率 /244
3.8因子分析 /245
相关变量纳因子 /246
因子构造筑模型 /248
因子载荷统计性 /251
衡量信息共同度 /252
方差贡献重要性 /253
因子分析四步曲 /254
构造因子求载荷 /255
旋转因子得命名 /260
因子组合求得分 /265
3.9信度分析 /268
设计问卷来调研 /269
信度检验可靠性 /270
3.10效度分析 /272
结构方程协方差 /273
测量模型内外生 /276
结构模型潜变量 /279
效度分析路径图 /280
提出假设依理论 /281
固定负荷识模型 /282
相关阵中估参数 /283
· · · · · · (收起)
读后感
首先,我想说那些觉得这本书没有用之类的评价,有的人还觉得上大学没用呢,价值是要靠自己发现的。一开始我也是大致的看了一下,觉得也就这样,可是后来真正静下心来细读的时候发现还是有很多亮点的,有一句话叫:讲师是把简单的东西说复杂,而教授是把复杂的东西说简单。这本...
评分《大嘴巴漫谈数据挖掘》的草稿在网上看到过,而出版的版本是经过进一步完善和优化的。当时就觉得,作者能够以轻松、形象、通俗的方式把枯燥的数据挖掘方法和知识惟妙惟肖地传达出来,真的很厉害。从这本书,每个人都可以一窥神圣的数据挖掘殿堂,数据挖掘把其神奇魅力展露出来...
评分《大嘴巴漫谈数据挖掘》,这是我见过的少有的数据挖掘理论以“漫画”的形式阐述的数据挖掘、数据分析、机器学习一类的书。书中全彩印刷,案例丰富,语言通俗有趣,结构设计合理,引导读者思考。内容嘛,从最基本的概率统计学开始介绍,对数据挖掘的基础概念、应用领域以及常用...
评分首先,我想说那些觉得这本书没有用之类的评价,有的人还觉得上大学没用呢,价值是要靠自己发现的。一开始我也是大致的看了一下,觉得也就这样,可是后来真正静下心来细读的时候发现还是有很多亮点的,有一句话叫:讲师是把简单的东西说复杂,而教授是把复杂的东西说简单。这本...
评分首先,我想说那些觉得这本书没有用之类的评价,有的人还觉得上大学没用呢,价值是要靠自己发现的。一开始我也是大致的看了一下,觉得也就这样,可是后来真正静下心来细读的时候发现还是有很多亮点的,有一句话叫:讲师是把简单的东西说复杂,而教授是把复杂的东西说简单。这本...
用户评价
这本书的语言风格变化多端,时而像一位睿智的老者娓娓道来,时而又像一位充满激情的创业者在做路演,这种动态的语调变化成功地避免了长时间阅读带来的审美疲劳。我尤其注意到作者在描述一些复杂的统计学假设时,会突然插入一段非常幽默的自嘲或者一个与数据毫不相干的典故来做类比,这种“跑题式”的解释反而成了最有效的记忆锚点。比如,它在解释假设检验的P值时,竟然扯到了一个古代的占卜仪式,虽然看似风马牛不相及,但通过那种对不确定性的处理方式,我对P值的实际意义的理解瞬间清晰了许多。这种打破常规的教学方法,体现了作者深厚的文化底蕴和极强的表达欲。它成功地将数据科学从冰冷的实验室中解放出来,变成了一种充满生活气息和人性思考的实践活动。对于那些在学习过程中容易感到枯燥或挫败感的读者来说,这本书的陪伴感极强,它就像一个耐心且风趣的伙伴,推着你向前走,却又不让你觉得压力山大。它真正做到了让读者“爱上”学习数据挖掘的过程,而不仅仅是关注最终的结果。
评分这本书的章节组织结构非常流畅,它不是严格按照“入门、进阶、高阶”的线性模式展开,而是采取了一种螺旋上升的叙事方法。你可能在第二章学到了一个基础概念,但它在第十章又以一个更复杂的应用场景被重新提及并加深理解,这种设计极大地帮助了知识点的内化和记忆。我个人很喜欢它在每个主要技术模块后附带的“反思时间”小节,里面常常是作者对某个技术流派的犀利点评或者对未来发展方向的预测。例如,它对“大数据万能论”的质疑,以及对小样本学习(Few-Shot Learning)潜力的提前布局,都显示出作者对行业动态的敏锐洞察力。更令人称道的是,书中虽然没有直接给出大量的代码实操环节,但它对每种算法的数学直觉的解释,已经足够让你在面对具体编程实现时,能够快速定位问题和调整参数。它教的不是“怎么按按钮”,而是“为什么这个按钮是这样设计的”。这种注重底层逻辑和设计哲学的讲解方式,极大地提升了读者的底层能力,使得我们未来在学习具体框架和工具时,可以做到举一反三,触类旁通。
评分我特别欣赏作者在讨论伦理和隐私保护时的那种审慎和严肃态度,这部分内容处理得非常到位,不像很多技术书籍为了追求“酷炫”而略过这些重要的社会责任议题。书中提到了一些经典的案例,关于数据偏见如何被无意中放大,以及算法决策可能带来的社会不公,这些案例的选取角度非常刁钻,不是那种人尽皆知的教科书案例,而是更贴近当下热点和未来趋势的争议点。这种前瞻性视角让我意识到,数据挖掘不仅仅是技术游戏,它更是一种权力的体现,必须戴着镣铐跳舞。阅读过程中,我多次停下来思考,作者是如何将这些法律条文和行业规范,巧妙地融入到技术讲解的语境中去的。它不是在说教,而是通过案例分析,自然而然地引导读者形成一种“负责任的实践者”的身份认同。对于那些计划将数据挖掘技术应用于金融、医疗或公共服务领域的读者来说,这本书提供的风险预警和合规性思考,其重要性甚至超过了对最新模型迭代的掌握。这种深层次的人文关怀,让整本书的格调瞬间提升了一个层次。
评分这本书的封面设计相当抓人眼球,那种带着点复古未来主义的插画风格,一下子就把我对“数据挖掘”这个略显严肃的主题的好奇心给勾起来了。我通常对那种堆砌着晦涩公式和复杂算法的书籍敬而远之,但《大嘴巴漫谈数据挖掘》的标题就透露出一种亲切和放松的姿态,仿佛作者不是要给我上枯燥的课,而是准备在一家舒适的咖啡馆里,边喝咖啡边跟我聊聊这个圈子的内幕和乐趣。我希望它能真正做到“漫谈”,而不是那种一本正经的教科书腔调。尤其是“大嘴巴”这三个字,暗示着或许会有不少行业轶事、失败教训或者一些只有圈内人懂的幽默感。我很期待作者如何将那些看似高冷的数学原理,用大白话讲得生动有趣,比如用日常生活中的例子来解释K-Means聚类或者决策树的构建过程。如果它能成功地平衡学术的严谨性和表达的通俗性,那么对于我这种半路出家想了解数据全貌的非科班出身人士来说,简直就是救星。我关注的重点在于,它是否能建立起一个清晰的认知框架,让我明白数据挖掘到底解决了什么问题,而不是仅仅停留在技术名词的罗列上。从排版和字体选择上看,这本书似乎也下了一番功夫,不像有些技术书那样密密麻麻让人望而生畏,这至少让我翻开它的第一印象是积极的。
评分这本书的深度似乎处在一个非常微妙的平衡点上,它没有直接深入到那些令人头疼的矩阵运算或者高级的深度学习模型架构,反而更像是一本“扫盲指南”和“思想启蒙录”。我花了大量时间研究了它对数据生命周期各个环节的描述,尤其是数据清洗和特征工程的部分,作者用一种近乎哲学思辨的方式探讨了“什么是好的数据”以及“噪音的价值”。这让我开始重新审视自己过去处理数据时那些凭直觉进行的粗暴操作。评价一个工具的好坏,往往取决于使用它的人对底层的理解程度,这本书显然在这方面下了苦功。它没有急于展示炫酷的模型效果,而是花了好几章篇幅来讨论商业目标与数据科学的对齐问题,这一点极其宝贵。在实际工作中,最大的挑战往往不是算法不够先进,而是我们不知道该用什么算法去解决老板真正关心的问题。如果这本书能帮助读者构建起一套从商业痛点到技术实施的完整思考路径,那么它的价值就远远超出了单纯的技术手册范畴,更像是一份高级的项目经理的实战手册。它那种“慢工出细活”的叙事节奏,让我感到十分踏实,仿佛在跟一位经验丰富、阅尽千帆的导师对话。
评分科普挺好玩的。闲着无聊翻翻。但只能作为有一定基础的同学温习作用。
评分谨慎怀疑这本书是用PPT做的;比预想的好
评分适合数据挖掘入门,图非常多,作者讲的也很生动形象,语言朴实,正如书名所言,这是“大嘴巴漫谈”,灰常不错。用于学习数据挖掘基础非常好的一本书。
评分这书最终还是囫囵吞枣看了,可以看出作者很努力地在严谨和易懂之间做权衡,但是我还是建议作者在介绍每个经典算法之前给出更易懂的实际使用案例和一些概念比喻。我想,作者会不会是太执着在图例上,而忽视了语言上的简化呢?(尤其在本书的后半段)
评分读完唯一价值就是知道了:一本垃圾书!有人给四星瞎了吗?
相关图书




本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有