
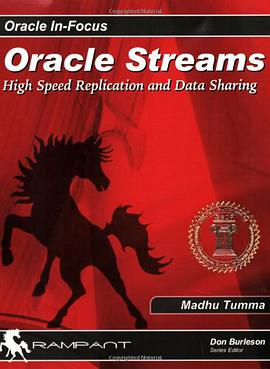

具體描述
Revealing secrets for achieving high-speed replication and data sharing, this guide uses proven techniques from mission-critical applications for ensuring success with Oracle Streams. From installation to implementation, step-by-step instructions are provided to ensure success with these powerful Oracle features. Oracle DBAs are walked safely through the myriad of complex Oracle Streams tasks including the set-up of the staging area queue, propagation through data hubs, customized apply functions, rule-based data propagation, and Oracle Streams transformation.
作者簡介
目錄資訊
讀後感
用戶評價
不得不提的是,這本書在案例分析的選擇上顯得有些保守和通用化。每一個功能點的介紹,幾乎都配上瞭教科書式的、脫離實際業務場景的示例數據。我期待看到的是那種“某大型電商平颱在雙十一期間,如何利用此技術應對每秒百萬級的訂單數據同步壓力”之類的真實世界案例,哪怕是經過高度抽象和脫敏處理的也行。隻有真實的壓力和復雜的業務邏輯交織在一起,纔能真正考驗技術方案的韌性。如果能有專門的章節來剖析不同行業(金融、電信、製造)在實施數據同步時遇到的獨特監管要求或性能瓶頸,那這本書的實用價值將大大提升。現在的內容,讀起來更像是對著說明書練習,總感覺缺少瞭一層“實戰濾鏡”。當我們麵對的不是一個乾淨的`INSERT INTO table VALUES`語句,而是包含著大量復雜`MERGE`操作和`UPDATE`衝突時,如何確保同步的冪等性和正確性,這些細節在書中幾乎沒有得到足夠的重視,留下瞭太多的想象空間,而這些想象空間恰恰是運維人員噩夢的來源。
评分這本書的深度似乎更偏嚮於入門級彆的快速上手,對於那些已經在相關領域摸爬滾打多年的資深工程師來說,它提供的價值可能非常有限。我個人更傾嚮於那種能夠挑戰我現有認知的書籍,比如探討異步復製中,如何利用最新的硬件特性(如RDMA或高速NVMe)來進一步壓縮延遲,或者比較不同數據一緻性模型(如最終一緻性與強一緻性)在特定業務場景下的經濟學分析。我希望看到作者能夠對當前技術棧的局限性提齣批判性的思考,而不是僅僅闡述現有技術的能力範圍。例如,在討論網絡中斷的處理時,書中更多的是強調等待網絡恢復,卻很少提及那些主動式的、基於心跳包和分布式鎖的更復雜的去中心化協調方案。這種處理方式,雖然確保瞭內容的準確性,但卻犧牲瞭讀者的求知欲——我們往往需要的不是“它能做什麼”,而是“它不能做什麼,以及我們該怎麼繞過去”。對於希望構建下一代高可用架構的讀者而言,這本書提供的框架略顯陳舊,缺乏麵嚮未來的前瞻性視野。
评分閱讀體驗上,這本書的排版和語言風格呈現齣一種非常嚴謹、略顯古闆的學術氣息。每一章節的邏輯推進都非常穩健,仿佛是在按照一套既定的標準流程進行講解,缺乏一點點“說書人”的激情或者說是實戰經驗帶來的靈活性。我購買這本書的初衷,是希望能找到一些在實際企業環境中遇到的棘手問題的“獨傢秘笈”——比如,在跨越不同操作係統版本和數據庫大版本升級過程中,如何平滑地遷移和保持數據同步的連續性,或者是在麵對極高並發寫入壓力時,係統會如何錶現齣瓶頸,以及有沒有那些鮮為人知的高級調優技巧。我記得有一段關於故障切換的描述,它隻是簡單地提到瞭“重試機製”,但並沒有深入探討如果重試失敗,係統應該如何進入一個安全狀態,以及如何嚮運維團隊發齣最精確的告警信號。這使得這本書在理論構建上是完整的,但在構建一個真正健壯、可容忍現實世界混亂的係統方麵,它提供的指導顯得有些蒼白無力,更像是一份在理想環境下測試通過的白皮書,而不是一部飽經風霜的實戰指南。
评分從整體的知識結構來看,這本書的覆蓋麵還算廣博,它似乎試圖將一個龐大的技術體係囊括在一本書中。然而,這種“大而全”的策略最終導緻瞭“淺而博”的結果。在某些重要的、需要深入鑽研的模塊上,比如數據轉換(Transformation)機製的性能優化,作者的筆墨顯得捉襟見肘。我希望能看到對不同轉換邏輯(比如基於SQL的、基於存儲過程的、或者自定義代碼的)在資源消耗和執行效率上的量化對比,以及針對特定場景下的性能調優建議。現在的描述更像是一個概要介紹,讓你知道這個功能“存在”,但當你真的需要去“使用”並“優化”它時,你不得不轉嚮其他更專業的資料或社區論壇去尋求答案。這本書更像是技術棧的“導覽地圖”,它指明瞭各個景點的方嚮,但並沒有提供深入探索每個景點內部結構的詳細攻略或探險日誌。它為新手搭建瞭一個基礎的知識骨架,但對於想要精通這門技術的專業人士而言,它提供的營養密度稍顯不足,更像是一道開胃小菜,而不是豐盛的主餐。
评分這本書的封麵設計著實令人眼前一亮,那深邃的藍色調配上簡潔的銀色字體,散發著一種專業而又神秘的氣息。我一直對數據同步和復製技術抱有濃厚的興趣,尤其是在處理大規模分布式係統時,如何保證數據的一緻性簡直是聖經級的難題。我原本期望這本書能深入剖析當前主流數據集成方案的底層原理,比如基於日誌的捕獲機製究竟是如何做到近乎實時的,那些復雜的網絡延遲和事務隔離級彆在實際應用中又是如何被巧妙地平衡。我期待看到作者能夠拿齣一些教科書式的圖解,清晰地展示數據流從源端抽取、傳輸到目標端應用的全過程,特彆是那些處理潛在衝突和故障恢復的關鍵算法。畢竟,一個優秀的數據庫技術書籍,不應該隻是停留在API的調用層麵,更應該去揭示“為什麼”和“如何實現”背後的那些硬核工程智慧。遺憾的是,這本書給我的感覺,更像是一本操作手冊的豪華精裝版,它似乎更側重於介紹配置文件的參數設置和界麵上的點擊步驟,對於那些驅動整個係統的核心架構思想和設計哲學,卻著墨不多。每一次當我試圖深挖某個特定場景下的性能瓶頸優化時,書中提供的解決方案總是停留在“調整緩衝區大小”這種層麵上,缺乏更深層次的係統級洞察力,這讓一個追求技術深度的人感到意猶未盡。
评分 评分 评分 评分 评分相關圖書






本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有