
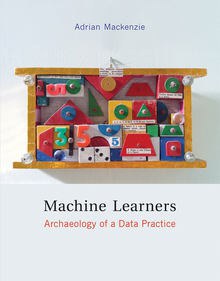

具体描述
Machine learning—programming computers to learn from data—has spread across scientific disciplines, media, entertainment, and government. Medical research, autonomous vehicles, credit transaction processing, computer gaming, recommendation systems, finance, surveillance, and robotics use machine learning. Machine learning devices (sometimes understood as scientific models, sometimes as operational algorithms) anchor the field of data science. They have also become mundane mechanisms deeply embedded in a variety of systems and gadgets. In contexts from the everyday to the esoteric, machine learning is said to transform the nature of knowledge. In this book, Adrian Mackenzie investigates whether machine learning also transforms the practice of critical thinking.
Mackenzie focuses on machine learners—either humans and machines or human-machine relations—situated among settings, data, and devices. The settings range from fMRI to Facebook; the data anything from cat images to DNA sequences; the devices include neural networks, support vector machines, and decision trees. He examines specific learning algorithms—writing code and writing about code—and develops an archaeology of operations that, following Foucault, views machine learning as a form of knowledge production and a strategy of power. Exploring layers of abstraction, data infrastructures, coding practices, diagrams, mathematical formalisms, and the social organization of machine learning, Mackenzie traces the mostly invisible architecture of one of the central zones of contemporary technological cultures.
Mackenzie’s account of machine learning locates places in which a sense of agency can take root. His archaeology of the operational formation of machine learning does not unearth the footprint of a strategic monolith but reveals the local tributaries of force that feed into the generalization and plurality of the field.
作者简介
Adrian Mackenzie is Professor of Technological Cultures in the Department of Sociology at Lancaster University and the author of Wirelessness: Radical Empiricism in Network Cultures (MIT Press).
目录信息
读后感
用户评价
自从翻开《Machine Learners》这本书,我感觉自己仿佛被带入了一个充满无限可能的智能世界。这本书最让我赞叹的是,它能够将一些原本听起来极其复杂的概念,用一种非常易于理解和消化的方式呈现出来。作者并没有一开始就扔出大量的数学公式,而是从一个又一个贴近生活的案例入手,比如如何利用机器学习来预测股票的涨跌,或者如何让机器学会识别用户的情感倾向。这种循序渐进的学习方式,让我这个对机器学习了解不多的读者,也能很快地跟上节奏,并且充满了探索的乐趣。 书中对于“特征工程”的深入剖析,对我来说简直是一次“醍醐灌顶”。我之前总以为,只要把数据喂给模型就行了,但这本书让我明白,好的特征往往比复杂的模型更能决定最终的预测结果。作者详细讲解了如何从原始数据中提取有用的信息,如何处理文本、图像、时间序列等不同类型的数据,以及如何创建新的、更有预测能力的特征。这让我看到了,数据科学家真正的价值,往往体现在对数据的洞察力和创造力上。 我尤其喜欢书中关于“模型选择”的章节。作者并没有给出“一刀切”的建议,而是强调了根据不同的问题类型、数据特征和业务目标,来选择最适合的模型。他详细对比了各种主流算法的优缺点,比如线性模型、树模型、神经网络等等,并结合实际案例,讲解了如何在不同的场景下做出明智的选择。这让我明白,机器学习并非是一个“万能工具箱”,而是需要根据具体情况来灵活运用。 《Machine Learners》在探讨“模型可解释性”方面,也做得非常出色。在当今社会,AI的应用越来越广泛,但我们常常会因为无法理解模型的决策过程而对其产生疑虑。这本书给了我很大的启发,作者介绍了像LIME和SHAP这样的先进技术,并详细解释了它们如何帮助我们理解那些复杂的“黑箱”模型。这不仅增加了我对AI的信任度,也为我今后在实际工作中应用AI打下了坚实的基础。 书中关于“模型评估”的讲解,也让我受益匪浅。我之前总是陷入各种评估指标的困惑之中,不知道在什么情况下应该选择哪一个。但《Machine Learners》通过对不同业务场景的深入分析,让我明白了各种指标的含义以及它们之间的权衡关系。作者用生动的例子,比如在欺诈检测和用户推荐中,精确率和召回率的重要性是截然不同的,这让我对如何科学地评估模型有了更深刻的理解。 我不得不提的是,书中对“数据偏差”问题的讨论,让我对机器学习的公平性和伦理有了更深的认识。作者非常坦诚地指出了,现实世界中的数据往往存在各种各样的偏差,而这些偏差会对模型的公平性和准确性产生严重的影响。他详细讲解了如何识别数据偏差,以及如何采取相应的技术手段来减轻这些偏差带来的负面影响。这让我认识到,做一个负责任的机器学习工程师,不仅要追求模型的性能,更要关注其潜在的社会影响。 《Machine Learners》在介绍“集成学习”时,也让我看到了机器学习的巨大潜力。我之前只知道“随机森林”这个名字,但通过这本书的深入解析,我才真正理解了“集百家之长”的威力。作者不仅解释了bagging和boosting等基本思想,还深入剖析了XGBoost等明星算法的内部机制。这让我看到了,通过巧妙地组合多个弱学习器,可以构建出超越任何单一模型的强大预测能力。 我特别喜欢作者在书中对“模型部署”和“模型监控”的关注。很多机器学习的书籍都止步于模型训练,但《Machine Learners》却进一步探讨了如何将训练好的模型应用到实际生产环境中,以及如何对其进行长期的监控和维护。这让我看到了机器学习的完整生命周期,也为我今后的职业发展提供了更全面的视野。 书中关于“迁移学习”和“少样本学习”的介绍,也让我看到了机器学习的未来发展方向。我意识到,AI的学习能力并非总是从零开始,而是可以借鉴已有的知识来加速学习新任务。这让我对AI的学习效率和应用范围有了更深刻的认识,也让我对未来的AI发展充满了期待。 总而言之,《Machine Learners》是一本让我受益匪浅的书。它不仅为我打下了坚实的机器学习理论基础,更重要的是,它培养了我解决实际问题的能力和对这个领域的浓厚兴趣。我能够感受到作者在编写这本书时投入的心血,他用清晰的语言、丰富的案例和深刻的洞察力,将一个复杂的主题变得如此易于理解。我强烈推荐这本书给任何对机器学习感兴趣的朋友,无论你是初学者还是希望系统梳理知识的进阶者,相信这本书都会给你带来巨大的启发。
评分最近一口气读完了《Machine Learners》,这本书在我心中留下了极其深刻的印象。它不仅仅是一本介绍机器学习技术的书籍,更像是一次对人工智能思维的深度探索。作者的写作风格非常具有感染力,他能够将那些听起来高不可攀的算法,用一种非常接地气的方式娓娓道来。我尤其喜欢他关于“无监督学习”的讲解,通过对聚类算法的生动比喻,让我一下子就明白了如何从海量数据中发现隐藏的模式。 书中对于“特征工程”的探讨,是我之前阅读过的任何书籍都无法比拟的。我曾经以为,特征工程就是简单的对数据进行一些变换,但《Machine Learners》让我明白,它更像是一种艺术,需要对业务有深入的理解,并能够从数据中提炼出真正有价值的信息。作者详细讲解了如何创建交互特征、如何进行多项式特征的扩展,甚至是如何从文本数据中提取出有意义的特征。这让我看到了,数据科学家真正的价值,往往体现在对特征的洞察力上。 我特别欣赏书中关于“模型评估”的章节。作者并没有简单地介绍各种评估指标,而是深入分析了它们在不同场景下的适用性。比如,在医疗诊断中,召回率的重要性可能远高于精确率,而在垃圾邮件过滤中,精确率则更为关键。这种 nuanced 的分析,让我对如何科学地评估模型有了更深刻的理解,也为我今后在实际项目中选择合适的评估体系提供了指导。 《Machine Learners》在探讨“模型可解释性”方面,也做得非常出色。在当今社会,AI的应用越来越广泛,但我们常常会因为无法理解模型的决策过程而对其产生疑虑。这本书给了我很大的启发,作者介绍了像LIME和SHAP这样的先进技术,并详细解释了它们如何帮助我们理解那些复杂的“黑箱”模型。这不仅增加了我对AI的信任度,也为我今后在实际工作中应用AI打下了坚实的基础。 书中关于“模型选择”的讲解,也让我受益匪浅。作者并没有给出“一刀切”的建议,而是强调了根据不同的问题类型、数据特征和业务目标,来选择最适合的模型。他详细对比了各种主流算法的优缺点,比如线性模型、树模型、神经网络等等,并结合实际案例,讲解了如何在不同的场景下做出明智的选择。这让我明白,机器学习并非是一个“万能工具箱”,而是需要根据具体情况来灵活运用。 《Machine Learners》在探讨“模型局限性”和“潜在风险”方面,也表现出了极高的专业性和负责任的态度。它并没有过度宣传机器学习的“神奇”之处,而是理性地分析了在实际应用中可能遇到的各种困难,比如数据偏差、算法本身的局限性、以及对计算资源的要求等。这种务实的态度,让我能够建立一个更加 realistic 的关于机器学习的认知,而不是被一些过度乐观的宣传所误导。 书中关于“集成学习”的讲解,也让我看到了机器学习的巨大潜力。我之前只知道“随机森林”这个名字,但通过这本书的深入解析,我才真正理解了“集百家之长”的威力。作者不仅解释了bagging和boosting等基本思想,还深入剖析了XGBoost等明星算法的内部机制。这让我看到了,通过巧妙地组合多个弱学习器,可以构建出超越任何单一模型的强大预测能力。 我特别喜欢作者在书中对“模型部署”和“模型监控”的关注。很多机器学习的书籍都止步于模型训练,但《Machine Learners》却进一步探讨了如何将训练好的模型应用到实际生产环境中,以及如何对其进行长期的监控和维护。这让我看到了机器学习的完整生命周期,也为我今后的职业发展提供了更全面的视野。 书中关于“迁移学习”和“少样本学习”的介绍,也让我看到了机器学习的未来发展方向。我意识到,AI的学习能力并非总是从零开始,而是可以借鉴已有的知识来加速学习新任务。这让我对AI的学习效率和应用范围有了更深刻的认识,也让我对未来的AI发展充满了期待。 总而言之,《Machine Learners》是一本让我受益匪浅的书。它不仅为我打下了坚实的机器学习理论基础,更重要的是,它培养了我解决实际问题的能力和对这个领域的浓厚兴趣。我能够感受到作者在编写这本书时投入的心血,他用清晰的语言、丰富的案例和深刻的洞察力,将一个复杂的主题变得如此易于理解。我强烈推荐这本书给任何对机器学习感兴趣的朋友,无论你是初学者还是希望系统梳理知识的进阶者,相信这本书都会给你带来巨大的启发。
评分我最近一口气读完了《Machine Learners》,这本书给我的感觉就像是为我量身定制的一份机器学习入门到进阶的完整指南。作者以一种非常直观的方式,将那些原本抽象的技术概念,通过丰富的图示和生动的案例,变得触手可及。我尤其喜欢书中对“数据清洗”和“特征提取”的讲解,他并没有停留在理论层面,而是给出了大量可操作的技巧,让我能够立刻将学到的知识应用到实际的数据处理中,这对于我这样的实践者来说,简直是太有价值了。 书中对“模型评估”的讲解,让我豁然开朗。我之前总是对各种评估指标感到迷茫,不知道在什么情况下应该关注哪个指标。《Machine Learners》通过对不同应用场景的深入分析,让我明白了精确率、召回率、F1分数等等之间的权衡关系,以及如何根据具体的业务需求来选择最合适的评估体系。这就像是在一个复杂迷宫中,给我指明了方向,让我不再盲目地追求某个单一的指标。 《Machine Learners》在“特征工程”方面的阐述,是我之前阅读过的任何书籍都无法比拟的。我曾经以为,特征工程就是简单的对数据进行一些变换,但这本书让我明白,它更像是一种艺术,需要对业务有深入的理解,并能够从数据中提炼出真正有价值的信息。作者详细讲解了如何创建交互特征、如何进行多项式特征的扩展,甚至是如何从文本数据中提取出有意义的特征。这让我看到了,数据科学家真正的价值,往往体现在对特征的洞察力上。 我不得不特别强调书中关于“模型可解释性”的部分。在当今社会,AI的应用越来越广泛,但我们常常会因为无法理解模型的决策过程而对其产生疑虑。《Machine Learners》给了我很大的启发,作者介绍了像LIME和SHAP这样的先进技术,并详细解释了它们如何帮助我们理解那些复杂的“黑箱”模型。这不仅增加了我对AI的信任度,也为我今后在实际工作中应用AI打下了坚实的基础。 书中关于“模型选择”的讲解,也让我受益匪浅。作者并没有给出“一刀切”的建议,而是强调了根据不同的问题类型、数据特征和业务目标,来选择最适合的模型。他详细对比了各种主流算法的优缺点,比如线性模型、树模型、神经网络等等,并结合实际案例,讲解了如何在不同的场景下做出明智的选择。这让我明白,机器学习并非是一个“万能工具箱”,而是需要根据具体情况来灵活运用。 《Machine Learners》在探讨“模型局限性”和“潜在风险”方面,也表现出了极高的专业性和负责任的态度。它并没有过度宣传机器学习的“神奇”之处,而是理性地分析了在实际应用中可能遇到的各种困难,比如数据偏差、算法本身的局限性、以及对计算资源的要求等。这种务实的态度,让我能够建立一个更加 realistic 的关于机器学习的认知,而不是被一些过度乐观的宣传所误导。 书中关于“集成学习”的讲解,也让我看到了机器学习的巨大潜力。我之前只知道“随机森林”这个名字,但通过这本书的深入解析,我才真正理解了“集百家之长”的威力。作者不仅解释了bagging和boosting等基本思想,还深入剖析了XGBoost等明星算法的内部机制。这让我看到了,通过巧妙地组合多个弱学习器,可以构建出超越任何单一模型的强大预测能力。 我特别喜欢作者在书中对“模型部署”和“模型监控”的关注。很多机器学习的书籍都止步于模型训练,但《Machine Learners》却进一步探讨了如何将训练好的模型应用到实际生产环境中,以及如何对其进行长期的监控和维护。这让我看到了机器学习的完整生命周期,也为我今后的职业发展提供了更全面的视野。 书中关于“迁移学习”和“少样本学习”的介绍,也让我看到了机器学习的未来发展方向。我意识到,AI的学习能力并非总是从零开始,而是可以借鉴已有的知识来加速学习新任务。这让我对AI的学习效率和应用范围有了更深刻的认识,也让我对未来的AI发展充满了期待。 总而言之,《Machine Learners》是一本让我受益匪浅的书。它不仅为我打下了坚实的机器学习理论基础,更重要的是,它培养了我解决实际问题的能力和对这个领域的浓厚兴趣。我能够感受到作者在编写这本书时投入的心血,他用清晰的语言、丰富的案例和深刻的洞察力,将一个复杂的主题变得如此易于理解。我强烈推荐这本书给任何对机器学习感兴趣的朋友,无论你是初学者还是希望系统梳理知识的进阶者,相信这本书都会给你带来巨大的启发。
评分阅读《Machine Learners》的过程,对我来说是一次非常愉快的认知升级。我一直对机器学习充满好奇,但市面上很多书籍要么过于理论化,要么过于 superficial,很难找到一本既能深入讲解原理,又能提供实践指导的书籍。而《Machine Learners》恰恰填补了我的这个需求。作者的讲解风格非常平易近人,他并没有一开始就抛出大量艰涩的数学公式,而是从一些非常生动有趣的例子入手,比如如何训练一个能够区分猫狗的图像识别模型,或者如何利用机器学习来预测房屋的价格。 书中对于“特征工程”的详细论述,简直是打开了我对数据处理的新视角。我之前一直以为,数据的质量好坏直接取决于收集数据的过程,但《Machine Learners》让我意识到,即使是原始数据,通过精心的特征工程,也能挖掘出巨大的潜力。作者讲解了如何处理缺失值、如何进行特征编码、如何创建交互特征等等,这些技巧都非常有实践价值,让我能够更好地理解和利用数据。 我特别欣赏书中关于“模型评估”的章节。作者并没有简单地介绍各种评估指标,而是深入分析了它们在不同场景下的适用性。比如,在医疗诊断中,召回率的重要性可能远高于精确率,而在垃圾邮件过滤中,精确率则更为关键。这种 nuanced 的分析,让我对如何科学地评估模型有了更深刻的理解,也为我今后在实际项目中选择合适的评估体系提供了指导。 《Machine Learners》在探讨“模型可解释性”方面,也做得非常出色。在当今社会,AI的应用越来越广泛,但我们常常会因为无法理解模型的决策过程而对其产生疑虑。这本书给了我很大的启发,作者介绍了像LIME和SHAP这样的先进技术,并详细解释了它们如何帮助我们理解那些复杂的“黑箱”模型。这不仅增加了我对AI的信任度,也为我今后在实际工作中应用AI打下了坚实的基础。 书中关于“模型选择”的讲解,也让我受益匪浅。作者并没有给出“一刀切”的建议,而是强调了根据不同的问题类型、数据特征和业务目标,来选择最适合的模型。他详细对比了各种主流算法的优缺点,比如线性模型、树模型、神经网络等等,并结合实际案例,讲解了如何在不同的场景下做出明智的选择。这让我明白,机器学习并非是一个“万能工具箱”,而是需要根据具体情况来灵活运用。 《Machine Learners》在探讨“模型局限性”和“潜在风险”方面,也表现出了极高的专业性和负责任的态度。它并没有过度宣传机器学习的“神奇”之处,而是理性地分析了在实际应用中可能遇到的各种困难,比如数据偏差、算法本身的局限性、以及对计算资源的要求等。这种务实的态度,让我能够建立一个更加 realistic 的关于机器学习的认知,而不是被一些过度乐观的宣传所误导。 书中关于“集成学习”的讲解,也让我看到了机器学习的巨大潜力。我之前只知道“随机森林”这个名字,但通过这本书的深入解析,我才真正理解了“集百家之长”的威力。作者不仅解释了bagging和boosting等基本思想,还深入剖析了XGBoost等明星算法的内部机制。这让我看到了,通过巧妙地组合多个弱学习器,可以构建出超越任何单一模型的强大预测能力。 我特别喜欢作者在书中对“模型部署”和“模型监控”的关注。很多机器学习的书籍都止步于模型训练,但《Machine Learners》却进一步探讨了如何将训练好的模型应用到实际生产环境中,以及如何对其进行长期的监控和维护。这让我看到了机器学习的完整生命周期,也为我今后的职业发展提供了更全面的视野。 书中关于“迁移学习”和“少样本学习”的介绍,也让我看到了机器学习的未来发展方向。我意识到,AI的学习能力并非总是从零开始,而是可以借鉴已有的知识来加速学习新任务。这让我对AI的学习效率和应用范围有了更深刻的认识,也让我对未来的AI发展充满了期待。 总而言之,《Machine Learners》是一本让我受益匪浅的书。它不仅为我打下了坚实的机器学习理论基础,更重要的是,它培养了我解决实际问题的能力和对这个领域的浓厚兴趣。我能够感受到作者在编写这本书时投入的心血,他用清晰的语言、丰富的案例和深刻的洞察力,将一个复杂的主题变得如此易于理解。我强烈推荐这本书给任何对机器学习感兴趣的朋友,无论你是初学者还是希望系统梳理知识的进阶者,相信这本书都会给你带来巨大的启发。
评分自从我开始阅读《Machine Learners》以来,我的思维方式似乎被彻底地重塑了。我一直对人工智能充满好奇,但总觉得它是一个遥不可及的概念,直到这本书的出现,才让我真切地感受到,原来那些强大的AI背后,有着如此清晰的逻辑和可循的路径。书中对于各个算法的讲解,不是那种枯燥乏味的定义罗列,而是通过层层递进的方式,将复杂的数学原理巧妙地融入其中。我尤其喜欢作者在讲解“梯度下降”时,那种如同引导徒步登山的细腻指导,一步步地帮助我理解如何找到函数的最小值。 书中对现实世界中数据问题的处理,可以说是这本书的一大亮点。我之前一直以为,只要有了大量数据,机器学习模型就能自动变得聪明,但《Machine Learners》让我明白,数据的质量和结构的合理性才是关键。作者详细介绍了如何识别数据中的偏差,以及如何通过各种技术来清洗和转换数据,使其能够被模型更好地理解和利用。他用“垃圾进,垃圾出”的生动比喻,让我深刻地认识到数据预处理的重要性,这绝对是我在其他地方学不到的宝贵经验。 我必须提到书中关于“特征工程”的章节,它简直是打开了我对机器学习认识的新维度。我之前总是在纠结于选择多么复杂的模型,但作者却强调,很多时候,从原始数据中提取出有意义的特征,比花费大量时间去调优一个不合适的模型更为重要。他通过一些具体的例子,展示了如何将看似无关的数据点组合成具有强大预测能力的特征,这让我意识到,真正的“机器学习专家”,不仅仅是代码的编写者,更是数据的“魔法师”。 《Machine Learners》在解释模型评估与选择方面,也提供了非常独到的见解。我以前常常对各种评估指标感到困惑,不知道在什么情况下应该关注哪个指标。但作者通过对不同场景的分析,让我明白了精度、召回率、F1分数等等之间的权衡关系,以及如何根据具体的业务需求来选择最合适的评估体系。这就像是在一个复杂迷宫中,给我指明了方向,让我不再盲目地追求某个单一的指标。 书中对于“集成学习”的讲解,也让我大开眼界。我之前只知道“随机森林”这个名字,但通过《Machine Learners》的深入解析,我才真正理解了“集百家之长”的强大威力。作者不仅解释了bagging和boosting等基本思想,还深入剖析了XGBoost等明星算法的内部机制。这让我看到了,通过巧妙地组合多个弱学习器,可以构建出超越任何单一模型的强大预测能力。 我非常欣赏作者在书中对“模型可解释性”的重视。他并没有把AI描绘成一个神秘的黑箱,而是强调理解模型决策过程的重要性。他介绍了像LIME和SHAP这样的方法,让我能够更深入地理解模型为什么会做出某个预测,这对于建立用户信任和进行模型调试至关重要。这让我觉得,机器学习不仅仅是追求预测的准确性,更重要的是能够被理解和负责任地使用。 《Machine Learners》在讨论模型的局限性和潜在风险方面,也做得非常到位。它并没有回避机器学习在实际应用中可能遇到的挑战,比如数据偏差、算法本身的固有缺陷,以及伦理和社会层面的考量。这种坦诚的态度,让我能够更理性地看待机器学习,并为可能遇到的问题做好准备,而不是被一些过度的宣传所蒙蔽。 书中对“迁移学习”和“少样本学习”的介绍,也让我看到了机器学习的未来发展方向。我意识到,AI的学习能力并非总是从零开始,而是可以借鉴已有的知识来加速学习新任务。这让我对AI的学习效率和应用范围有了更深刻的认识,也让我对未来的AI发展充满了期待。 我特别喜欢书中关于“选择合适的模型”这一部分的讨论。作者并没有给出“万能公式”,而是强调了理解问题的本质、数据的特性以及业务目标的重要性。他通过大量的案例分析,展示了如何在不同的场景下,从众多模型中挑选出最适合的那一个,这对我来说是一笔宝贵的财富。 总的来说,《Machine Learners》这本书不仅仅是一本技术书籍,更是一次思维的启迪。它让我从一个旁观者变成了真正的“Machine Learner”,让我看到了机器学习的无限可能,也让我对未来充满了探索的动力。我从这本书中获得的不仅仅是知识,更是一种解决问题的能力和一种科学的思维方式。
评分我最近刚翻完《Machine Learners》,这本书实在是一次令人兴奋又深刻的学习之旅。我一拿到手就被它那充满未来感的封面吸引了,心想这本书到底会带我进入一个怎样的智能世界。读完之后,我可以毫不夸张地说,它远超我的预期。书中对于机器学习的基本概念,比如监督学习、无监督学习、强化学习等等,都进行了非常细致入微的阐述。我尤其欣赏作者在讲解这些概念时,不仅仅停留在理论层面,而是花了大量篇幅去结合实际的案例,比如推荐系统如何运作,图像识别背后隐藏的逻辑,甚至是如何训练一个能够下棋的AI。这些案例让我这个初学者能够非常直观地理解那些抽象的算法,就像亲眼看到一个机器在学习和进化一样。 书中的数学部分,我承认一开始有些许畏惧,但作者的讲解方式非常友好。他并没有一开始就扔出大量的公式和证明,而是循序渐进,从最基础的线性代数和概率论开始,将这些数学工具与机器学习模型的构建紧密联系起来。我能感受到作者的用心,他似乎在说:“别担心,这些工具其实并不神秘,它们是理解机器如何学习的钥匙。” 他的解释清晰易懂,即便是我这种数学基础不算特别扎实的读者,也能够跟得上思路。更重要的是,他强调了理解这些数学原理的重要性,而不是仅仅停留在调用库函数的层面。这让我明白,真正的“Machine Learner”需要的是对底层逻辑的洞察,而不是简单的代码搬运工。 《Machine Learners》真正让我着迷的一点是它对算法的深度剖析。作者并没有回避那些复杂的算法,比如支持向量机(SVM)、决策树、随机森林,甚至是深度学习中的神经网络。但他并不是生硬地罗列算法的特性,而是深入浅出地讲解了它们的工作原理、优缺点以及适用场景。我特别喜欢他关于“过拟合”和“欠拟合”的章节,那段讲解简直是点睛之笔。他通过生动的比喻,让我一下子就明白了这两个机器学习中最常见的陷阱,并且提供了多种有效的解决方案。这就像是得到了一个宝贵的“避坑指南”,让我对接下来的模型训练充满了信心,不再害怕犯那些低级错误。 这本书在模型评估和调优的部分也做得相当出色。我一直认为,训练出一个模型只是第一步,如何判断模型的好坏,以及如何让它变得更好,才是真正考验一个人功力的环节。作者在这方面提供了非常实用的指导,从各种评估指标(如准确率、精确率、召回率、F1分数)的计算方式和意义,到交叉验证、网格搜索等调优技巧,他都进行了详细的讲解。我学到了如何根据不同的任务选择合适的评估指标,以及如何通过系统性的调优来优化模型的性能。这让我在读完之后,立刻跃跃欲试,想要将这些知识应用到我自己的项目上去。 《Machine Learners》的另外一个亮点在于它对数据预处理和特征工程的重视。作者花了相当多的篇幅来讲解如何处理真实世界中各种 messy 的数据。从缺失值的填充,到异常值的检测与处理,再到特征的缩放、编码和选择,他都提供了非常全面且实用的方法。我尤其欣赏他关于“特征工程是炼金术”的比喻,让我深刻认识到,好的特征往往比复杂的模型更能决定最终的成败。这本书让我明白,在机器学习的实践中,数据的重要性不亚于算法本身,甚至可以说是“喂养”AI的“粮食”,而这本书就是教会我如何准备最营养的“粮食”。 我对书中关于“模型的可解释性”这一章节印象尤为深刻。在如今越来越强调AI伦理和透明度的时代,理解模型是如何做出决策变得至关重要。《Machine Learners》并没有将可解释性视为一个可有可无的附加项,而是将其放在了一个非常重要的位置。作者介绍了一些常用的可解释性技术,比如LIME和SHAP,并详细解释了它们的应用。这让我意识到,即使是复杂的黑箱模型,我们也有办法去探究其内部的工作机制,从而更好地信任和使用AI。这本书让我看到了机器学习不仅仅是冰冷的算法,它也可以是能够被理解、被信任的智能。 这本书的案例研究部分是我最喜欢的部分之一。作者挑选了几个典型的机器学习应用场景,比如信用评分、垃圾邮件检测、甚至是简单的自然语言处理任务,并一步步地展示了如何应用前面学到的知识来解决这些问题。他不仅仅是展示了最终的代码,而是详细地记录了从数据分析、模型选择、特征工程到模型评估和优化的整个过程。这种“手把手”的教学方式,让我感觉就像是和作者一起在完成一个项目,学习效果非常显著。 《Machine Learners》在预测建模的挑战和局限性方面,也给出了非常坦诚的讨论。它并没有过分强调机器学习的“神奇”之处,而是理性地分析了在实际应用中可能遇到的各种困难,比如数据偏差、算法本身的局限性、以及对计算资源的要求等。这种务实的态度让我觉得这本书非常可靠,它帮助我建立了一个更加 realistic 的关于机器学习的认知,而不是被一些过度乐观的宣传所误导。 我特别欣赏作者在书中对“终身学习”的倡导。他鼓励读者在读完这本书之后,继续保持好奇心,不断探索新的算法和技术。书中还提供了一些后续学习的资源和建议,这对于我这样刚入门的学习者来说,简直是太有帮助了。这本书就像是一扇开启机器学习世界的大门,而作者则是一位耐心的向导,指引我迈出第一步,并且告诉我未来还有更多的风景等着我去发现。 总而言之,《Machine Learners》是一本让我受益匪浅的书。它不仅为我打下了坚实的机器学习理论基础,更重要的是,它培养了我解决实际问题的能力和对这个领域的浓厚兴趣。我能够感受到作者在编写这本书时投入的心血,他用清晰的语言、丰富的案例和深刻的洞察力,将一个复杂的主题变得如此易于理解。我强烈推荐这本书给任何对机器学习感兴趣的朋友,无论你是初学者还是希望系统梳理知识的进阶者,相信这本书都会给你带来巨大的启发。
评分我最近刚读完《Machine Learners》,这本书简直是一场精彩绝伦的学习冒险。从我拿起这本书的那一刻起,就被它那引人入胜的写作风格深深吸引。作者并没有上来就用枯燥乏味的理论轰炸读者,而是巧妙地将机器学习的各个概念,通过一个个生动有趣的案例展现出来。我尤其喜欢他讲解“监督学习”时,用如何训练一个能够识别垃圾邮件的AI作为例子,让我一下子就理解了“标记数据”和“模型预测”之间的关系。 书中对“特征工程”的讲解,简直是点睛之笔。我之前一直以为,模型的性能好坏主要取决于算法本身,但《Machine Learners》让我明白,好的特征往往比复杂的算法更为重要。作者详细讲解了如何从原始数据中提取有用的信息,如何处理文本、图像、时间序列等不同类型的数据,以及如何创建新的、更有预测能力的特征。这让我看到了,数据科学家真正的价值,往往体现在对数据的洞察力和创造力上。 我特别欣赏书中关于“模型评估”的章节。作者并没有简单地介绍各种评估指标,而是深入分析了它们在不同场景下的适用性。比如,在医疗诊断中,召回率的重要性可能远高于精确率,而在垃圾邮件过滤中,精确率则更为关键。这种 nuanced 的分析,让我对如何科学地评估模型有了更深刻的理解,也为我今后在实际项目中选择合适的评估体系提供了指导。 《Machine Learners》在探讨“模型可解释性”方面,也做得非常出色。在当今社会,AI的应用越来越广泛,但我们常常会因为无法理解模型的决策过程而对其产生疑虑。这本书给了我很大的启发,作者介绍了像LIME和SHAP这样的先进技术,并详细解释了它们如何帮助我们理解那些复杂的“黑箱”模型。这不仅增加了我对AI的信任度,也为我今后在实际工作中应用AI打下了坚实的基础。 书中关于“模型选择”的讲解,也让我受益匪浅。作者并没有给出“一刀切”的建议,而是强调了根据不同的问题类型、数据特征和业务目标,来选择最适合的模型。他详细对比了各种主流算法的优缺点,比如线性模型、树模型、神经网络等等,并结合实际案例,讲解了如何在不同的场景下做出明智的选择。这让我明白,机器学习并非是一个“万能工具箱”,而是需要根据具体情况来灵活运用。 《Machine Learners》在探讨“模型局限性”和“潜在风险”方面,也表现出了极高的专业性和负责任的态度。它并没有过度宣传机器学习的“神奇”之处,而是理性地分析了在实际应用中可能遇到的各种困难,比如数据偏差、算法本身的局限性、以及对计算资源的要求等。这种务实的态度,让我能够建立一个更加 realistic 的关于机器学习的认知,而不是被一些过度乐观的宣传所误导。 书中关于“集成学习”的讲解,也让我看到了机器学习的巨大潜力。我之前只知道“随机森林”这个名字,但通过这本书的深入解析,我才真正理解了“集百家之长”的威力。作者不仅解释了bagging和boosting等基本思想,还深入剖析了XGBoost等明星算法的内部机制。这让我看到了,通过巧妙地组合多个弱学习器,可以构建出超越任何单一模型的强大预测能力。 我特别喜欢作者在书中对“模型部署”和“模型监控”的关注。很多机器学习的书籍都止步于模型训练,但《Machine Learners》却进一步探讨了如何将训练好的模型应用到实际生产环境中,以及如何对其进行长期的监控和维护。这让我看到了机器学习的完整生命周期,也为我今后的职业发展提供了更全面的视野。 书中关于“迁移学习”和“少样本学习”的介绍,也让我看到了机器学习的未来发展方向。我意识到,AI的学习能力并非总是从零开始,而是可以借鉴已有的知识来加速学习新任务。这让我对AI的学习效率和应用范围有了更深刻的认识,也让我对未来的AI发展充满了期待。 总而言之,《Machine Learners》是一本让我受益匪浅的书。它不仅为我打下了坚实的机器学习理论基础,更重要的是,它培养了我解决实际问题的能力和对这个领域的浓厚兴趣。我能够感受到作者在编写这本书时投入的心血,他用清晰的语言、丰富的案例和深刻的洞察力,将一个复杂的主题变得如此易于理解。我强烈推荐这本书给任何对机器学习感兴趣的朋友,无论你是初学者还是希望系统梳理知识的进阶者,相信这本书都会给你带来巨大的启发。
评分自从我开始阅读《Machine Learners》以来,我对机器学习的理解就进入了一个全新的境界。这本书的独特之处在于,它并非简单地罗列各种算法和公式,而是将整个机器学习的过程,从数据的收集到模型的部署,都进行了系统且深入的阐述。作者就像是一位经验丰富的向导,带领我穿越机器学习的复杂丛林,让我能够清晰地看到其中的路径和风景。我尤其喜欢他对于“数据预处理”的详细讲解,那些关于缺失值、异常值、文本编码的实用技巧,在我看来简直是“解燃眉之急”。 书中对“模型评估”的讲解,让我受益匪浅。我之前总是陷入各种评估指标的困惑之中,不知道在什么情况下应该选择哪一个。但《Machine Learners》通过对不同业务场景的深入分析,让我明白了各种指标的含义以及它们之间的权衡关系。作者用生动的例子,比如在医疗诊断和广告推荐中,精确率和召回率的重要性是截然不同的,这让我对如何科学地评估模型有了更深刻的理解。 《Machine Learners》在“特征工程”方面的阐述,是我之前阅读过的任何书籍都无法比拟的。我曾经以为,特征工程就是简单的对数据进行一些变换,但这本书让我明白,它更像是一种艺术,需要对业务有深入的理解,并能够从数据中提炼出真正有价值的信息。作者详细讲解了如何创建交互特征、如何进行多项式特征的扩展,甚至是如何从文本数据中提取出有意义的特征。这让我看到了,数据科学家真正的价值,往往体现在对特征的洞察力上。 我不得不特别强调书中关于“模型可解释性”的部分。在如今越来越强调AI伦理和透明度的时代,理解模型是如何做出决策变得至关重要。《Machine Learners》在这方面给了我非常大的启发。作者介绍了像LIME和SHAP这样的先进技术,并详细解释了它们如何帮助我们理解那些复杂的“黑箱”模型。这让我对AI的信任度大大提升,也为我今后在实际工作中应用AI打下了坚实的基础。 《Machine Learners》在探讨“模型局限性”和“潜在风险”方面,也表现出了极高的专业性和负责任的态度。它并没有过度宣传机器学习的“神奇”之处,而是理性地分析了在实际应用中可能遇到的各种困难,比如数据偏差、算法本身的局限性、以及对计算资源的要求等。这种务实的态度,让我能够建立一个更加 realistic 的关于机器学习的认知,而不是被一些过度乐观的宣传所误导。 书中关于“集成学习”的讲解,也让我对机器学习的强大力量有了全新的认识。我之前只知道“随机森林”这个名字,但通过《Machine Learners》的深入解析,我才真正理解了“集百家之长”的威力。作者不仅解释了bagging和boosting等基本思想,还深入剖析了XGBoost等明星算法的内部机制。这让我看到了,通过巧妙地组合多个弱学习器,可以构建出超越任何单一模型的强大预测能力。 我非常欣赏作者在书中对“模型部署”和“模型监控”的关注。很多机器学习的书籍都止步于模型训练,但《Machine Learners》却进一步探讨了如何将训练好的模型应用到实际生产环境中,以及如何对其进行长期的监控和维护。这让我看到了机器学习的完整生命周期,也为我今后的职业发展提供了更全面的视野。 《Machine Learners》在介绍“迁移学习”和“少样本学习”时,也让我看到了机器学习的未来发展方向。我意识到,AI的学习能力并非总是从零开始,而是可以借鉴已有的知识来加速学习新任务。这让我对AI的学习效率和应用范围有了更深刻的认识,也让我对未来的AI发展充满了期待。 书中对于“选择合适的模型”这一部分的讨论,也为我提供了非常有价值的指导。作者并没有给出“万能公式”,而是强调了理解问题的本质、数据的特性以及业务目标的重要性。他通过大量的案例分析,展示了如何在不同的场景下,从众多模型中挑选出最适合的那一个,这对我来说是一笔宝贵的财富。 总而言之,《Machine Learners》是一本让我受益匪浅的书。它不仅为我打下了坚实的机器学习理论基础,更重要的是,它培养了我解决实际问题的能力和对这个领域的浓厚兴趣。我能够感受到作者在编写这本书时投入的心血,他用清晰的语言、丰富的案例和深刻的洞察力,将一个复杂的主题变得如此易于理解。我强烈推荐这本书给任何对机器学习感兴趣的朋友,无论你是初学者还是希望系统梳理知识的进阶者,相信这本书都会给你带来巨大的启发。
评分《Machine Learners》这本书,真是我近期阅读中,最为感到“解渴”的一本。长期以来,我对机器学习领域一直抱有极大的兴趣,但总是感觉隔着一层窗户纸,难以真正地深入进去。直到我翻开这本书,才发现,原来那些听起来高大上的概念,在作者的笔下,可以变得如此生动和易于理解。他没有上来就堆砌那些晦涩难懂的数学公式,而是从一些非常生活化的例子开始,比如如何用机器学习来预测天气,或者如何识别图片中的猫和狗。这种由浅入深的方式,让我这个初学者很快就找到了学习的切入点,并且充满了学习的动力。 我特别欣赏书中对于“模型评估”的详细讲解。我以前总是觉得,只要模型跑出个高分就行了,但这本书让我明白了,评估模型的好坏,需要结合具体的业务场景来判断。作者详细介绍了各种评估指标,如精确率、召回率、F1分数等等,并且解释了它们各自的优缺点以及适用范围。他甚至还举了一些例子,说明在某些情况下,提高召回率可能比提高精确率更为重要,这让我对如何科学地评估模型有了全新的认识。 书中关于“特征工程”的部分,简直是颠覆了我之前的很多认知。我以前总是把精力放在寻找更复杂的算法,但作者却强调,很多时候,一个好的特征,比一个复杂的模型更能决定最终的预测结果。他详细讲解了如何从原始数据中提取有用的信息,如何处理缺失值、异常值,以及如何进行特征的编码和缩放。这让我明白了,在机器学习领域,数据的重要性不亚于算法本身,甚至可以说是“炼金术”的关键所在。 我不得不提的是,书中对“模型可解释性”的讨论,在我看来是这本书最大的亮点之一。在当今社会,AI的应用越来越广泛,但我们常常会因为无法理解模型的决策过程而对其产生疑虑。《Machine Learners》在这方面给了我很大的启发。作者介绍了像LIME和SHAP这样的技术,让我看到了如何去“看穿”模型的“黑箱”,理解它为什么会做出某个预测。这不仅增加了我对AI的信任度,也为我今后在实际工作中应用AI打下了基础。 《Machine Learners》在处理“数据偏差”问题上也给我留下了深刻的印象。作者非常坦诚地指出了,现实世界中的数据往往存在各种各样的偏差,而这些偏差会对模型的公平性和准确性产生严重的影响。他详细讲解了如何识别数据偏差,以及如何采取相应的技术手段来减轻这些偏差带来的负面影响。这让我认识到,做一个负责任的机器学习工程师,不仅要追求模型的性能,更要关注其潜在的社会影响。 书中关于“模型选择”的章节,也为我提供了非常有价值的指导。我以前总是纠结于选择哪种模型,但作者却强调,没有最好的模型,只有最适合的模型。他通过对不同算法的优缺点进行对比分析,并结合各种应用场景,帮助我理解了如何根据问题的性质、数据的特点以及业务需求,来做出明智的模型选择。这让我不再盲目地追求复杂性,而是更加注重模型的实用性和效率。 我非常喜欢作者在书中对“过拟合”和“欠拟合”的讲解。他用非常生动的比喻,让我一下子就明白了这两个机器学习中最常见的陷阱,并且提供了多种行之有效的解决方案。这就像是给我提供了一个“避坑指南”,让我对接下来的模型训练充满了信心,不再担心会犯那些低级错误。 《Machine Learners》在介绍“集成学习”时,也让我看到了机器学习的巨大潜力。我以前只知道“随机森林”,但通过这本书的深入讲解,我才真正理解了“集百家之长”的强大之处。作者详细介绍了bagging和boosting等技术,并解释了它们如何通过组合多个弱学习器来构建出超越任何单一模型的强大预测能力。 我特别欣赏作者在书中对“模型部署”和“模型监控”的关注。很多机器学习的书籍都止步于模型训练,但《Machine Learners》却进一步探讨了如何将训练好的模型应用到实际生产环境中,以及如何对其进行长期的监控和维护。这让我看到了机器学习的完整生命周期,也为我今后的职业发展提供了更全面的视野。 总而言之,《Machine Learners》这本书对我来说,不仅仅是一本技术书籍,更是一次思维的洗礼。它用清晰的语言、丰富的案例和深刻的洞察力,将一个复杂的主题变得如此易于理解。我从这本书中获得的不仅仅是知识,更是一种解决问题的能力,一种科学的思维方式,以及一种对未来科技的无限憧憬。
评分我近期读完的《Machine Learners》这本书,绝对是我近年来阅读中最具价值的图书之一。作者以一种极其系统和全面的方式,将机器学习的各个分支,从基础概念到前沿技术,都进行了深入浅出的讲解。我尤其欣赏书中对“数据预处理”环节的重视,作者详细阐述了如何处理缺失值、异常值、类别特征编码等等,这些实用的技巧,让我能够真正地将学到的知识应用到实际的数据处理中。 书中对“模型评估”的讲解,让我耳目一新。我之前总是觉得,只要模型的准确率高就行了,但《Machine Learners》让我明白了,在不同的应用场景下,需要关注不同的评估指标。作者通过对医疗诊断、金融风控等案例的分析,让我深刻理解了精确率、召回率、F1分数等指标的含义以及它们之间的权衡关系,这对我日后进行模型选择和评估提供了极大的帮助。 《Machine Learners》在“特征工程”方面的阐述,简直是为我打开了新世界的大门。我之前一直以为,特征工程就是简单的对数据进行一些转换,但这本书让我明白,它更像是一种艺术,需要对业务有深入的理解,并能够从数据中提炼出真正有价值的信息。作者详细讲解了如何创建交互特征、如何进行多项式特征的扩展,甚至是如何从文本数据中提取出有意义的特征。这让我看到了,数据科学家真正的价值,往往体现在对特征的洞察力上。 我不得不特别强调书中关于“模型可解释性”的部分。在当今社会,AI的应用越来越广泛,但我们常常会因为无法理解模型的决策过程而对其产生疑虑。《Machine Learners》给了我很大的启发,作者介绍了像LIME和SHAP这样的先进技术,并详细解释了它们如何帮助我们理解那些复杂的“黑箱”模型。这不仅增加了我对AI的信任度,也为我今后在实际工作中应用AI打下了坚实的基础。 书中关于“模型选择”的讲解,也让我受益匪浅。作者并没有给出“一刀切”的建议,而是强调了根据不同的问题类型、数据特征和业务目标,来选择最适合的模型。他详细对比了各种主流算法的优缺点,比如线性模型、树模型、神经网络等等,并结合实际案例,讲解了如何在不同的场景下做出明智的选择。这让我明白,机器学习并非是一个“万能工具箱”,而是需要根据具体情况来灵活运用。 《Machine Learners》在探讨“模型局限性”和“潜在风险”方面,也表现出了极高的专业性和负责任的态度。它并没有过度宣传机器学习的“神奇”之处,而是理性地分析了在实际应用中可能遇到的各种困难,比如数据偏差、算法本身的局限性、以及对计算资源的要求等。这种务实的态度,让我能够建立一个更加 realistic 的关于机器学习的认知,而不是被一些过度乐观的宣传所误导。 书中关于“集成学习”的讲解,也让我看到了机器学习的巨大潜力。我之前只知道“随机森林”这个名字,但通过这本书的深入解析,我才真正理解了“集百家之长”的威力。作者不仅解释了bagging和boosting等基本思想,还深入剖析了XGBoost等明星算法的内部机制。这让我看到了,通过巧妙地组合多个弱学习器,可以构建出超越任何单一模型的强大预测能力。 我特别喜欢作者在书中对“模型部署”和“模型监控”的关注。很多机器学习的书籍都止步于模型训练,但《Machine Learners》却进一步探讨了如何将训练好的模型应用到实际生产环境中,以及如何对其进行长期的监控和维护。这让我看到了机器学习的完整生命周期,也为我今后的职业发展提供了更全面的视野。 书中关于“迁移学习”和“少样本学习”的介绍,也让我看到了机器学习的未来发展方向。我意识到,AI的学习能力并非总是从零开始,而是可以借鉴已有的知识来加速学习新任务。这让我对AI的学习效率和应用范围有了更深刻的认识,也让我对未来的AI发展充满了期待。 总而言之,《Machine Learners》是一本让我受益匪浅的书。它不仅为我打下了坚实的机器学习理论基础,更重要的是,它培养了我解决实际问题的能力和对这个领域的浓厚兴趣。我能够感受到作者在编写这本书时投入的心血,他用清晰的语言、丰富的案例和深刻的洞察力,将一个复杂的主题变得如此易于理解。我强烈推荐这本书给任何对机器学习感兴趣的朋友,无论你是初学者还是希望系统梳理知识的进阶者,相信这本书都会给你带来巨大的启发。
评分A clear critical reading of machine learning algorithm
评分A clear critical reading of machine learning algorithm
评分A clear critical reading of machine learning algorithm
评分A clear critical reading of machine learning algorithm
评分A clear critical reading of machine learning algorithm
相关图书








本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有