

具体描述
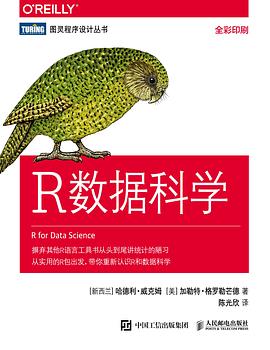
本书的目标是教会读者使用最重要的数据科学工具,从而为实施数据科学奠定坚实的基础。读完本书后,你将掌握R语言的精华,并能够熟练使用多种工具来解决各种数据科学难题。每一章都按照这样的顺序组织内容:先给出一些引人入胜的示例,以便你可以整体了解这一章的内容,然后再深入细节。本书的每一节都配有习题,以帮助你实践所学到的知识。
作者简介
作者简介:
哈德利•威克姆(Hadley Wickham)
RStudio首席科学家,统计学家,斯坦福大学、奥克兰大学、莱斯大学兼职统计学教授。已被下载数百万次的ggplot2等多款知名R包的开发者,一直致力于让普罗大众更容易上手数据分析,被R社区誉为“改变了R的人”。另著有《R包开发》等书。
加勒特•格罗勒芒德(Garrett Grolemund),RStudio数据科学家,知名R培训师,曾受邀在Google、eBay等诸多公司讲授R语言和数据科学,在DataCamp开授的R相关课程备受R开发者喜爱。另著有《R语言入门与实践》。
译者简介:
陈光欣,毕业于清华大学并留校工作,主要兴趣为数据分析与数据挖掘。
目录信息
第一部分 探索
第1章 使用ggplot2进行数据可视化 3
1.1 简介 3
1.2 第一步 4
1.2.1 mpg数据框 4
1.2.2 创建ggplot图形 5
1.2.3 绘图模板 5
1.2.4 练习 6
1.3 图形属性映射 6
1.4 常见问题 10
1.5 分面 11
1.6 几何对象 13
1.7 统计变换 18
1.8 位置调整 21
1.9 坐标系 25
1.10 图形分层语法 27
第2章 工作流:基础 29
2.1 代码基础 29
2.2 对象名称 30
2.3 函数调用 30
第3章 使用dplyr进行数据转换 33
3.1 简介 33
3.1.1 准备工作 33
3.1.2 nycflights13 33
3.1.3 dplyr基础 34
3.2 使用filter()筛选行 35
3.2.1 比较运算符 36
3.2.2 逻辑运算符 36
3.2.3 缺失值 37
3.2.4 练习 38
3.3 使用arrange()排列行 39
3.4 使用select()选择列 40
3.5 使用mutate()添加新变量 42
3.5.1 常用创建函数 43
3.5.2 练习 45
3.6 使用summarize()进行分组摘要 46
3.6.1 使用管道组合多种操作 46
3.6.2 缺失值 48
3.6.3 计数 49
3.6.4 常用的摘要函数 52
3.6.5 按多个变量分组 56
3.6.6 取消分组 57
3.6.7 练习 57
3.7 分组新变量(和筛选器) 58
第4章 工作流:脚本 60
4.1 运行代码 61
4.2 RStudio自动诊断 61
第5章 探索性数据分析 63
5.1 简介 63
5.2 问题 64
5.3 变动 64
5.3.1 对分布进行可视化表示 65
5.3.2 典型值 67
5.3.3 异常值 69
5.3.4 练习 70
5.4 缺失值 71
5.5 相关变动 72
5.5.1 分类变量与连续变量 72
5.5.2 两个分类变量 77
5.5.3 两个连续变量 79
5.6 模式和模型 82
5.7 ggplot2调用 84
5.8 更多学习资源 85
第6章 工作流:项目 86
6.1 什么是真实的 86
6.2 你的分析位于哪里 87
6.3 路径与目录 88
6.4 RStudio项目 88
6.5 小结 90
第二部分 数据处理
第7章 使用tibble实现简单数据框 93
7.1 简介 93
7.2 创建tibble 93
7.3 对比tibble与data.frame 95
7.3.1 打印 95
7.3.2 取子集 96
7.4 与旧代码进行交互 96
第8章 使用readr进行数据导入 98
8.1 简介 98
8.2 入门 98
8.2.1 与R基础包进行比较 100
8.2.2 练习 101
8.3 解析向量 101
8.3.1 数值 102
8.3.2 字符串 103
8.3.3 因子 105
8.3.4 日期、日期时间与时间 105
8.3.5 练习 107
8.4 解析文件 107
8.4.1 策略 107
8.4.2 问题 108
8.4.3 其他策略 110
8.5 写入文件 112
8.6 其他类型的数据 113
第9章 使用dplyr处理关系数据 114
9.1 简介 114
9.2 nycflights13 115
9.3 键 117
9.4 合并连接 119
9.4.1 理解连接 120
9.4.2 内连接 121
9.4.3 外连接 121
9.4.4 重复键 122
9.4.5 定义键列 124
9.4.6 练习 125
9.4.7 其他实现方式 126
9.5 筛选连接 127
9.6 连接中的问题 129
9.7 集合操作 130
第10章 使用stringr处理字符串 131
10.1 简介 131
10.2 字符串基础 131
10.2.1 字符串长度 132
10.2.2 字符串组合 133
10.2.3 字符串取子集 133
10.2.4 区域设置 134
10.2.5 练习 134
10.3 使用正则表达式进行模式匹配 135
10.3.1 基础匹配 135
10.3.2 练习 136
10.3.3 锚点 136
10.3.4 练习 137
10.3.5 字符类与字符选项 137
10.3.6 练习 138
10.3.7 重复 138
10.3.8 练习 139
10.3.9 分组与回溯引用 140
10.3.10 练习 140
10.4 工具 140
10.4.1 匹配检测 142
10.4.2 练习 143
10.4.3 提取匹配内容 144
10.4.4 练习 145
10.4.5 分组匹配 145
10.4.6 练习 147
10.4.7 替换匹配内容 147
10.4.8 练习 147
10.4.9 拆分 147
10.4.10 练习 149
10.4.11 定位匹配内容 149
10.5 其他类型的模式 149
10.6 正则表达式的其他应用 152
10.7 stringi 152
第11章 使用forcats处理因子 154
11.1 简介 154
11.2 创建因子 154
11.3 综合社会调查 156
11.4 修改因子水平 157
第12章 使用lubridate处理日期和时间 160
12.1 简介 160
12.2 创建日期或时间 161
12.2.1 通过字符串创建 161
12.2.2 通过各个成分创建 162
12.2.3 通过其他类型数据创建 164
12.2.4 练习 165
12.3 日期时间成分 165
12.3.1 获取成分 165
12.3.2 舍入 168
12.3.3 设置成分 168
12.3.4 练习 170
12.4 时间间隔 170
12.4.1 时期 170
12.4.2 阶段 171
12.4.3 区间 173
12.4.4 小结 173
12.4.5 练习 174
12.5 时区 174
第三部分 编程
第13章 使用magrittr进行管道操作 179
13.1 简介 179
13.2 管道的替代方式 179
13.2.1 中间步骤 180
13.2.2 重写初始对象 181
13.2.3 函数组合 181
13.2.4 使用管道 182
13.3 不适合使用管道的情形 183
13.4 magrittr中的其他工具 183
第14章 函数 185
14.1 简介 185
14.2 什么时候应该使用函数 186
14.3 人与计算机的函数 188
14.4 条件执行 190
14.4.1 条件 191
14.4.2 多重条件 192
14.4.3 代码风格 192
14.4.4 练习 193
14.5 函数参数 194
14.5.1 选择参数名称 195
14.5.2 检查参数值 195
14.5.3 点点点(...) 197
14.5.4 惰性求值 197
14.5.5 练习 198
14.6 返回值 198
14.6.1 显式返回语句 198
14.6.2 使得函数支持管道 199
14.7 环境 200
第15章 向量 201
15.1 简介 201
15.2 向量基础 202
15.3 重要的原子向量 203
15.3.1 逻辑型 203
15.3.2 数值型 203
15.3.3 字符型 204
15.3.4 缺失值 204
15.3.5 练习 204
15.4 使用原子向量 205
15.4.1 强制转换 205
15.4.2 检验函数 206
15.4.3 标量与循环规则 206
15.4.4 向量命名 208
15.4.5 向量取子集 208
15.4.6 练习 209
15.5 递归向量(列表) 210
15.5.1 列表可视化 211
15.5.2 列表取子集 211
15.5.3 调料列表 212
15.5.4 练习 214
15.6 特性 214
15.7 扩展向量 216
15.7.1 因子 216
15.7.2 日期和日期时间 216
15.7.3 tibble 217
15.7.4 练习 218
第16章 使用purrr实现迭代 219
16.1 简介 219
16.2 for循环 220
16.3 for循环的变体 222
16.3.1 修改现有对象 222
16.3.2 循环模式 223
16.3.3 未知的输出长度 223
16.3.4 未知的序列长度 224
16.3.5 练习 225
16.4 for循环与函数式编程 226
16.5 映射函数 228
16.5.1 快捷方式 229
16.5.2 R基础包 230
16.5.3 练习 231
16.6 对操作失败的处理 231
16.7 多参数映射 233
16.8 游走函数 236
16.9 for循环的其他模式 237
16.9.1 预测函数 237
16.9.2 归约与累计 238
16.9.3 练习 239
第四部分 模型
第17章 使用modelr实现基础模型 243
17.1 简介 243
17.2 一个简单模型 244
17.3 模型可视化 250
17.3.1 预测 250
17.3.2 残差 252
17.3.3 练习 253
17.4 公式和模型族 254
17.4.1 分类变量 255
17.4.2 交互项(连续变量与分类变量) 256
17.4.3 交互项(两个连续变量) 259
17.4.4 变量转换 261
17.4.5 练习 264
17.5 缺失值 264
17.6 其他模型族 265
第18章 模型构建 266
18.1 简介 266
18.2 为什么质量差的钻石更贵 267
18.2.1 价格与重量 268
18.2.2 一个更复杂的模型 271
18.2.3 练习 273
18.3 哪些因素影响了每日航班数量 273
18.3.1 一周中的每一天 274
18.3.2 季节性星期六效应 277
18.3.3 计算出的变量 280
18.3.4 年度时间:另一种方法 281
18.3.5 练习 282
18.4 学习更多模型知识 282
第19章 使用purrr和broom处理多个模型 284
19.1 简介 284
19.2 列表列 285
19.3 创建列表列 286
19.3.1 使用嵌套 286
19.3.2 使用向量化函数 287
19.3.3 使用多值摘要 288
19.3.4 使用命名列表 288
19.3.5 练习 289
19.4 简化列表列 290
19.4.1 列表转换为向量 290
19.4.2 嵌套还原 291
19.4.3 练习 292
19.5 使用broom生成整洁数据 292
第五部分 沟通
第20章 R Markdown 295
20.1 简介 295
20.2 R Markdown基础 295
20.3 使用Markdown格式化文本 298
20.4 代码段 299
20.4.1 代码段名称 300
20.4.2 代码段选项 300
20.4.3 表格 301
20.4.4 缓存 301
20.4.5 全局选项 302
20.4.6 内联代码 303
20.4.7 练习 303
20.5 排错 304
20.6 YAML文件头 304
20.6.1 文档参数 304
20.6.2 参考文献与引用 306
20.7 更多学习资源 307
第21章 使用ggplot2进行图形化沟通 308
21.1 简介 308
21.2 标签 309
21.3 注释 311
21.4 标度 316
21.4.1 坐标轴刻度与图例项目 316
21.4.2 图例布局 318
21.4.3 标度替换 320
21.4.4 练习 324
21.5 缩放 325
21.6 主题 326
21.7 保存图形 328
21.7.1 图形大小 328
21.7.2 其他重要选项 330
21.8 更多学习资源 330
第22章 R Markdown输出类型 331
22.1 简介 331
22.2 输出选项 332
22.3 文档 332
22.4 笔记本 333
22.5 演示文稿 333
22.6 仪表盘 334
22.7 交互元素 335
22.7.1 htmlwidgets 335
22.7.2 Shiny 336
22.8 网站 337
22.9 其他类型 338
22.10 更多学习资源 338
第23章 R Markdown工作流 339
作者简介 341
封面简介 341
· · · · · · (收起)
读后感
这本书的定位是 data science 入门书,特点是使用了 tidyverse 的一套哲学。整体思路可借用书中的一张图来说明: 首先明确几点原则: 1. 工具不是重点,创造价值才是目的。具体到数据科学,表现形式往往是提供解决方案或者做出某种决策。至于使用什么语言,采用什么工具,不本...
评分有人说这本书就是Hadley安利他的Tidyverse各种包,书名不如就叫《Tidyverse for Data Analysis》,没办法,谁让Tidyverse就是优雅好用呢。举个例子,我看完以后就记得一堆动词性函数(Verbs),比如用filter()筛选符合条件的行(observations),用select()筛选需要的列(varia...
评分学R是在2012年在Jenny Bryan的stats 540的课上, Jenny也是本书几个章节的作者之一。 那时,课上画图用的是 lattice,这个包只包括了一些常见的画图函数,有些图没有,经常还得去找其他的包,理解不同函数的输入参数。同一个事情,不同包的控制参数名称完全不一样,经常找不到或...
评分这本书的定位是 data science 入门书,特点是使用了 tidyverse 的一套哲学。整体思路可借用书中的一张图来说明: 首先明确几点原则: 1. 工具不是重点,创造价值才是目的。具体到数据科学,表现形式往往是提供解决方案或者做出某种决策。至于使用什么语言,采用什么工具,不本...
评分这本书的定位是 data science 入门书,特点是使用了 tidyverse 的一套哲学。整体思路可借用书中的一张图来说明: 首先明确几点原则: 1. 工具不是重点,创造价值才是目的。具体到数据科学,表现形式往往是提供解决方案或者做出某种决策。至于使用什么语言,采用什么工具,不本...
用户评价
最让我感到惊喜的是,作者似乎非常了解读者在学习过程中可能遇到的“卡点”。书中有一部分内容专门讨论了处理非结构化数据时的挑战,包括文本数据的清洗和特征提取。这部分内容写得特别接地气,它没有回避实际操作中的各种脏乱差,比如编码问题、噪音干扰等,而是直接给出了应对这些问题的实战经验。我记得有一次我的一个文本分析项目遇到了分类不准的问题,我在书中找到了一个关于词向量化和模型融合的章节,作者在那里详细分析了为什么单一模型在处理语义复杂性时会受限,并推荐了一个结合了深度学习和传统TF-IDF的混合策略。照着这个思路调整后,效果立竿见影。这本书的结构安排也体现了作者的良苦用心,它把最基础的数据处理放在最前面,然后逐步引入统计理论,最后才接触高级的机器学习应用,这种循序渐进的方式极大地增强了读者的成就感和持续学习的动力,避免了新手在初期就被复杂的公式吓退。
评分这本书的封面设计得非常简洁有力,那种深蓝色调配上醒目的白色字体,给人一种专业又不失现代感的感觉。我当初拿到手的时候,光是翻阅目录就被深深吸引了。它不像有些技术书籍那样堆砌晦涩的术语,而是用一种非常平易近人的方式,把数据科学这个听起来高不可攀的领域,拆解成了若干个可以理解的小模块。比如,它对数据清洗和预处理的讲解就特别到位,不是简单地罗列函数,而是结合了实际案例,让我明白为什么有些步骤是必须的,而不是为了凑篇幅。特别是关于缺失值处理那一段,作者没有采用“一刀切”的方法,而是深入分析了不同类型缺失数据背后的含义,提供了多种策略并对比了它们在不同场景下的优劣。这让我在实际工作中遇到棘手的数据问题时,有了一个可靠的参考框架,而不是盲目套用网上的代码片段。阅读体验上,作者的叙述逻辑清晰流畅,每章节之间过渡自然,仿佛一位经验丰富的导师在身边循循善诱,而不是冰冷的技术手册。这种叙事风格极大地降低了我的学习门槛,让我对后续更复杂的统计模型和机器学习算法的学习充满了信心。
评分坦白说,我以前也看过不少数据分析相关的书籍,但很多都很快过时,或者侧重于特定软件的简单操作。然而,这本书展现出了一种超越工具的洞察力。它关注的重点始终是“数据思维”的培养。比如,在可视化那一章,作者花了很大篇幅讲解如何选择正确的图表类型来传达特定的信息,而不是仅仅教你怎么调用绘图函数。他强调了“讲故事”的重要性,指出好的数据分析最终目的是影响决策,而有效沟通是关键。我特别喜欢书中关于实验设计和因果推断的章节,这部分内容在很多入门书籍中往往是一笔带过,但这本书却深入探讨了A/B测试的统计显著性、多重检验的校正等严肃话题,这让我的分析工作从描述性统计迈向了更具指导意义的推断性统计。这种对分析严谨性的坚持,让这本书的价值远远超过了单纯的技术手册,更像是一门严谨的量化科学课程。
评分这本书的论述风格非常成熟,它不像某些新出的快餐式教程那样追求速度和新奇的库,而是立足于那些经过时间检验的核心方法论,同时又巧妙地融合了最新的行业趋势。我尤其欣赏作者在讨论模型评估和泛化能力时所持有的审慎态度。他反复强调过拟合的危险性,并详细阐述了交叉验证、正则化等技术背后的统计意义,而不是仅仅把它们当作需要执行的步骤。书中关于模型可解释性的讨论也令人耳目一新,在当前“黑箱模型”流行的背景下,作者坚持探讨如何打开模型,理解其决策过程,这对于需要对业务方负责任的分析师来说至关重要。阅读完这本书,我感觉自己不再是被动地执行命令,而是真正具备了对数据问题进行批判性思考的能力。它提供的是一套思考的框架和内化的工具,而不是简单的速成秘籍,这使得它的参考价值能在未来很长一段时间内保持稳定和高涨。
评分这本书的深度和广度实在令人印象深刻,它真正体现了“实践出真知”的理念。我尤其欣赏作者在讲解复杂算法时,总是会穿插一些历史背景或者底层原理的探讨。举个例子,当介绍到某种回归模型时,作者没有直接给出代码,而是先追溯了该模型思想的起源,解释了它在特定假设下是如何优化的。这种“知其然,更知其所以然”的教学方式,对我这种追求透彻理解的学习者来说,简直是醍醐灌顶。书中提供的代码示例不仅数量多,而且质量极高,每一个例子都紧密围绕一个核心概念,并且注释详尽,代码风格也规范统一,这对于初学者建立良好的编程习惯至关重要。我尝试着自己搭建了一个小型项目,并对照书中的方法论进行了数据分析的每一步,发现之前困扰我的很多性能瓶颈,通过参考书中的优化技巧得到了有效解决。总而言之,它不仅仅是一本工具书,更像是一本方法论的宝典,教会我如何构建一个完整、健壮的数据分析流程。
评分这是2015以后的r,并且我还在使用中。至少现在用r,不可能避免调用tidyverse
评分读不够
评分绝好的入门书,关于代码格式、数据可视化、数据整理,以及函数化编程的观点都很合理且好用。
评分绝好的入门书,关于代码格式、数据可视化、数据整理,以及函数化编程的观点都很合理且好用。
评分有不会的就查,工具书,wickham真是个好领路人
相关图书



本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有