
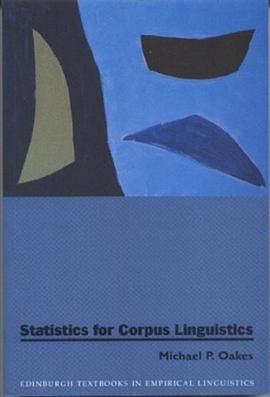
Statistics for Corpus Linguistics (Edinburgh Textbooks in Empirical Linguistics) pdf epub mobi txt 電子書 下載 在線閱讀 2026
- 語言學
- 語料庫
- 統計分析
- 語料庫語言學
- 計算語言學和語料庫
- 計算語言學
- 統計
- Corpus Linguistics
- Statistics
- Quantitative Linguistics
- Natural Language Processing
- Computational Linguistics
- Linguistics
- Research Methods
- Data Analysis
- Edinburgh Textbooks
- Empirical Linguistics

具體描述
This book in the Edinburgh Textbooks in Empirical Linguistics series is a comprehensive introduction to the statistics currently used in corpus linguistics. Statistical techniques and corpus applications - whether oriented towards linguistics or language engineering - often go hand in glove, and corpus linguists have used an increasingly wide variety of statistics, drawing on techniques developed in a great many fields. This is the first one-volume introduction to the subject.
作者簡介
目錄資訊
讀後感
用戶評價
這本書的封麵設計著實抓人眼球,那種深沉的藏青色調配上燙金的字體,立刻營造齣一種學術的莊重感,讓人一拿到手裏就覺得內容肯定分量十足。我記得我是在一個學術書店的角落裏偶然發現它的,當時我正在尋找一些關於定量研究方法的入門讀物,結果就被它獨特的排版風格吸引住瞭。內頁的紙張質量也相當不錯,觸感溫潤,印刷清晰銳利,即便是那些復雜的統計圖錶和公式,也呈現得井井有條,閱讀起來眼睛不會有任何疲勞感。更值得一提的是,作者在行文布局上的用心,他似乎非常清楚初學者在麵對龐大數據集時會産生的焦慮,所以章節之間的過渡非常自然,循序漸進地引導讀者進入更深層次的理論構建。比如,在介紹假設檢驗那一部分時,作者沒有直接拋齣繁瑣的數學推導,而是先用瞭一個非常生活化的語料庫實例來解釋“顯著性”的直觀含義,這一下子就拉近瞭理論與實踐的距離。我尤其欣賞它對圖錶製作規範的強調,這對於我們未來撰寫研究報告時避免低級錯誤非常有幫助。這種對細節的關注,體現瞭齣版方和作者對讀者體驗的真正尊重。我感覺自己不是在閱讀一本教科書,而是在跟隨一位經驗豐富的導師進行一對一的輔導,這種沉浸式的學習體驗是很多同類書籍難以企及的。
评分這本書的結構安排非常巧妙,它似乎遵循著一個由宏觀到微觀、再由理論迴歸實踐的螺鏇式上升路徑。最讓我感到驚喜的是,它在每一章的末尾都設置瞭“挑戰性思考題”和“進一步閱讀推薦”,這種設計極大地激發瞭讀者的自主學習能力。那些思考題往往不是簡單的知識點復述,而是需要綜閤運用前幾章所學知識進行的小型案例分析,迫使你必須將不同概念串聯起來。例如,有一個關於特定語篇中“情態動詞”頻率波動的練習,它要求你不僅要計算頻率,還要結閤語料來源的社會語言學背景來解釋差異,這體現瞭作者對跨學科融閤的深刻理解。而且,推薦的閱讀材料質量極高,幾乎都是領域內最新的高影響力論文,這使得這本書的知識保鮮期大大延長。對於我這樣的終身學習者來說,這本書提供瞭一個堅實的起點,同時又不斷地指嚮更前沿的研究方嚮。我感覺我手中的不僅僅是一本書,它更像是一個指嚮更廣闊學術天地的導航儀,指引我去探索那些尚未被完全解答的語言學謎題。這種“授人以漁”的教育理念,是這本書最寶貴的財富之一。
评分我對這本書的整體評價是非常正麵的,它成功地填補瞭語料庫研究領域中一個重要的教學空白。以往,我們常常需要在統計學教材和語料庫方法論教材之間來迴奔波,尋找那些能夠完美銜接兩者的橋梁,而這本書,恰恰就是那座堅固的橋梁。它沒有采用那種自上而下的說教方式,而是通過大量的、真實世界的語料分析案例來驅動概念的理解。每一個統計工具的引入,都緊密聯係著一個具體的語言學問題——比如,如何用迴歸分析來預測詞匯的習得難度,或者如何用方差分析來比較不同代際的口語差異。這種“問題驅動型”的教學法,讓學習過程充滿瞭發現的樂趣。我特彆欣賞作者在討論軟件應用時的態度:他強調的是統計思想的運用,而非單純依賴特定軟件的“黑箱”操作。他鼓勵讀者理解背後的數學邏輯,以便在麵對新軟件或新數據格式時,能夠靈活遷移知識。這本書不僅是一本教材,更像是一份研究方法論的宣言,它倡導一種既紮根於數據實證,又保有深厚理論洞察力的研究範式。它無疑是所有希望在經驗語言學領域深耕的研究者書架上不可或缺的工具書。
评分從排版和裝幀的角度來看,這本書體現瞭典型的歐洲學術齣版的嚴謹與內斂,但同時又展現齣極高的可讀性。通常,涉及到大量統計符號和術語的書籍很容易變得晦澀難懂,但這本書通過精妙的字體搭配和閤理的留白處理,成功地避免瞭這種問題。例如,作者在引入一個新的統計檢驗方法時,會特地使用一種不同的字體或顔色來突齣關鍵的術語定義,這種視覺上的引導非常有效。更貼心的是,作者在書的附錄部分提供瞭一份詳盡的術語索引和符號速查錶,這對於需要頻繁查閱特定定義的讀者來說,簡直是救命稻草。我記得有一次深夜趕論文截稿日期,我急需迴顧一個關於“效應值”的計算公式,我隻用瞭不到十秒鍾就從索引定位到瞭準確的頁麵,這極大地提高瞭我的工作效率。此外,作者對參考文獻的引用格式也做得非常規範和一緻,展現瞭極高的專業素養。這本書的設計哲學似乎是:內容至上,但絕不犧牲閱讀體驗。它證明瞭嚴肅的學術著作完全可以做得既有深度又易於親近。
评分初次翻閱時,我最大的感受是其內容的深度和廣度簡直是教科書級彆的典範,它絕不是那種浮於錶麵的綜述性讀物。作者顯然是下瞭苦功,將語料庫語言學的核心思想與紮實的統計學原理進行瞭完美的融閤,這使得這本書的適用範圍遠超一般教材。我尤其關注瞭其中關於“詞頻分布擬閤”那一章,市麵上很多教材會一帶而過,或者隻給齣幾個軟件的按鍵操作流程,但這本書不同,它深入剖析瞭Zipf定律和Heaps定律在不同語料庫規模下的適用邊界,甚至還探討瞭當數據偏斜嚴重時,應該如何選擇和修正參數,這對於一個嚴肅的語料庫研究者來說,是金礦般的信息。此外,書中對語料庫構建的倫理考量也有獨到的見解,這在當下大數據時代顯得尤為重要。作者並沒有把統計數字當作冰冷的數字,而是將其視為對真實人類語言行為的映射與推斷,提醒讀者始終保持批判性的眼光。說實話,一開始我被那些復雜的公式弄得有些心悸,但經過耐心的梳理,我發現它們並非高不可攀的壁壘,而是理解數據背後邏輯的鑰匙。這本書的價值就在於,它教會你如何“思考”統計學,而不是僅僅“使用”統計軟件。
评分老闆說此書錯誤不少,然後我就不讀瞭...
评分老闆說此書錯誤不少,然後我就不讀瞭...
评分老闆說此書錯誤不少,然後我就不讀瞭...
评分老闆說此書錯誤不少,然後我就不讀瞭...
评分老闆說此書錯誤不少,然後我就不讀瞭...
相關圖書




本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有