
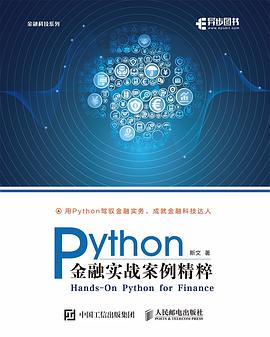

具体描述
随着金融科技时代的到来,Python在金融领域的影响力已经有目共睹。掌握Python在金融实务中的应用,已经成为金融科技达人们必备的技能之一。
本书作为《基于Python的金融分析与风险管理》一书的配套案例集,整合了源于现实金融市场和日常实务工作的88个原创案例,涉及308项编程任务,包括超过6000行的Python代码。本书囊括了丰富多样的金融场景,涵盖利率、汇率、债券、股票、基金、远期、股指期货、外汇期货、国债期货、股票期权、商品期权等金融产品,还涉及商业银行、证券公司、期货公司、保险公司、信托公司、资产管理公司、基金管理公司、金融控股公司等各类型的金融机构,既介绍了包括我国在内的新兴市场,又介绍了欧美成熟的金融市场,囊括金融实务中可能涉及Python编程的各种场景。
本书着眼于一系列从业者可能涉及的金融实务案例,并结合Python编程给出了高效的解决方案。通过阅读本书,读者能够全方位地了解金融市场的运作,深刻洞察各类职务背后的工作技巧。
作者简介
斯文,笔名华尔街先生,浙江湖州人,经济学博士,中国注册会计师(CPA),特许金融分析师(CFA),金融风险管理师(FRM)。目前在一家金融资产交易中心担任风险管理部总经理,拥有在中外资银行、证券公司、信托公司、金融控股集团等机构十余年的金融与风险管理从业经验。
斯文博士也是上海财经大学风险管理校友俱乐部发起人兼理事长、《上财风险管理论坛》杂志主编、上海财经大学金融风险管理峰会秘书长、上海资产管理行业风险管理同业交流会秘书长,并担任中国人民大学、中南财经政法大学、华东政法大学等多所高校的金融硕士研究生合作导师或业界导师,还担任人民邮电出版社金融科技图书专家顾问。公开发表学术论文50余篇,出版著作《基于Python的金融分析与风险管理》和《中国外汇衍生品市场研究》,并荣获人民邮电出版社“2019年度Z具影响力作者”称号。
斯文博士还依托于互联网平台,历时3年多推出了《期权、期货及其他衍生产品(第九版)》视频讲解系列(共360讲),累计观看人次超过百万,并长期致力于倡导和推广Python在金融领域尤其是风险管理领域的运用。
目录信息
1.1 数据结构之元组—以科创板股票为分析对象 2
1.2 数据结构之列表—以全球股票指数为分析对象 6
1.3 数据结构之集合—以股票类型为分析对象 10
1.4 数据结构之字典—以人民币汇率为分析对象 13
1.5 基本算术运算—以交通银行股票为分析对象 16
1.6 高级赋值运算与成员运算—以中国平安股票为分析对象 19
1.7 关系运算—以四大国有银行的财务指标为分析对象 22
1.8 Python内置函数—以券商股为分析对象 25
1.9 Python自定义函数和for语句—以市场利率为分析对象 29
1.10 条件语句和循环语句—以全球重要股指为分析对象 32
1.11 math模块—以保险理赔为分析对象 36
1.12 本章小结 39
第 2章 NumPy模块编程的金融案例 40
2.1 创建N维数组—以美国纳斯达克的科技股为分析对象 41
2.2 数组索引和切片—以互联网公司发行的港股为分析对象 45
2.3 数组内部运算(一)—以保险公司股票为分析对象 48
2.4 数组内部运算(二)—以A股指数为分析对象 52
2.5 数组间运算—以中资银行股为分析对象 55
2.6 矩阵运算(一)—以全球主要股指为分析对象 59
2.7 矩阵运算(二)—以科创板股票为分析对象 64
2.8 二项分布与几何分布随机抽样—以保险业务为分析对象 68
2.9 正态分布和对数正态分布随机抽样—以石油公司股票为分析对象 72
2.10 伽玛分布和贝塔分布随机抽样—以债券违约率与回收率为分析对象 77
2.11 本章小结 82
第3章 Pandas模块编程的金融案例 83
3.1 创建序列和数据框—以开放式基金为分析对象 84
3.2 导入外部数据文件和导出生成数据文件—以Shibor利率为分析对象 88
3.3 数据框可视化—以上证50指数为分析对象 92
3.4 数据框检索—以沪港通股票为分析对象 98
3.5 数据框缺失值处理—以金砖四国的股票指数为分析对象 102
3.6 数据框拼接—以纽交所上市的央企股票为分析对象 106
3.7 Pandas模块的统计功能(一)—以QDII基金为分析对象 111
3.8 Pandas模块的统计功能(二)—以全球大型银行股票为分析对象 116
3.9 Pandas模块的统计功能(三)—以创业板股票为分析对象 121
3.10 移动窗口与动态统计—以全球主要股指为分析对象 128
3.11 本章小结 133
第4章 Matplotlib模块编程的金融案例 134
4.1 绘制曲线图—以住房按揭贷款为分析对象 135
4.2 绘制垂直条状图和双轴图—以货币政策为分析对象 140
4.3 绘制K线图—以上证综指与深证成指为分析对象 145
4.4 绘制直方图—以同时发行A股和美股的公司股票为分析对象 152
4.5 绘制条形图—以全球主要股指为分析对象 158
4.6 绘制雷达图—以四大国有银行的财务监管指标为分析对象 162
4.7 绘制散点图—以A股和港股的股指为分析对象 167
4.8 绘制饼图—以社会融资规模的结构为分析对象 172
4.9 本章小结 177
第5章 SciPy等模块编程的金融案例 178
5.1 用SciPy模块运算积分—以上市的车企股票为分析对象 179
5.2 用SciPy模块计算插值—以Shibor利率为分析对象 184
5.3 用SciPy模块求解方程组—以中小板股票为分析对象 190
5.4 用SciPy模块求解最优值—以投资者效用为分析对象 193
5.5 SciPy模块的统计功能—以Hibor和Shibor利率为分析对象 198
5.6 用SciPy模块开展随机抽样与统计—以美国金融变量为分析对象 202
5.7 用StatsModels模块构建回归模型—以中国石油股票为分析对象 207
5.8 用arch模块构建波动率模型—以全球主要股指为分析对象 212
5.9 用datetime模块处理时间对象—以银行理财产品为分析对象 220
5.10 本章小结 223
第6章 用Python分析利率与债券的案例 224
6.1 计算不同复利频次的利息—以定期存款为分析对象 225
6.2 基于单一贴现率的债券定价—以国债为分析对象 229
6.3 基于票息剥离法计算零息利率曲线—以国债利率为分析对象 233
6.4 基于不同期限零息利率的债券定价—以金融债和地方债为分析对象 238
6.5 远期利率—以国债为分析对象 241
6.6 远期利率协议现金流—以Libor远期利率协议为分析对象 246
6.7 远期利率协议定价—以Shibor远期利率协议为分析对象 250
6.8 债券麦考利久期—以利率债为分析对象 254
6.9 债券修正久期和美元久期—以央企债券为分析对象 260
6.10 债券凸性—以地方政府债为分析对象 264
6.11 本章小结 270
第7章 用Python分析股票投资的案例 271
7.1 投资组合收益率和波动率—以金融股为分析对象 272
7.2 最优投资组合—以道琼斯指数成分股为分析对象 278
7.3 资本资产定价模型(一)—以交通银行A股为分析对象 283
7.4 资本资产定价模型(二)—以美股为分析对象 290
7.5 服从几何布朗运动的股价模拟—以互联网公司股票为分析对象 296
7.6 A股与H股套利策略—以招商银行股票为分析对象 303
7.7 投资组合绩效评估(一)—以公募基金为分析对象 309
7.8 投资组合绩效评估(二)—以QDII基金为分析对象 316
7.9 本章小结 321
第8章 用Python分析期货套期保值的案例 322
8.1 期货空头套期保值—以上证50指数期货为分析对象 323
8.2 期货多头套期保值—以美元兑人民币期货合约为分析对象 328
8.3 最优套保比率和最优合约数量—以A股股指期货为分析对象 333
8.4 国债期货可交割债券转换因子—以国债为分析对象 341
8.5 国债期货最廉价交割债券—以国债期货TS1906合约为分析对象 346
8.6 基于久期的套期保值策略—以债券和国债期货为分析对象 351
8.7 本章小结 360
第9章 用Python分析期权交易的案例 361
9.1 期权定价与到期盈亏—以腾讯公司股票期权为分析对象 362
9.2 期权希腊字母—以2只上证50ETF期权合约为分析对象 368
9.3 期权对冲策略—以50ETF沽6月2050期权为分析对象 373
9.4 期权隐含波动率—以3只上证50ETF期权为分析对象 379
9.5 单一期权与基础资产交易策略—以50ETF期权和基金为分析对象 385
9.6 期权牛市价差策略—以阴极铜期权为分析对象 391
9.7 期权熊市价差策略—以天然橡胶期权为分析对象 396
9.8 期权盒式价差策略—以4只上证50ETF期权为分析对象 402
9.9 期权蝶式价差策略—以豆粕期权为分析对象 406
9.10 跨式组合与宽跨式组合策略—以白糖期权为分析对象 412
9.11 本章小结 419
第 10章 用Python测度风险价值的案例 420
10.1 方差-协方差法—以公募基金重仓股为分析对象 421
10.2 历史模拟法—以社保基金重仓股为分析对象 427
10.3 蒙特卡洛模拟法—以QFII重仓股为分析对象 431
10.4 风险价值模型合理性检验—以保险资金重仓股为分析对象 437
10.5 投资组合压力测试—以蓝筹股和国债为分析对象 442
10.6 压力风险价值—以伯克希尔 哈撒韦公司重仓股为分析对象 448
10.7 本章小结 456
· · · · · · (收起)
读后感
评分
评分
评分
评分
用户评价
我是一位刚刚进入金融行业的菜鸟,对Python和金融知识都处于初步学习阶段。这本书简直就是我学习路上的“及时雨”。在公司里,我看到很多前辈都在使用Python进行金融分析,我也想跟上大家的步伐,但苦于找不到合适的入门资料。市面上有很多Python教程,但大多侧重于编程本身,而缺乏金融领域的应用;也有很多金融分析的书籍,但又鲜少提及Python。这本书的出现,完美地解决了我的困境。它不仅教会我如何使用Python进行金融数据的处理和可视化,更重要的是,它通过各种实用的金融案例,让我明白了Python在金融分析中的真正价值。我特别欣赏书中对量化交易策略的讲解,它将理论模型与实际代码相结合,让我能够亲手搭建一个属于自己的交易模型,并进行回测和优化。这对于我来说,是一次非常宝贵的实践经验。我也从书中学习到了如何利用Python进行风险管理,比如如何计算VaR(风险价值),这对于理解和控制投资风险至关重要。我深信,通过这本书的学习,我能够快速提升我的金融分析能力,并在未来的工作中脱颖而出,成为一名优秀的金融分析师。
评分这本书的排版和逻辑结构给我留下了深刻的印象。作者在组织内容时,显然是经过了深思熟虑。从基础的Python金融库介绍,到复杂的模型构建,再到实际的案例分析,每一步都衔接得非常自然,让人能够循序渐进地理解和学习。我特别喜欢书中对每一个概念的解释,都力求清晰明了,并且辅以大量的代码示例,这使得抽象的金融概念变得触手可及。通过书中的代码,我不仅能够学习到如何运用Python的各个库,如Pandas、NumPy、Matplotlib等,更能理解这些库在金融分析中的实际作用。例如,在数据处理章节,书中详细讲解了如何使用Pandas高效地清洗、整理和转换金融数据,这对于任何一个希望进行数据驱动的金融分析的人来说,都是至关重要的基础。而图表生成的部分,则让我看到了如何利用Matplotlib和Seaborn将复杂的数据可视化,从而更直观地洞察市场趋势和模型表现。我曾对一些复杂的金融模型感到畏惧,但这本书通过生动的案例和易于理解的代码,将这些模型变得不再遥不可及。我期待通过这本书的学习,能够彻底掌握如何利用Python构建和评估各类金融模型,从而在投资决策中获得更强的信心和更准确的判断。
评分我一直在寻找一本能够将Python编程能力与我的金融知识无缝结合的书籍,而《Python金融实战案例精粹》正是这样一本让我眼前一亮的著作。它没有落入纯粹的技术教程或者理论堆砌的窠臼,而是巧妙地将两者融为一体,通过生动的金融场景,展示了Python在解决实际金融问题时的强大能力。我特别喜欢书中对宏观经济数据分析的案例,它展示了如何利用Python爬取和处理海量的宏观经济数据,并从中提取与投资相关的关键信息。这对于我理解宏观经济对金融市场的影响,以及如何根据宏观趋势调整投资策略,有着非常重要的指导意义。此外,书中对自然语言处理(NLP)在金融领域的应用,也让我感到眼前一亮。它展示了如何利用NLP技术分析新闻报道、社交媒体情绪等非结构化数据,并将其应用于股票市场预测,这让我看到了Python在金融分析中更广阔的应用前景。我相信,通过这本书的学习,我能够将Python编程技能提升到一个新的高度,并在金融分析领域获得更深入的见解和更强的实操能力。
评分这本书的内容深度和广度都给我留下了深刻的印象。它涵盖了从基础的数据处理到复杂的模型构建,再到实际的案例分析,每一个环节都力求做到极致。我特别喜欢书中对资产定价模型的详细讲解,它不仅介绍了各种经典的资产定价模型,更重要的是,它通过Python代码,展示了如何利用这些模型来分析和预测资产的未来收益。我曾对如何进行资产估值感到困惑,而这本书则通过生动的案例和易于理解的代码,让我能够亲手进行资产估值,并分析影响资产价值的各种因素。这不仅提升了我对资产定价的理解,更让我看到了Python在投资分析领域的巨大潜力。我相信,这本书将帮助我构建一个更加系统和完整的金融分析体系,并在投资决策中获得更清晰的思路和更准确的判断。
评分这本书的封面设计就给我一种沉稳又专业的感受,金色的字体在深蓝色的封面上熠熠生辉,仿佛预示着书中蕴含着价值非凡的金融知识。我一直对金融领域抱有浓厚的兴趣,尤其是在Python日益普及的今天,能够将编程的强大与金融分析相结合,是我一直渴望掌握的技能。在翻阅这本书之前,我曾尝试过一些零散的Python金融教程,但总感觉缺乏系统性和深度,难以形成完整的知识体系。这本书的出现,恰好填补了这一空白。我被它“实战案例精粹”的定位深深吸引,这意味着它不会停留在理论层面,而是会通过真实的案例,手把手地教我如何在实际操作中运用Python进行金融分析。我迫不及待地想要探索书中是如何通过Python来解决那些令人头疼的金融问题,比如如何构建量化交易模型、如何进行风险管理、又或者如何从海量数据中提取有价值的投资信号。我相信,这本书将会为我打开一扇通往Python金融世界的大门,让我能够将理论知识转化为实际的投资能力,从而在瞬息万变的金融市场中游刃有余。我尤其期待书中能够展示一些前沿的金融技术,比如机器学习在投资组合优化中的应用,或者深度学习在预测股票价格方面的潜力。能够通过一本书的学习,将这些高深的技术掌握并应用于实际,对我而言将是莫大的成就。
评分这本书的作者显然是一位经验丰富的金融从业者,他对金融市场的理解以及对Python在金融领域应用的熟练程度,在书中得到了充分的体现。我特别欣赏书中对风险管理的深入探讨,它不仅介绍了各种风险度量指标,更重要的是,它通过具体的Python代码,展示了如何利用这些指标来评估和管理投资组合的风险。例如,书中对蒙特卡洛模拟在VaR计算中的应用,让我对如何量化和预测极端市场风险有了更清晰的认识。我曾对如何构建一个稳健的投资组合感到困惑,而这本书则通过详细的案例,展示了如何结合历史数据和风险模型,来构建一个能够适应不同市场环境的投资组合。这对于我理解投资组合的有效前沿,以及如何在其上进行优化,提供了非常重要的实践指导。我相信,这本书将帮助我建立起一个更加科学和理性的投资分析框架,并在金融投资的道路上走得更远、更稳健。
评分在金融投资领域,数据的分析和利用是成功的关键。这本书在这方面做得尤为出色。我一直认为,盲目的投资行为是不可取的,必须基于深入的数据分析和严谨的模型。这本书正是提供了这样一个平台。它不仅教会我如何获取和清洗金融数据,更重要的是,它通过大量的实战案例,展示了如何利用Python的强大功能来挖掘数据中的潜在价值。我特别欣赏书中关于因子投资策略的讲解,它详细阐述了如何利用Python来识别和构建影响股票收益的各种因子,并将其应用于投资组合的构建和优化。这对于我理解金融市场的运作逻辑,以及如何构建更具韧性的投资组合,提供了非常重要的启示。此外,书中对时间序列分析方法的介绍,也让我对预测金融数据的变化有了更深入的理解。我期待通过学习这本书,能够掌握更多高级的数据分析技术,从而在投资决策中获得更具竞争力的优势,并且能够更好地规避风险,实现资产的稳健增长。
评分我是一位对金融科技(FinTech)领域充满热情的研究者,我一直关注着Python在金融行业的应用。这本书的出现,为我提供了一个非常好的学习和实践平台。我特别欣赏书中关于交易算法开发的案例,它详细阐述了如何利用Python构建和回测各种交易策略,并优化交易参数。这对于我理解量化交易的底层逻辑,以及如何设计更有效的交易系统,提供了非常重要的启示。我曾对如何将机器学习技术应用于交易策略感到好奇,而这本书则通过具体的案例,展示了如何利用Python实现这一目标。它不仅教会我如何选择合适的机器学习模型,更重要的是,它让我理解了如何将这些模型集成到交易系统中,并进行实时的交易决策。我相信,这本书将帮助我深入理解金融科技的前沿技术,并为我未来的研究和工作提供宝贵的实践经验。
评分我一直认为,理论知识必须与实践相结合才能发挥最大的价值。这本书恰恰做到了这一点。它不仅仅是理论的讲解,更是将理论应用于实际的案例分析,并通过Python代码进行实现。我特别喜欢书中关于客户细分和信用评分模型的案例。它展示了如何利用Python进行数据挖掘,找出影响客户行为的关键因素,并构建预测模型。这对于我理解金融机构如何进行风险定价和营销策略制定,有着非常重要的启发。我曾对如何评估客户的信用风险感到困惑,而这本书通过生动的案例和易于理解的代码,让我能够亲手构建信用评分模型,并对其进行评估和优化。这不仅提升了我对信用风险管理的理解,更让我看到了Python在金融风控领域的巨大应用潜力。我相信,这本书将成为我学习金融分析和数据科学的有力助手,帮助我更好地理解和应对金融市场中的各种挑战。
评分这本书给我带来的最大惊喜,是它将复杂的金融概念以如此直观和易于理解的方式呈现出来。作为一名对金融理论有一定了解,但编程经验相对较少的读者,我曾经担心会难以跟上书中技术的步伐。然而,作者通过精心设计的案例和清晰的代码注释,打消了我的疑虑。书中对期权定价模型(如Black-Scholes模型)的Python实现,让我第一次真正理解了这些模型的数学原理以及如何在实际中进行应用。我曾对金融衍生品的定价感到困惑,而这本书则通过实操,将这些理论化为可执行的代码,让我能够亲自计算期权价格,并分析影响期权价值的各种因素。这不仅提升了我对金融衍生品的理解,更让我看到了Python在金融工程领域的巨大潜力。我尤其看重书中关于投资组合风险和收益优化的章节,它通过实际的代码演示,展示了如何利用Python构建最优化的投资组合,以在承担可控风险的前提下,最大化投资回报。我相信,这本书将成为我深入理解金融工程和量化投资的宝贵工具。
评分 评分 评分 评分 评分相关图书





本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有