

具体描述
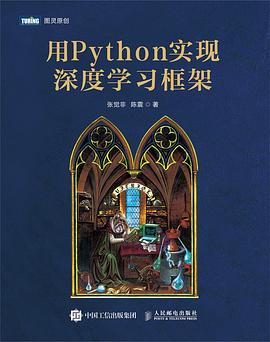
本书带领读者用原生Python语言和Numpy线性代数库实现一个基于计算图的深度学习框架MatrixSlow(类似简易版的PyTorch、TensorFlow或Caffe)。全书分为三个部分。第一部分是原理篇,实现了MatrixSlow框架的核心基础设施,并基于此讲解了机器学习与深度学习的概念和原理,比如模型、计算图、训练、梯度下降法及其各种变体。第二部分是模型篇,介绍了多种具有代表性的模型,包括逻辑回归、多层全连接神经网络、因子分解机、Wide & Deep、DeepFM、循环神经网络以及卷积神经网络,这部分除了着重介绍这些模型的原理、结构以及它们之间的联系外,还用MatrixSlow框架搭建并训练它们以解决实际问题。第三部分是工程篇,讨论了一些与深度学习框架相关的工程问题,内容涉及训练与评估,模型的保存、导入和服务部署,分布式训练,等等。
作者简介
张觉非
本科毕业于复旦大学计算机系,于中国科学院古脊椎动物与古人类研究所取得古生物学硕士学位,目前在互联网行业从事机器学习算法相关工作。
陈震
硕士毕业于北京大学。现任奇虎360智能工程部总监、负责人,带领团队建设集团的机器学习计算调度平台、机器学习建模平台、机器学习推理引擎以及推荐平台等AI基础设施。
目录信息
第1章 机器学习与模型 2
1.1 模型 2
1.2 参数与训练 4
1.3 损失函数 9
1.4 计算图的训练 10
1.5 小结 12
第2章 计算图 13
2.1 什么是计算图 13
2.2 前向传播 14
2.3 函数优化与梯度下降法 18
2.4 链式法则与反向传播 29
2.5 在计算图上执行梯度下降法 36
2.6 节点类及其子类 36
2.7 用计算图搭建ADALINE并训练 44
2.8 小结 48
第3章 优化器 49
3.1 优化流程的抽象实现 49
3.2 BGD、SGD和MBGD 53
3.3 梯度下降优化器 58
3.4 朴素梯度下降法的局限 60
3.5 冲量优化器 61
3.6 AdaGrad优化器 62
3.7 RMSProp优化器 64
3.8 Adam优化器 65
3.9 小结 68
第二部分 模型篇
第4章 逻辑回归 70
4.1 对数损失函数 70
4.2 Logistic函数 73
4.3 二分类逻辑回归 75
4.4 多分类逻辑回归 78
4.5 交叉熵 81
4.6 实例:鸢尾花 85
4.7 小结 88
第5章 神经网络 90
5.1 神经元与激活函数 90
5.2 神经网络 95
5.3 多层全连接神经网络 99
5.4 多个全连接层的意义 101
5.5 实例:鸢尾花 108
5.6 实例:手写数字识别 110
5.7 小结 116
第6章 非全连接神经网络 117
6.1 带二次项的逻辑回归 117
6.2 因子分解机 124
6.3 Wide & Deep 132
6.4 DeepFM 137
6.5 实例:泰坦尼克号幸存者 141
6.6 小结 150
第7章 循环神经网络 151
7.1 RNN的结构 151
7.2 RNN的输出 152
7.3 实例:正弦波与方波 155
7.4 变长序列 159
7.5 实例:3D电磁发音仪单词识别 164
7.6 小结 167
第8章 卷积神经网络 168
8.1 蒙德里安与莫奈 168
8.2 滤波器 170
8.3 可训练的滤波器 176
8.4 卷积层 183
8.5 池化层 186
8.6 CNN的结构 189
8.7 实例:手写数字识别 190
8.8 小结 194
第三部分 工程篇
第9章 训练与评估 196
9.1 训练和Trainer训练器 196
9.2 评估和Metrics节点 202
9.3 混淆矩阵 204
9.4 正确率 204
9.5 查准率 206
9.6 查全率 206
9.7 ROC曲线和AUC 208
9.8 小结 211
第10章 模型保存、预测和服务 212
10.1 模型保存 213
10.2 模型加载和预测 216
10.3 模型服务 216
10.4 客户端 222
10.5 小结 223
第11章 分布式训练 224
11.1 分布式训练的原理 224
11.2 基于参数服务器的架构 230
11.3 Ring AllReduce原理 241
11.4 Ring AllReduce架构实现 248
11.5 分布式训练性能评测 257
11.6 小结 259
第12章 工业级深度学习框架 261
12.1 张量 262
12.2 计算加速 263
12.3 GPU 265
12.4 数据接口 266
12.5 模型并行 266
12.6 静态图和动态图 267
12.7 混合精度训练 268
12.8 图优化和编译优化 270
12.9 移动端和嵌入式端 270
12.10 小结 271
· · · · · · (收起)
读后感
评分
评分
评分
评分
用户评价
拿到这本书后,我首先翻阅了目录结构,对作者的编排思路感到非常赞赏。它似乎没有急于去堆砌复杂的模型,而是选择了一条更加务实的路径:先夯实基础,再逐步向上构建。我注意到它花了相当篇幅介绍**Python的底层特性如何服务于高性能计算**,这一点非常关键。深度学习框架的性能瓶颈往往隐藏在数据结构和内存管理中,作者是否有效地利用了NumPy的向量化优势,又在何时引入JIT编译(如Numba)或者C/C++的接口(如Cython)来优化核心算子,这些细节决定了框架的实用价值。我特别想知道它在**自定义层和损失函数**的设计上提供了何种范式,一个好的框架应该提供足够的灵活性,让研究人员能够快速迭代新的想法,而不是被固定的接口所束缚。如果书中能通过一个或两个完整的、但又不至于过于复杂的示例(比如一个小型CNN或RNN),将从数据加载、前向传播、损失计算到参数更新的全流程串联起来,并对每一步的性能考量进行深入分析,那么这本书的价值就远超一本简单的编程指南了。
评分这本书的“实现”二字让我联想到很多关于**底层数学库选型**的决策点。作者最终选择了哪种方式来处理底层矩阵乘法和线性代数运算?是完全依赖NumPy,还是试图引入更底层的库来提高速度?我更希望看到作者能够讨论**不同优化器(如SGD, Adam, RMSProp)的Python实现细节**,特别是它们如何与自动微分的结果相结合来更新权重,以及这些优化器在代码层面的差异化实现。一个框架的健壮性还体现在其对**边缘情况的处理**上,比如输入数据的维度不匹配、初始化方法的选择对收敛的影响等。如果书中能通过具体的代码示例,展示如何优雅地处理这些常见的“陷阱”并提供清晰的错误提示,而非仅仅抛出难以理解的底层异常,那么这本书的教育意义将非常深远。我希望读完后,我不仅知道如何用框架,更知道框架的每一步决策背后的取舍和理由。
评分从一个实际应用开发者的角度来看,我对这本书中关于**框架的工程化和调试性**的讨论非常感兴趣。理论模型固然重要,但在实际工作中,我们花费大量时间在模型调试和性能分析上。这本书是否涉及了如何**可视化计算图**的初步思路?当模型出现梯度爆炸或消失时,框架本身提供了哪些内置的诊断工具或钩子(hooks)来帮助用户追踪问题?此外,一个现代框架必须具备良好的**模块化和扩展性**。作者是如何组织代码结构的?是否遵循了清晰的接口设计原则,使得后续的贡献者或使用者可以方便地插入新的优化器、正则化技术或者新的层类型?如果书中能提供一些关于**性能瓶颈分析的入门技巧**,比如如何使用Python自带的Profiler工具来定位框架内部的慢速函数,这将使这本书的实用价值倍增,因为它将教会我们如何构建一个“可维护”的深度学习系统,而不仅仅是“能运行”的系统。
评分我关注的重点在于**自动微分(Autodiff)机制的实现**。这是现代深度学习框架的灵魂所在,也是最考验设计功力的地方。我希望能看到作者如何巧妙地平衡代码的可读性与计算效率。仅仅是基于链式法则的简单递归实现是不够的,一个成熟的框架需要处理好**动态图与静态图的权衡**,或者至少要清晰地解释它选择了哪一种范式以及背后的原因。例如,它如何管理计算历史栈?如何确保在进行大量操作时,内存占用是可控的?书中是否有探讨如何实现稀疏梯度处理,或者在特定硬件(如GPU)上进行操作分发和并行计算的初步概念?这些都是区分“玩具框架”和“可用框架”的关键点。如果作者能够提供一个清晰的图示,展示一个复杂的计算图是如何被构建、遍历并最终求解出梯度的,我会感到非常满意。我期待它能揭示那些隐藏在`backward()`函数背后的魔术,让我真正理解导数的流动。
评分这本书的上市让我眼前一亮,我一直期待能有一本能深入浅出地讲解如何**从零开始构建一个深度学习框架**的中文书籍。我之前阅读了一些国外经典教材,虽然理论很扎实,但在动手实践、理解底层实现细节上总觉得隔了一层纱。这本书的标题直接点明了核心价值——“用Python实现”,这正是我需要的,它意味着我们不是停留在调用TensorFlow或PyTorch的高级API层面,而是要深入到张量运算、自动微分、层结构定义这些构建块。我特别关注的是它如何处理**反向传播的数学原理与代码实现的对应关系**,一个好的实现框架必须能清晰地展示梯度是如何一步步计算并回传的。如果它能详尽地剖析矩阵运算如何映射到计算图的反向流程,那将是巨大的加分项。我希望看到清晰的模块划分,比如如何设计一个灵活的`Tensor`类来支持基本运算和梯度追踪,如何搭建一个可以动态构建和执行计算图的引擎。我对那些只停留在使用现成库的“教程”已经厌倦了,这本书如果能真正教会读者“造轮子”,理解框架设计的精妙之处,那么它无疑会成为我书架上的常青树,为我未来的研究和项目打下坚实的基础。
评分"What I cannot create, I do not understand". 作者从头开始一步一步造了个轮子,对于加深对轮子的理解大有裨益!
评分把文字复杂化了,真没必要,看看鱼书就够了
评分"What I cannot create, I do not understand". 作者从头开始一步一步造了个轮子,对于加深对轮子的理解大有裨益!
评分这本书作为开拓视野了解知识点是可以的,但是实际内容没有名字写的那么🐮🍺,更适合作为写深度学习框架的引子,还需要读其他别的“很多”书才行
评分这本书作为开拓视野了解知识点是可以的,但是实际内容没有名字写的那么🐮🍺,更适合作为写深度学习框架的引子,还需要读其他别的“很多”书才行
相关图书







本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有