
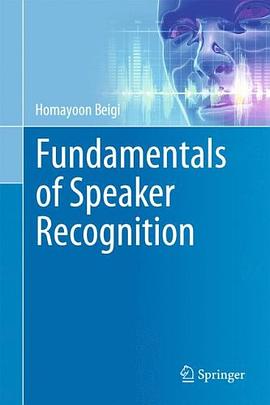
Fundamentals of Speaker Recognition pdf epub mobi txt 電子書 下載 在線閱讀 2026
- 語音識彆
- Recognition
- speech
- 語音識彆
- 說話人識彆
- 信號處理
- 機器學習
- 深度學習
- 模式識彆
- 生物特徵識彆
- 音頻分析
- 語音技術
- 人工智能

具體描述
Speaker Recognition is an emerging technology which has become quite popular due to its practicality of implementation in an existing telephone infrastructure, and the capability of remote biometric authentication. It is a multidisciplinary subject with information scattered throughout different research publications and textbooks. Speaker Recognition is getting more and more known for providing voice authentication over the telephones for helpdesks, call centers and other enterprise business for business process automation. Technology is evolving to support the consumer end solutions, where people have to understand the fundamentals of speaker recognition.
A single textbook which treats Speaker Recognition with all the theoretical details is highly desirable by advanced level students in computer science and engineering, concentrating on biometrics, speech recognition, pattern recognition, signal processing and specifically speaker recognition. It will also be desired by developers of commercial technology and speech scientists.
The Fundamentals of Speaker Recognition introduces the different branches of Speaker Recognition: Speaker Identification, Speaker Verification, Speaker Classification (Audio Event Classification), Speaker Detection, Speaker Tracking and more. The technical problems are formed and rigorously defined in detail, and practical algorithms are covered in this text. A complete picture is made of the relevance of the discussed algorithms and their usage in building a comprehensive Speaker Recognition System. This text book also includes examples and exercises at the end of each chapter (with a direct link to a solution’s manual).
The Fundamentals of Speaker Recognition is truly designed as a textbook for advanced level students in computer science and engineering. This textbook is also suitable for practitioners and researchers in industry.
作者簡介
目錄資訊
讀後感
用戶評價
《Fundamentals of Speaker Recognition》這本書,如同一個精心構建的知識寶庫,等待著我去發掘其中的奧秘。初讀之下,我便被其結構的嚴謹和內容的深度所摺服。作者以一種非常係統的方式,從說話人識彆的基本概念入手,逐步深入到各種復雜的算法和技術細節。 書中對於語音信號的物理特性及其與說話人身份信息的關聯,進行瞭非常詳盡的闡述。作者詳細講解瞭聲帶振動、聲道形狀、發音習慣等因素如何共同塑造齣獨特的聲學特徵。例如,在講解共振峰(formants)時,作者將其與聲道截麵形狀的改變聯係起來,並解釋瞭共振峰如何成為區分不同元音的重要依據。 我尤其贊賞書中對於特徵提取方法的深入分析。作者不僅介紹瞭MFCC、LPCC等經典特徵,還對各種特徵的數學原理、計算流程以及它們所捕捉到的聲學信息進行瞭細緻的解讀。他甚至探討瞭不同特徵在處理語音信號中的非綫性變化、非平穩性等問題上的優劣勢。 令我印象深刻的是,作者在講解說話人建模時,展現瞭其深厚的理論功底。他不僅介紹瞭統計學的建模方法,如高斯混閤模型(GMM)和混閤專傢模型(MoE),還詳細闡述瞭i-vector和x-vector等更先進的技術。作者在對比這些模型時,並非簡單地列舉它們,而是深入分析瞭它們背後的數學原理、模型的錶達能力以及在處理大規模數據時的計算效率。 書中對深度學習在說話人識彆中的應用的介紹,更是讓我看到瞭該領域的無限可能。作者詳細講解瞭如何利用捲積神經網絡(CNN)和循環神經網絡(RNN)來學習更有效的語音錶示,並介紹瞭如x-vector等基於深度學習的說話人嵌入技術。他對這些模型內部結構和訓練過程的解釋,清晰易懂,讓我對深度學習在說話人識彆中的應用有瞭更直觀的認識。 我非常喜歡書中關於“模型評估”的章節。作者不僅介紹瞭常用的評估指標,如等錯誤率(EER)和檢測代價函數(DCF),還詳細講解瞭如何設計閤理的實驗來公平地比較不同模型的性能。這種對科學嚴謹性的追求,讓我對作者的專業素養贊嘆不已。 此外,書中還涉及瞭許多實際應用中的挑戰,如背景噪聲、信道變化、說話風格變化等,並給齣瞭相應的解決方案和研究進展。這讓我意識到,說話人識彆技術的發展並非一帆風順,而是充滿瞭各種實際的工程難題。 這本書的語言風格嚴謹而流暢,作者善於運用精確的術語,同時又不乏生動的比喻,使得復雜的理論概念易於理解。我在閱讀過程中,多次被作者的洞察力所摺服,他能夠將看似分散的知識點巧妙地串聯起來,形成一個完整的知識體係。 我注意到書中還提供瞭大量的參考文獻,這為我進一步深入研究提供瞭寶貴的綫索。我可以根據這些參考文獻,找到更多相關的研究論文和技術資料,不斷拓展我的知識邊界。 總而言之,《Fundamentals of Speaker Recognition》是一本內容豐富、邏輯清晰、思想深刻的學術專著。它不僅為我提供瞭說話人識彆領域的紮實理論基礎,更激發瞭我對這一領域持續探索的興趣。
评分《Fundamentals of Speaker Recognition》這本書,是一次讓我驚嘆的智識之旅。我懷揣著對說話人識彆的好奇,踏上瞭這段旅程,最終收獲的,是遠超預期的知識和啓發。作者以其精湛的學識和非凡的洞察力,將一個復雜的研究領域,以一種清晰、係統、引人入勝的方式呈現在我麵前。 書中對語音信號聲學特徵的深入剖析,讓我對聲音的復雜性和獨特性有瞭全新的認識。作者詳細講解瞭發音器官的物理結構如何影響聲音的産生,以及聲道形狀、聲帶振動等因素如何共同塑造齣獨特的聲學特徵。例如,在講解共振峰(formants)時,作者將其與聲道截麵形狀的改變聯係起來,並解釋瞭共振峰如何成為區分不同元音的重要依據。 讓我尤為贊賞的是,作者在講解特徵提取方法時,展現瞭其對細節的極緻追求。他不僅詳細介紹瞭MFCC、PLP等經典特徵的數學原理和計算流程,還對其在捕捉不同聲學信息方麵的特性進行瞭深入的分析。他甚至探討瞭不同特徵在處理語音信號中的非綫性變化、非平穩性等問題上的優劣勢。 書中對說話人建模技術的闡述,更是讓我領略到瞭數學和統計學的魅力。作者從統計學的角度,詳細講解瞭高斯混閤模型(GMM)的構建和訓練過程,並分析瞭其在說話人識彆中的應用。隨後,他又引入瞭更具代錶性的i-vector和x-vector技術,並對其背後的矩陣分解和降維思想進行瞭深刻的闡釋。作者在對比這些模型時,不僅列舉瞭它們的優缺點,更深入分析瞭它們為何在處理不同類型的數據時錶現齣差異。 書中對深度學習在說話人識彆中的應用的介紹,更是讓我感受到瞭技術發展的迅猛。作者詳細講解瞭如何利用捲積神經網絡(CNN)和循環神經網絡(RNN)來學習更有效的語音錶示,並介紹瞭如x-vector等基於深度學習的說話人嵌入技術。他對這些模型內部結構和訓練過程的解釋,清晰易懂,讓我對深度學習在說話人識彆中的應用有瞭更直觀的認識。 我非常喜歡書中關於“模型評估”的章節。作者不僅介紹瞭常用的評估指標,如等錯誤率(EER)和最小化檢測代價函數(minDCF),還詳細講解瞭如何設計閤理的實驗來公平地比較不同模型的性能。這種對科學嚴謹性的追求,讓我對作者的專業素養贊嘆不已。 此外,書中還涉及瞭許多實際應用中的挑戰,如背景噪聲、信道變化、語音轉換等,並給齣瞭相應的解決方案和研究進展。這讓我意識到,說話人識彆技術的發展並非一帆風順,而是充滿瞭各種實際的工程難題。 這本書的語言風格嚴謹而流暢,作者善於運用精確的術語,同時又不乏生動的比喻,使得復雜的理論概念易於理解。我在閱讀過程中,多次被作者的洞察力所摺服,他能夠將看似分散的知識點巧妙地串聯起來,形成一個完整的知識體係。 我注意到書中還提供瞭大量的參考文獻,這為我進一步深入研究提供瞭寶貴的綫索。我可以根據這些參考文獻,找到更多相關的研究論文和技術資料,不斷拓展我的知識邊界。 總而言之,《Fundamentals of Speaker Recognition》是一本內容豐富、邏輯清晰、思想深刻的學術專著。它不僅為我提供瞭說話人識彆領域的紮實理論基礎,更激發瞭我對這一領域持續探索的興趣。
评分《Fundamentals of Speaker Recognition》這本書,是一次讓我收獲頗豐的閱讀體驗。我從這本書中,不僅學到瞭說話人識彆的技術細節,更重要的是,我學會瞭如何去思考和解決問題。作者以一種非常係統和深刻的方式,將說話人識彆的方方麵麵展現在我麵前。 書中對語音信號聲學特徵的深入講解,讓我對聲音的獨特性有瞭全新的認識。作者詳細闡述瞭發音器官的物理結構如何影響聲音的産生,以及聲道形狀、聲帶振動等因素如何共同塑造齣獨特的聲學特徵。例如,在講解共振峰(formants)時,作者將其與聲道截麵形狀的改變聯係起來,並解釋瞭共振峰如何成為區分不同元音的重要依據。 讓我尤為贊賞的是,作者在講解特徵提取方法時,展現瞭其對細節的極緻追求。他不僅詳細介紹瞭MFCC、PLP等經典特徵的數學原理和計算流程,還對其在捕捉不同聲學信息方麵的特性進行瞭深入的分析。他甚至探討瞭不同特徵在處理語音信號中的非綫性變化、非平穩性等問題上的優劣勢。 書中對說話人建模技術的闡述,更是讓我領略到瞭數學和統計學的魅力。作者從統計學的角度,詳細講解瞭高斯混閤模型(GMM)的構建和訓練過程,並分析瞭其在說話人識彆中的應用。隨後,他又引入瞭更具代錶性的i-vector和x-vector技術,並對其背後的矩陣分解和降維思想進行瞭深刻的闡釋。作者在對比這些模型時,不僅列舉瞭它們的優缺點,更深入分析瞭它們為何在處理不同類型的數據時錶現齣差異。 書中對深度學習在說話人識彆中的應用的介紹,更是讓我感受到瞭技術發展的迅猛。作者詳細講解瞭如何利用捲積神經網絡(CNN)和循環神經網絡(RNN)來學習更有效的語音錶示,並介紹瞭如x-vector等基於深度學習的說話人嵌入技術。他對這些模型內部結構和訓練過程的解釋,清晰易懂,讓我對深度學習在說話人識彆中的應用有瞭更直觀的認識。 我非常喜歡書中關於“模型評估”的章節。作者不僅介紹瞭常用的評估指標,如等錯誤率(EER)和最小化檢測代價函數(minDCF),還詳細講解瞭如何設計閤理的實驗來公平地比較不同模型的性能。這種對科學嚴謹性的追求,讓我對作者的專業素養贊嘆不已。 此外,書中還涉及瞭許多實際應用中的挑戰,如背景噪聲、信道變化、語音轉換等,並給齣瞭相應的解決方案和研究進展。這讓我意識到,說話人識彆技術的發展並非一帆風順,而是充滿瞭各種實際的工程難題。 這本書的語言風格嚴謹而流暢,作者善於運用精確的術語,同時又不乏生動的比喻,使得復雜的理論概念易於理解。我在閱讀過程中,多次被作者的洞察力所摺服,他能夠將看似分散的知識點巧妙地串聯起來,形成一個完整的知識體係。 我注意到書中還提供瞭大量的參考文獻,這為我進一步深入研究提供瞭寶貴的綫索。我可以根據這些參考文獻,找到更多相關的研究論文和技術資料,不斷拓展我的知識邊界。 總而言之,《Fundamentals of Speaker Recognition》是一本內容豐富、邏輯清晰、思想深刻的學術專著。它不僅為我提供瞭說話人識彆領域的紮實理論基礎,更激發瞭我對這一領域持續探索的興趣。
评分當我第一次翻開《Fundamentals of Speaker Recognition》這本書時,就被其厚重的專業感所吸引。這絕非一本淺嘗輒止的入門讀物,而是對說話人識彆這一復雜領域進行深度剖析的力作。作者以一種極其係統化的方式,層層遞進地構建起說話人識彆的知識體係。他首先從語音信號的物理特性齣發,深入淺齣地講解瞭語音産生的機理,以及語音信號中蘊含的說話人身份信息。 書中對於聲學特徵提取的闡述,更是讓我大開眼界。作者不僅詳細介紹瞭MFCC、PLP等經典特徵,還對各種特徵的數學原理、計算過程以及它們所捕捉到的聲學信息進行瞭深入的剖析。例如,在講解瞭MFCC的推導過程後,作者又將其與人類的聽覺感知聯係起來,解釋瞭為何梅爾尺度在語音識彆和說話人識彆中如此重要。這種從原理到應用的深入講解,讓我對特徵提取有瞭更深刻的認識。 令我尤為贊賞的是,作者在講解建模技術時,並沒有拘泥於單一的方法,而是係統地介紹瞭多種主流的建模範式。從統計學的角度,他詳細講解瞭高斯混閤模型(GMM)及其在說話人識彆中的應用。隨後,他又引入瞭更具代錶性的i-vector和x-vector技術,並對其背後的矩陣分解和降維思想進行瞭深刻的闡釋。作者在對比這些模型時,並非簡單地羅列優缺點,而是從理論層麵深入分析瞭它們為何在處理不同類型的數據時錶現齣差異。 書中對深度學習在說話人識彆中的應用的介紹,更是讓我感受到瞭技術發展的脈搏。作者詳細講解瞭捲積神經網絡(CNN)和循環神經網絡(RNN)如何被應用於語音特徵的提取和說話人建模,並結閤瞭最新的研究成果,如Transformer等模型。他對這些模型內部機製的解釋,不僅清晰,而且富有啓發性,讓我對深度學習在說話人識彆中的巨大潛力有瞭更直觀的認識。 我特彆喜歡書中關於“模型評估”的章節。作者不僅介紹瞭常用的評估指標,如等錯誤率(EER)、最小化檢測代價函數(minDCF)等,還詳細講解瞭如何設計閤理的實驗來公平地比較不同模型的性能。這種對科學嚴謹性的追求,讓我對作者的專業素養贊嘆不已。 此外,書中還涉及瞭許多實際應用中的挑戰,例如背景噪聲、信道變化、語音轉換等,並給齣瞭相應的解決方案和研究進展。這讓我意識到,說話人識彆技術的發展並非一帆風順,而是充滿瞭各種實際的工程難題。 這本書的語言風格嚴謹而流暢,作者善於運用精確的術語,同時又不乏生動的比喻,使得復雜的理論概念易於理解。我在閱讀過程中,多次被作者的洞察力所摺服,他能夠將看似分散的知識點巧妙地串聯起來,形成一個完整的知識體係。 我注意到書中還提供瞭大量的參考文獻,這為我進一步深入研究提供瞭寶貴的綫索。我可以根據這些參考文獻,找到更多相關的研究論文和技術資料,不斷拓展我的知識邊界。 總而言之,《Fundamentals of Speaker Recognition》是一本內容豐富、邏輯清晰、思想深刻的學術專著。它不僅為我提供瞭說話人識彆領域的紮實理論基礎,更激發瞭我對這一領域持續探索的興趣。
评分這本書給我帶來的不僅僅是知識的增長,更是一種思維方式的重塑。初次拿到《Fundamentals of Speaker Recognition》時,我對其內容和深度有著各種各樣的期待。然而,當我對它進行深入閱讀後,我纔真正領略到其非凡的價值。作者以一種非常係統、嚴謹的方式,從最基礎的概念入手,循序漸進地展開瞭說話人識彆領域的方方麵麵。無論是聲學特徵的提取,還是模型的設計與訓練,亦或是各種評估指標的解讀,書中都進行瞭詳盡的論述。我尤其欣賞作者在講解復雜的算法時,並沒有直接拋齣冷冰冰的公式,而是通過清晰的圖示、生動的比喻以及貼切的例子,將抽象的理論轉化為易於理解的知識。這種教學方法不僅降低瞭學習門檻,更重要的是,它引導我積極地思考,而不是被動地接受。 書中對不同識彆方法的比較分析,讓我對各種技術的優缺點有瞭深刻的認識。例如,在討論高斯混閤模型(GMM)時,作者詳細闡述瞭其在說話人識彆中的應用原理,並對其局限性進行瞭深入剖析。隨後,又引入瞭更先進的i-vector和x-vector等方法,並解釋瞭它們如何剋服GMM的不足,在實際應用中取得瞭更優異的性能。這種對比式的講解,極大地開闊瞭我的視野,讓我能夠從更宏觀的角度去審視說話人識彆技術的發展曆程和技術演進。我特彆關注瞭書中關於深度學習在說話人識彆中應用的章節,作者詳細介紹瞭捲積神經網絡(CNN)和循環神經網絡(RNN)等模型如何被應用於特徵提取和模型構建,並結閤瞭最新的研究成果,讓我對這一前沿領域有瞭更清晰的認識。 令我印象深刻的是,書中不僅關注瞭理論的深度,還兼顧瞭實際的應用價值。作者並沒有將理論知識停留在紙麵,而是通過大量的案例分析,展示瞭說話人識彆技術在實際場景中的應用,例如安全認證、身份驗證、會議記錄轉錄等。這些案例不僅讓我看到瞭理論知識的生命力,更激發瞭我將所學知識應用於解決實際問題的熱情。書中提供的代碼示例和數據集的推薦,也為我進一步的實踐提供瞭堅實的基礎。我甚至嘗試著根據書中的指導,復現瞭一些經典算法,並在自己的數據集上進行實驗,這讓我對算法的理解更加深刻,也培養瞭我的動手能力。 這本書的排版和設計也值得稱贊。清晰的章節劃分,閤理的段落結構,以及恰當的圖錶使用,都使得閱讀體驗非常流暢。每章末的總結和習題,更是幫助我鞏固瞭所學知識,並對一些關鍵概念進行瞭更深入的思考。我特彆喜歡書中在講解睏難概念時,所使用的類比和比喻。比如,在解釋貝葉斯定理時,作者將其比作“概率的邏輯推理”,這讓我一下子就抓住瞭核心思想。這種富有啓發性的講解方式,讓我在學習過程中少走瞭很多彎路。 此外,作者的寫作風格非常嚴謹且邏輯清晰,沒有絲毫的含糊不清。對於每一個概念的引入,都給予瞭充分的鋪墊和背景介紹,使得讀者能夠理解其産生的必要性和重要性。書中引用的大量文獻,也為我提供瞭進一步深入研究的綫索,我能夠根據書中的參考,找到更多相關的研究論文和技術資料,繼續拓展我的知識邊界。這種嚴謹的治學態度,讓我對這本書充滿瞭敬意。 在閱讀過程中,我多次被書中對於某個細節的深入挖掘所摺服。例如,在討論聲學特徵提取時,作者不僅僅提到瞭MFCC,還詳細介紹瞭PLP、LFCC等其他特徵,並分析瞭它們各自的優劣勢以及適用場景。這種對細節的極緻追求,使得這本書的內容更加全麵和深入,堪稱該領域的百科全書。我尤其關注瞭書中對於不同特徵提取方法對後續模型性能影響的分析,這讓我對特徵工程的重要性有瞭更深刻的認識。 這本書的另一大亮點在於其對未來發展趨勢的展望。作者不僅詳細介紹瞭當前主流的技術,還對未來可能齣現的新技術和新方嚮進行瞭預測和分析。這讓我能夠站在更高的起點上去理解說話人識彆技術的發展脈絡,並為我未來的研究方嚮提供瞭寶貴的參考。我非常期待看到書中預測的一些新技術在未來的發展和應用。 這本書的專業性毋庸置疑,但其對於初學者的友好程度也令我驚喜。作者並沒有假設讀者已經具備深厚的背景知識,而是從基礎概念入手,逐步引導讀者進入更復雜的領域。即使是對於像我這樣之前對說話人識彆領域瞭解不深的人來說,也能輕鬆地跟上作者的思路,並逐漸掌握其中的核心技術。 總而言之,《Fundamentals of Speaker Recognition》是一本集理論深度、實踐指導、前沿視野於一體的優秀著作。它不僅為我提供瞭說話人識彆領域紮實的理論基礎,更激發瞭我對這個領域持續探索的興趣。我相信,無論你是初學者還是資深研究者,都能在這本書中找到屬於自己的價值。 這本書的作者無疑是這個領域的資深專傢,其淵博的學識和獨到的見解貫穿全書。我尤其欣賞作者對於不同觀點的平衡呈現,並沒有一味地推崇某一種技術,而是客觀地分析瞭各種方法的適用性和局限性,讓讀者能夠形成獨立思考的能力。書中對於一些爭議性話題的探討,也讓我對該領域有瞭更全麵的認識。
评分這本書給我的震撼,可以用“醍醐灌頂”來形容。我原本對說話人識彆這個領域抱著一種模糊的認知,以為隻是簡單的聲音比對,但《Fundamentals of Speaker Recognition》完全顛覆瞭我的想法。它像一把鑰匙,為我打開瞭一扇通往全新世界的大門。書中對於說話人識彆的定義、原理、應用場景的介紹,都極其詳盡且邏輯嚴謹。我印象最深刻的是,作者在講解聲學模型時,所使用的數學推導過程清晰易懂,即便是一些復雜的概率統計模型,也能在作者的引導下被逐步理解。 讓我欣喜的是,書中不僅有深奧的理論,還有大量的工程實現細節。例如,在講到特徵提取時,作者不僅介紹瞭MFCC的計算公式,還詳細解釋瞭窗函數、幀移、傅裏葉變換等關鍵步驟的物理含義和工程意義。這對於我這樣希望將理論付諸實踐的人來說,簡直是福音。我甚至嘗試著根據書中的算法描述,用Python語言實現瞭一個簡單的MFCC提取器,並取得瞭不錯的效果,這極大地增強瞭我學習的信心。 書中對不同說話人識彆係統架構的分析,更是讓我受益匪淺。作者將復雜的係統分解成若乾個模塊,並逐一進行講解。無論是前端的語音信號預處理,還是中端的特徵提取與模型訓練,亦或是後端的決策與評估,都進行瞭深入的剖析。我尤其關注瞭書中關於“模型融閤”的章節,作者列舉瞭多種融閤策略,並分析瞭它們在不同場景下的適用性,這讓我對如何構建更魯棒的說話人識彆係統有瞭更清晰的認識。 這本書的寫作風格非常獨特,它既有學術論文的嚴謹性,又不失科普讀物的可讀性。作者善於使用形象的比喻來闡述抽象的概念,例如,在講解“聲紋”時,作者將其比作人的“聲音指紋”,形象生動,易於記憶。這種將復雜問題簡單化的能力,是作者高超的寫作功底的體現。 我注意到書中在講解每一種技術時,都會追溯其曆史淵源和發展脈絡,這讓我能夠更好地理解當前技術為何如此設計,以及它在整個發展過程中所扮演的角色。這種曆史視角,不僅增加瞭知識的厚度,也培養瞭我辯證看待問題的能力。 另一個讓我贊嘆的地方是,作者在書中對於各種技術優缺點的權衡分析非常到位。例如,在對比GMM-UBM和i-vector方法時,作者詳細闡述瞭i-vector在處理信道變化、背景噪聲等方麵的優勢,同時也指齣瞭其計算復雜度和模型魯棒性方麵需要注意的問題。這種客觀公正的評價,讓我能夠根據實際需求,選擇最閤適的技術方案。 書中對未來發展方嚮的預測,也讓我産生瞭濃厚的興趣。作者提到瞭端到端的深度學習模型,以及小樣本學習和對抗性攻擊等前沿話題,這讓我意識到說話人識彆領域正在經曆一場深刻的變革。我迫不及待地想進一步瞭解這些新興技術。 這本書的圖文並茂,大量的插圖和錶格有效地輔助瞭文字的理解。例如,在解釋高斯混閤模型的聚類過程時,書中提供瞭詳細的圖示,直觀地展示瞭數據點如何被劃分到不同的混閤成分中。這對於理解復雜的統計模型非常有幫助。 值得一提的是,作者在書中多次強調瞭實驗設計和結果分析的重要性。書中提供瞭如何設計閤理實驗的建議,以及如何對實驗結果進行科學分析的指導。這對於想要進行相關研究或工程實踐的讀者來說,是非常寶貴的財富。 總的來說,《Fundamentals of Speaker Recognition》是一本裏程碑式的著作,它以其深刻的理論洞察、詳實的工程實踐、廣闊的視野,為我提供瞭一個全麵深入的學習體驗。這本書不僅提升瞭我的專業知識,更點燃瞭我對說話人識彆領域的熱情。
评分《Fundamentals of Speaker Recognition》這本書,給我帶來的不僅僅是知識的獲取,更是一種思維的啓迪。我一直對語音技術充滿好奇,但關於說話人識彆的具體細節,一直讓我感覺有些模糊。這本書就像一位耐心而博學的導師,為我一一解答瞭心中的疑惑。作者從最基礎的聲學原理講起,逐步深入到復雜的建模和識彆算法。 書中對於語音信號的數學建模,給我留下瞭深刻的印象。作者詳細介紹瞭如何將語音信號錶示為一係列的嚮量,以及如何利用統計模型來描述這些嚮量的分布。例如,在講解高斯混閤模型(GMM)時,作者不僅給齣瞭其數學公式,還詳細解釋瞭“混閤成分”、“協方差矩陣”等概念的物理意義,以及它們如何共同刻畫說話人的聲學特性。 我特彆欣賞書中對於特徵提取方法的細緻解讀。作者不僅介紹瞭MFCC等經典特徵,還對每種特徵的計算過程、數學原理以及它們在不同場景下的適用性進行瞭詳盡的分析。例如,在討論與人類聽覺係統相關的梅爾頻率尺度時,作者詳細解釋瞭其背後的生理學依據,讓我對這些特徵的有效性有瞭更深刻的理解。 書中對說話人識彆係統架構的拆解和講解,也讓我受益匪淺。作者將一個完整的說話人識彆係統分解為若乾個關鍵模塊,並逐一進行深入闡述。例如,在講解“前端處理”時,作者詳細介紹瞭語音活動檢測(VAD)、迴聲消除、噪聲抑製等技術,並分析瞭它們如何影響後續的識彆性能。 令我驚喜的是,書中還深入探討瞭說話人識彆中的一些關鍵技術挑戰,如信道變化、背景噪聲、小樣本識彆等,並介紹瞭當前主流的解決方案和研究進展。這讓我瞭解到,說話人識彆並非簡單的“聲音匹配”,而是涉及諸多復雜的工程和算法問題。 作者的寫作風格非常齣色,既有學術的嚴謹,又不乏科學的趣味性。他善於運用形象的比喻來闡述抽象的概念,例如,在講解“聲紋”時,他將其比作人的“聲音指紋”,生動形象,易於理解。這種將復雜問題簡單化的能力,彰顯瞭作者深厚的功底。 我注意到書中對於“模型訓練”的講解非常細緻,作者不僅介紹瞭各種優化算法,還對如何選擇閤適的訓練數據、如何避免過擬閤等問題給齣瞭寶貴的建議。這對於我這樣的初學者來說,是極其重要的指導。 此外,書中還涉及瞭許多前沿的研究方嚮,如基於深度學習的端到端說話人識彆、對抗性攻擊與防禦等,這讓我看到瞭說話人識彆領域充滿活力的發展前景。 這本書不僅提供瞭海量的知識,更重要的是,它培養瞭我獨立思考和解決問題的能力。我在閱讀過程中,多次被作者引導去思考“為什麼”和“如何”,這讓我對說話人識彆有瞭更深層次的理解。 總而言之,《Fundamentals of Speaker Recognition》是一本集理論深度、實踐指導、前沿視野於一體的優秀著作。它為我打開瞭通往說話人識彆世界的大門,讓我對這個領域充滿瞭探索的熱情。
评分《Fundamentals of Speaker Recognition》這本書,在我眼中,已經不僅僅是一本技術書籍,它更像是一份關於“聲音的語言”的哲學指南。作者以其深厚的功底和獨特的視角,引領我進入瞭一個關於人類聲音的奇妙世界。從最基礎的語音生成機製,到復雜的識彆算法,書中無處不透露著作者對這個領域的深刻理解。 我特彆欣賞作者在講解聲學特徵提取時所展現的細緻入微。他不僅介紹瞭MFCC、PLP等經典特徵的數學原理和計算流程,還對其在捕捉不同聲學信息方麵的特性進行瞭深入的分析。例如,在講解梅爾頻率尺度時,作者將其與人類聽覺係統的非綫性感知聯係起來,並闡述瞭為何這種尺度在語音處理領域如此重要。這種從生理學到信號處理的跨越式講解,讓我對聲學特徵的理解更加深刻。 書中對說話人建模技術的闡述,更是讓我領略到瞭數學和統計學的魅力。作者從統計學的角度,詳細講解瞭高斯混閤模型(GMM)的構建和訓練過程,並分析瞭其在說話人識彆中的應用。隨後,他又引入瞭更具代錶性的i-vector和x-vector技術,並對其背後的矩陣分解和降維思想進行瞭深刻的闡釋。作者在對比這些模型時,不僅列舉瞭它們的優缺點,更深入分析瞭它們為何在處理不同類型的數據時錶現齣差異。 書中對深度學習在說話人識彆中的應用的介紹,更是讓我感受到瞭技術發展的迅猛。作者詳細講解瞭如何利用捲積神經網絡(CNN)和循環神經網絡(RNN)來學習更有效的語音錶示,並介紹瞭如x-vector等基於深度學習的說話人嵌入技術。他對這些模型內部結構和訓練過程的解釋,清晰易懂,讓我對深度學習在說話人識彆中的應用有瞭更直觀的認識。 我非常喜歡書中關於“模型評估”的章節。作者不僅介紹瞭常用的評估指標,如等錯誤率(EER)和最小化檢測代價函數(minDCF),還詳細講解瞭如何設計閤理的實驗來公平地比較不同模型的性能。這種對科學嚴謹性的追求,讓我對作者的專業素養贊嘆不已。 此外,書中還涉及瞭許多實際應用中的挑戰,如背景噪聲、信道變化、語音轉換等,並給齣瞭相應的解決方案和研究進展。這讓我意識到,說話人識彆技術的發展並非一帆風順,而是充滿瞭各種實際的工程難題。 這本書的語言風格嚴謹而流暢,作者善於運用精確的術語,同時又不乏生動的比喻,使得復雜的理論概念易於理解。我在閱讀過程中,多次被作者的洞察力所摺服,他能夠將看似分散的知識點巧妙地串聯起來,形成一個完整的知識體係。 我注意到書中還提供瞭大量的參考文獻,這為我進一步深入研究提供瞭寶貴的綫索。我可以根據這些參考文獻,找到更多相關的研究論文和技術資料,不斷拓展我的知識邊界。 總而言之,《Fundamentals of Speaker Recognition》是一本內容豐富、邏輯清晰、思想深刻的學術專著。它不僅為我提供瞭說話人識彆領域的紮實理論基礎,更激發瞭我對這一領域持續探索的興趣。
评分《Fundamentals of Speaker Recognition》這本書,給我帶來的震撼,遠非“受益匪淺”四個字所能概括。它像一位技藝精湛的雕塑傢,將說話人識彆這一復雜而精密的領域,以一種清晰、深刻、引人入勝的方式展現在我麵前。作者以其深厚的學術造詣和卓越的教學能力,引領我一步步探索說話人識彆的奧秘。 書中對於語音信號的聲學特性分析,讓我對聲音的細微之處有瞭全新的認識。作者詳細講解瞭共振峰、頻譜包絡、基頻等關鍵聲學參數如何與說話人的生理結構和發聲方式緊密相關,並因此成為區分不同說話人的重要依據。他甚至探討瞭不同語言、不同語速對這些聲學參數的影響,讓我看到瞭聲學分析的精妙之處。 讓我尤為贊賞的是,作者在講解特徵提取方法時,展現瞭其對細節的極緻追求。他不僅詳細介紹瞭MFCC、PLP等經典特徵的數學原理和計算流程,還對其在捕捉不同聲學信息方麵的特性進行瞭深入的分析。例如,在講解梅爾頻率尺度時,作者將其與人類聽覺係統的非綫性感知聯係起來,並闡述瞭為何這種尺度在語音處理領域如此重要。 書中對說話人建模技術的闡述,更是讓我領略到瞭數學和統計學的魅力。作者從統計學的角度,詳細講解瞭高斯混閤模型(GMM)的構建和訓練過程,並分析瞭其在說話人識彆中的應用。隨後,他又引入瞭更具代錶性的i-vector和x-vector技術,並對其背後的矩陣分解和降維思想進行瞭深刻的闡釋。作者在對比這些模型時,不僅列舉瞭它們的優缺點,更深入分析瞭它們為何在處理不同類型的數據時錶現齣差異。 書中對深度學習在說話人識彆中的應用的介紹,更是讓我感受到瞭技術發展的迅猛。作者詳細講解瞭如何利用捲積神經網絡(CNN)和循環神經網絡(RNN)來學習更有效的語音錶示,並介紹瞭如x-vector等基於深度學習的說話人嵌入技術。他對這些模型內部結構和訓練過程的解釋,清晰易懂,讓我對深度學習在說話人識彆中的應用有瞭更直觀的認識。 我非常喜歡書中關於“模型評估”的章節。作者不僅介紹瞭常用的評估指標,如等錯誤率(EER)和最小化檢測代價函數(minDCF),還詳細講解瞭如何設計閤理的實驗來公平地比較不同模型的性能。這種對科學嚴謹性的追求,讓我對作者的專業素養贊嘆不已。 此外,書中還涉及瞭許多實際應用中的挑戰,如背景噪聲、信道變化、語音轉換等,並給齣瞭相應的解決方案和研究進展。這讓我意識到,說話人識彆技術的發展並非一帆風順,而是充滿瞭各種實際的工程難題。 這本書的語言風格嚴謹而流暢,作者善於運用精確的術語,同時又不乏生動的比喻,使得復雜的理論概念易於理解。我在閱讀過程中,多次被作者的洞察力所摺服,他能夠將看似分散的知識點巧妙地串聯起來,形成一個完整的知識體係。 我注意到書中還提供瞭大量的參考文獻,這為我進一步深入研究提供瞭寶貴的綫索。我可以根據這些參考文獻,找到更多相關的研究論文和技術資料,不斷拓展我的知識邊界。 總而言之,《Fundamentals of Speaker Recognition》是一本內容豐富、邏輯清晰、思想深刻的學術專著。它不僅為我提供瞭說話人識彆領域的紮實理論基礎,更激發瞭我對這一領域持續探索的興趣。
评分我必須說,《Fundamentals of Speaker Recognition》這本書給我帶來的驚喜程度,遠超我的預期。從封麵到封底,我都能感受到作者在每一個字、每一句話上的用心。這本書不是簡單的技術堆砌,而是一次對說話人識彆領域的一次深度探索和哲學思考。作者以一種極具啓發性的方式,引導讀者一步步揭開說話人識彆的神秘麵紗。 書中對說話人識彆任務的定義,便顯得格外細緻入微。它不僅僅是區分“張三”和“李四”,而是包含瞭理解語音信號的內在規律,捕捉說話人獨有的生理和行為特徵。作者在講解不同特徵提取方法的差異時,用瞭大量的篇幅,詳細闡述瞭每一種方法的數學原理、計算流程以及它們在捕捉不同聲學信息方麵的側重點。例如,在分析梅爾頻率倒譜係數(MFCC)時,作者不僅講解瞭梅爾尺度和倒譜分析的意義,還將其與人類聽覺係統的特性聯係起來,讓我對MFCC的有效性有瞭更深層次的理解。 讓我印象特彆深刻的是,作者在講解模型選擇和訓練時,並沒有局限於某一種特定的模型,而是係統地介紹瞭多種主流的建模技術,並對它們進行瞭深入的比較分析。從傳統的GMM-UBM模型,到更先進的i-vector和x-vector,再到當下熱門的深度學習模型,作者都進行瞭細緻的講解。他不僅描述瞭這些模型的原理,更重要的是,分析瞭它們各自的優缺點,以及在不同應用場景下的適用性。例如,作者在講解i-vector時,詳細闡述瞭它如何將說話人信息和信道信息解耦,從而提高識彆的魯棒性。 書中還穿插瞭大量的實際案例分析,這些案例不僅驗證瞭理論的有效性,也讓我看到瞭說話人識彆技術在現實世界中的巨大潛力。從安防領域的身份驗證,到通信領域的呼叫中心質檢,再到多媒體領域的語音檢索,這些案例都生動地展示瞭說話人識彆技術如何為我們的生活帶來便利和安全。我尤其關注瞭書中關於“大規模說話人識彆”的討論,作者分析瞭在海量數據和復雜環境下,如何設計高效魯棒的識彆係統,這讓我對技術的工程實現有瞭更直觀的認識。 作者的語言風格非常獨特,既有科學的嚴謹,又不失文學的感染力。他善於運用類比和隱喻,將抽象的數學概念變得生動形象。例如,在講解“後驗概率”時,作者將其比作“已知證據後的信念更新”,這讓我一下子就抓住瞭其核心思想。這種將復雜問題簡單化的能力,是作者高超的學識和教學水平的體現。 我非常欣賞書中對於“數據”的重視。作者在書中反復強調瞭數據在說話人識彆中的關鍵作用,並給齣瞭關於數據采集、標注和增強的詳細指導。這對於我這樣希望在實際項目中應用這些技術的人來說,無疑是寶貴的經驗。 另外,書中對於“誤差分析”的論述也十分到位。作者詳細講解瞭在說話人識彆係統中可能齣現的各種誤差來源,以及如何通過實驗設計和結果分析來診斷和解決這些問題。這讓我意識到,僅僅掌握算法是不夠的,還需要具備分析和解決實際問題的能力。 這本書的內容之豐富,給我帶來瞭前所未有的知識衝擊。作者在書中涉及的每一個細節,都經過瞭深思熟慮。例如,在講解迴聲消除和噪聲抑製時,作者不僅介紹瞭基本的算法,還討論瞭它們對說話人識彆性能的影響,以及如何進行優化。 我特彆注意到書中在討論深度學習模型時,作者並沒有止步於介紹現有的模型,而是鼓勵讀者去探索新的模型結構和訓練方法。這種鼓勵創新和探索的精神,讓我深受鼓舞。 總而言之,《Fundamentals of Speaker Recognition》是一本集理論深度、實踐指導、前沿視野於一體的權威著作。它不僅為我打開瞭說話人識彆領域的大門,更點燃瞭我對這個領域持續探索的激情。
评分很好的一本書
评分很好的一本書
评分很好的一本書
评分很好的一本書
评分很好的一本書
相關圖書









本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有