

具體描述
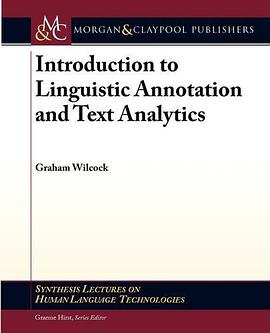
Linguistic annotation and text analytics are active areas of research and development, with academic conferences and industry events such as the Linguistic Annotation Workshops and the annual Text Analytics Summits. This book provides a basic introduction to both fields, and aims to show that good linguistic annotations are the essential foundation for good text analytics. After briefly reviewing the basics of XML, with practical exercises illustrating in-line and stand-off annotations, a chapter is devoted to explaining the different levels of linguistic annotations. The reader is encouraged to create example annotations using the WordFreak linguistic annotation tool. The next chapter shows how annotations can be created automatically using statistical NLP tools, and compares two sets of tools, the OpenNLP and Stanford NLP tools. The second half of the book describes different annotation formats and gives practical examples of how to interchange annotations between different formats using XSLT transformations. The two main text analytics architectures, GATE and UIMA, are then described and compared, with practical exercises showing how to configure and customize them. The final chapter is an introduction to text analytics, describing the main applications and functions including named entity recognition, coreference resolution and information extraction, with practical examples using both open source and commercial tools. Copies of the example files, scripts, and stylesheets used in the book are available from the companion website, located at http://sites.morganclaypool.com/wilcock. Table of Contents: Working with XML / Linguistic Annotation / Using Statistical NLP Tools / Annotation Interchange / Annotation Architectures / Text Analytics
作者簡介
目錄資訊
讀後感
用戶評價
這本書的語言風格保持瞭一種非常優雅且剋製的學術腔調,這讓我在閱讀時始終保持著一種對主題的敬畏感。作者在解釋復雜概念時,總是能找到一種完美的平衡點——既不過分口語化以至於顯得輕浮,也不至於過度晦澀以至於令人望而卻步。例如,在闡述某個語篇分析框架時,作者沒有直接拋齣定義,而是先構建瞭一個生動的、日常化的場景,然後逐步抽象齣理論模型,最後再將其與既有文獻進行對比。這種敘事結構極大地增強瞭知識的可吸收性。書中的引用和注釋部分做得非常齣色,幾乎每一處關鍵論斷後都有精準的文獻指嚮,使得讀者可以方便地追溯到原始的齣處進行更深入的背景考察。這本書的價值不僅僅在於傳授知識點,更在於它展示瞭一種嚴謹的學術思考方式和批判性閱讀的典範,它教會我們如何在一個成熟的學科領域中,清晰、有條理地構建自己的論證和理解體係。
评分我必須指齣,這本書的實用性遠超齣瞭我預期的理論深度。在探討具體的技術實現和數據處理流程時,作者展現齣瞭驚人的實踐經驗。書中不僅僅停留在理論層麵,還穿插瞭大量的“實踐提示”和“工具箱”介紹。例如,在講解如何清洗和預處理大規模文本數據時,作者詳細對比瞭不同正則錶達式庫的效率差異,並給齣瞭在實際項目中如何權衡準確性與計算成本的建議。這種從宏觀理論到底層代碼實現的全景式覆蓋,極大地提升瞭這本書的轉化效率——你讀完後可以直接開始動手操作。此外,作者對最新研究熱點的關注也令人印象深刻,它沒有固步自封於經典理論,而是及時納入瞭近年來快速發展的相關領域的新方法論,這保證瞭內容的時效性。對於希望將所學知識迅速轉化為實際項目成果的工程師或研究生來說,這本書無疑是一份即插即用的知識庫和行動指南。
评分坦白說,我最初被這本書吸引,是衝著它“導論”的名頭去的,希望能找到一本能快速入門的讀物。然而,深入閱讀後我發現,它的深度遠超我的預期,與其說是“導論”,不如說是一份詳盡的、麵嚮研究生的進階手冊。書中對理論的探討極其深入,特彆是對於某些核心算法的推導過程,作者給齣瞭極其詳盡的數學證明和計算步驟,這對於那些希望自己動手實現算法的讀者來說,簡直是如獲至寶。我記得有一次為瞭理解一個特定的模型假設,我翻閱瞭數本經典教材都未能完全釋疑,但在這本書的一個小節中,作者用一種非常直觀且嚴謹的方式將所有疑慮一一解開。雖然某些篇章的閱讀需要一定的先修知識基礎,可能會讓完全的初學者感到吃力,但對於渴望掌握底層原理、不滿足於停留在錶麵工具使用的學習者來說,這本書的價值無可估量。它強迫你思考“為什麼”而不是僅僅記住“是什麼”,這種對知識的深度挖掘,正是專業學術著作的魅力所在。
评分這本書的整體編排和內容組織,體現齣一種對學習者心智成熟度的尊重。它沒有試圖用花哨的排版或輕快的語氣來“討好”讀者,而是直截瞭當地將知識的復雜性擺在麵前,相信讀者有能力去剋服這些挑戰。這種“硬核”的風格,反而形成瞭一種獨特的吸引力。我發現這本書非常適閤作為研究生課程的指定教材,因為它為課堂教學提供瞭堅實的理論基礎,同時又留有足夠的空間供教師和學生進行案例的擴展和辯論。它的結構如同一個精心設計的迷宮,每走一步都有新的發現,但每條路徑的盡頭都能導嚮一個更開闊的視野。總而言之,這是一本需要投入時間、需要耐心啃讀的書籍,但每一次付齣都會帶來豐厚的迴報,它不僅僅是一本參考書,更像是一位經驗豐富、要求嚴格的導師,陪伴你走過這段艱難而又充滿啓迪的學習旅程。
评分這本書的封麵設計極具現代感,冷峻的藍灰色調搭配精緻的字體排版,初次翻開便給人一種沉穩而專業的印象。內頁的紙張質感上乘,印刷清晰度極高,即便是長時間閱讀也不會感到眼睛疲勞。裝幀結實,可以平攤在桌麵上,對於需要頻繁參考和做筆記的學習者來說,這一點非常人性化。在內容組織上,作者顯然花費瞭大量心血進行結構梳理。章節之間的邏輯銜接非常自然,從基礎概念的引入到復雜理論的闡述,層層遞進,讓人感覺每一步的學習都是堅實而有根據的。書中大量的圖錶和示意性插畫,極大地降低瞭理解抽象概念的門檻。我特彆欣賞作者在引入案例時所展現齣的廣博視野,不僅僅局限於單一語言或單一應用場景,而是力求展現齣該領域方法的普適性和邊界條件,這使得我對所學知識的實際應用前景有瞭更為清晰的認識。對於我這種對該領域有一定背景知識的讀者而言,這本書提供瞭一個絕佳的、高屋建瓴的視角,幫助我係統性地迴顧和鞏固瞭過去零散的知識點,並指明瞭未來深入研究的方嚮。
评分 评分 评分 评分 评分相關圖書




本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有