
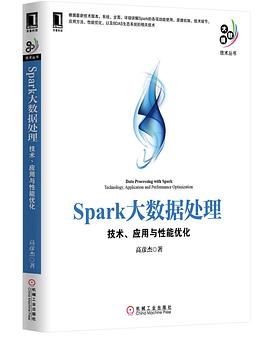

具体描述
《Spark大数据处理:技术、应用与性能优化》根据最新技术版本,系统、全面、详细讲解Spark的各项功能使用、原理机制、技术细节、应用方法、性能优化,以及BDAS生态系统的相关技术。
作为一个基于内存计算的大数据并行计算框架,Spark不仅很好地解决了数据的实时处理问题,而且保证了高容错性和高可伸缩性。具体来讲,它有如下优势:
打造全栈多计算范式的高效数据流水线
轻量级快速处理
易于使用,支持多语言
与HDFS等存储层兼容
社区活跃度高
……
Spark已经在全球范围内广泛使用,无论是Intel、Yahoo!、Twitter、阿里巴巴、百度、腾讯等国际互联网巨头,还是一些尚处于成长期的小公司,都在使用Spark。本书作者结合自己在微软和IBM实践Spark的经历和经验,编写了这本书。站着初学者的角度,不仅系统、全面地讲解了Spark的各项功能及其使用方法,而且较深入地探讨了Spark的工作机制、运行原理以及BDAS生态系统中的其他技术,同时还有一些可供操作的案例,能让没有经验的读者迅速掌握Spark。更为重要的是,本书还对Spark的性能优化进行了探讨。
作者简介
高彦杰 毕业于中国人民大学,就职于IBM,精通Hadoop相关技术,较早接触并使用Spark,对Spark应用开发、Spark系统的运维和测试比较熟悉,深度阅读了Spark的源代码,了解Spark的运行机制,擅长Spark的查询优化。
目录信息
第1章 Spark简介 1
1.1 Spark是什么 1
1.2 Spark生态系统BDAS 4
1.3 Spark架构 6
1.4 Spark分布式架构与单机多核
架构的异同 9
1.5 Spark的企业级应用 10
1.5.1 Spark在Amazon中的应用 11
1.5.2 Spark在Yahoo!的应用 15
1.5.3 Spark在西班牙电信的应用 17
1.5.4 Spark在淘宝的应用 18
1.6 本章小结 20
第2章 Spark集群的安装与部署 21
2.1 Spark的安装与部署 21
2.1.1 在Linux集群上安装与配置Spark 21
2.1.2 在Windows上安装与配置Spark 30
2.2 Spark集群初试 33
2.3 本章小结 35
第3章 Spark计算模型 36
3.1 Spark程序模型 36
3.2 弹性分布式数据集 37
3.2.1 RDD简介 38
3.2.2 RDD与分布式共享内存的异同 38
3.2.3 Spark的数据存储 39
3.3 Spark算子分类及功能 41
3.3.1 Value型Transformation算子 42
3.3.2 Key-Value型Transformation算子 49
3.3.3 Actions算子 53
3.4 本章小结 59
第4章 Spark工作机制详解 60
4.1 Spark应用执行机制 60
4.1.1 Spark执行机制总览 60
4.1.2 Spark应用的概念 62
4.1.3 应用提交与执行方式 63
4.2 Spark调度与任务分配模块 65
4.2.1 Spark应用程序之间的调度 66
4.2.2 Spark应用程序内Job的调度 67
4.2.3 Stage和TaskSetManager调度方式 72
4.2.4 Task调度 74
4.3 Spark I/O机制 77
4.3.1 序列化 77
4.3.2 压缩 78
4.3.3 Spark块管理 80
4.4 Spark通信模块 93
4.4.1 通信框架AKKA 94
4.4.2 Client、Master和Worker间的通信 95
4.5 容错机制 104
4.5.1 Lineage机制 104
4.5.2 Checkpoint机制 108
4.6 Shuffle机制 110
4.7 本章小结 119
第5章 Spark开发环境配置及流程 120
5.1 Spark应用开发环境配置 120
5.1.1 使用Intellij开发Spark程序 120
5.1.2 使用Eclipse开发Spark程序 125
5.1.3 使用SBT构建Spark程序 129
5.1.4 使用Spark Shell开发运行Spark程序 130
5.2 远程调试Spark程序 130
5.3 Spark编译 132
5.4 配置Spark源码阅读环境 135
5.5 本章小结 135
第6章 Spark编程实战 136
6.1 WordCount 136
6.2 Top K 138
6.3 中位数 140
6.4 倒排索引 141
6.5 CountOnce 143
6.6 倾斜连接 144
6.7 股票趋势预测 146
6.8 本章小结 153
第7章 Benchmark使用详解 154
7.1 Benchmark简介 154
7.1.1 Intel Hibench与Berkeley BigDataBench 155
7.1.2 Hadoop GridMix 157
7.1.3 Bigbench、BigDataBenchmark与TPC-DS 158
7.1.4 其他Benchmark 161
7.2 Benchmark的组成 162
7.2.1 数据集 162
7.2.2 工作负载 163
7.2.3 度量指标 167
7.3 Benchmark的使用 168
7.3.1 使用Hibench 168
7.3.2 使用TPC-DS 170
7.3.3 使用BigDataBench 172
7.4 本章小结 176
第8章 BDAS简介 177
8.1 SQL on Spark 177
8.1.1 使用Spark SQL的原因 178
8.1.2 Spark SQL架构分析 179
8.1.3 Shark简介 182
8.1.4 Hive on Spark 184
8.1.5 未来展望 185
8.2 Spark Streaming 185
8.2.1 Spark Streaming简介 186
8.2.2 Spark Streaming架构 188
8.2.3 Spark Streaming原理剖析 189
8.2.4 Spark Streaming调优 198
8.2.5 Spark Streaming 实例 198
8.3 GraphX 205
8.3.1 GraphX简介 205
8.3.2 GraphX的使用 206
8.3.3 GraphX架构 209
8.3.4 运行实例 211
8.4 MLlib 215
8.4.1 MLlib简介 217
8.4.2 MLlib的数据存储 219
8.4.3 数据转换为向量(向量空间模型VSM) 222
8.4.4 MLlib中的聚类和分类 223
8.4.5 算法应用实例 228
8.4.6 利用MLlib进行电影推荐 230
8.5 本章小结 237
第9章 Spark性能调优 238
9.1 配置参数 238
9.2 调优技巧 239
9.2.1 调度与分区优化 240
9.2.2 内存存储优化 243
9.2.3 网络传输优化 249
9.2.4 序列化与压缩 251
9.2.5 其他优化方法 253
9.3 本章小结 255
· · · · · · (收起)
读后感
有误,比如join,spark中的join是inner join,书中对着源码讲成了outer join.. 跑题,花了大量篇幅在FIFO,HASHMap的原理上... 以上 不过很多地方还是很详细的,而且通俗易懂
评分有误,比如join,spark中的join是inner join,书中对着源码讲成了outer join.. 跑题,花了大量篇幅在FIFO,HASHMap的原理上... 以上 不过很多地方还是很详细的,而且通俗易懂
评分有误,比如join,spark中的join是inner join,书中对着源码讲成了outer join.. 跑题,花了大量篇幅在FIFO,HASHMap的原理上... 以上 不过很多地方还是很详细的,而且通俗易懂
评分有误,比如join,spark中的join是inner join,书中对着源码讲成了outer join.. 跑题,花了大量篇幅在FIFO,HASHMap的原理上... 以上 不过很多地方还是很详细的,而且通俗易懂
评分有误,比如join,spark中的join是inner join,书中对着源码讲成了outer join.. 跑题,花了大量篇幅在FIFO,HASHMap的原理上... 以上 不过很多地方还是很详细的,而且通俗易懂
用户评价
这本书简直是大数据领域的“武林秘籍”!我拿到手翻了几页,就被那种深入骨髓的实在感震撼到了。作者显然不是那种只会堆砌理论的学院派,而是实实在在经历了无数次线上故障和性能瓶颈后,才将这些血泪经验凝练成文字。特别是关于数据倾斜的处理,市面上很多资料都泛泛而谈,但这书里却详细剖析了好几种极端场景下的解决方案,连代码实现的关键点都掰扯得清清楚楚。读起来就像是跟着一位经验丰富的大师在身边手把手指导,每解决一个技术难点,都能感觉到自己的内力又精进了一层。那种从容驾驭海量数据的信心,不是看几篇博客能建立起来的,而是需要这种系统化、实战化的知识体系支撑。如果你的工作日常就是和TB、PB级别的数据打交道,这本书绝对能帮你把效率提升到一个新的层次,让你在面对突发状况时,能够泰山崩于前而色不变。它不仅仅是技术手册,更像是一份实战生存指南。
评分对于初学者来说,这本书可能需要一点点耐心来啃,因为它确实包含了很多深度细节,但对于有一定基础,希望从“会用”迈向“精通”的工程师来说,这简直是一份里程碑式的参考资料。它最大的优点在于逻辑的连贯性和知识体系的完整性。作者构建了一个从数据接入、存储、计算到最终分析的完整闭环,每一步的优化策略都前后呼应,形成了一个统一的性能优化框架。我尤其喜欢书中对“坏习惯”的纠正环节,它没有直接批评,而是通过展示“坏习惯”带来的具体性能衰退曲线,让你自己得出结论——这比单纯的规定有效得多。总而言之,这本书的价值在于它提供了一种思考问题的方式,一种面对复杂系统时的系统工程思维,而不是简单地教你几个命令或API调用。它培养的是对性能的敏感度。
评分我一直认为,技术书籍的生命力在于它对前沿趋势的把握和对工程实践的忠实记录。这本书在这两方面都做得相当出色。它不仅覆盖了核心组件的经典用法,更将目光投向了最新的内存计算框架和增量处理模型。在讲述这些新技术的集成和应用时,作者并没有采用那种“空中楼阁”式的描绘,而是紧密结合了实际生产环境中的数据治理和实时性要求。其中关于如何构建一个低延迟的数据管道的部分,简直是为我们这样需要快速响应业务变化的团队量身定做的。书中对故障恢复机制的探讨也非常到位,很多关键的配置项和恢复策略,都是只有在经历过灾难性宕机后才能总结出来的宝贵经验。读起来酣畅淋漓,感觉自己仿佛参与了一场场高风险的线上攻坚战,只不过这次,我站在了胜利者的角度回顾整个过程。
评分说实话,刚开始看这本书的时候,我还有点担心内容会过于晦涩难懂,毕竟涉及到底层计算模型和复杂的并行机制。但出乎意料的是,作者在阐述复杂概念时,总能找到非常形象的比喻和恰到好处的图示来辅助理解。比如,他对DAG(有向无环图)执行引擎的讲解,简直是教科书级别的清晰。他没有止步于描述“是什么”,而是深入挖掘了“为什么这么设计”以及“如果这样设计会带来什么后果”。这种对底层逻辑的刨根问底,极大地满足了我作为一个工程师的好奇心。更让我惊喜的是,书中穿插了大量关于资源隔离和多租户架构的实践案例。在如今云原生和资源紧张的环境下,如何用好有限的集群资源,实现高性能和高稳定性,是所有架构师绕不开的坎。这本书提供的优化思路,直接解决了我们在资源调度上面临的很多痛点。感觉读完后,看集群监控的眼神都不一样了,多了一份洞察力。
评分这本书的价值远超出了我们团队内部培训的要求。我们过去主要聚焦在应用层的开发和SQL优化上,但随着数据量的激增,瓶颈开始暴露在集群的稳定性和资源利用率上。这本书的后半部分,专门针对I/O密集型和计算密集型任务的性能调优给出了非常详尽的检查清单和调整参数的依据。我特别欣赏作者没有盲目推崇最新的特性,而是强调根据现有硬件条件和数据分布特点来做权衡。例如,它对比了不同Shuffle策略在固态硬盘和机械硬盘上的实际性能差异,这种基于硬件层面的考量,才是真正意义上的“性能优化”。这种务实的态度,让我们避免了许多“为优化而优化”的弯路。它让我们明白,最好的优化,往往是那些能让机器以最自然、最高效的方式运行的“不打扰”的优化。对于追求极致效率的团队来说,这是一份极具参考价值的实战手册。
评分浅入浅出……
评分内容还不错,整体上把Spark的运行逻辑和注意点都理清了,但不少地方有些粗糙。
评分很全面,也很技术。
评分很全面,也很技术。
评分理论还要联系实践呀
相关图书



本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有