
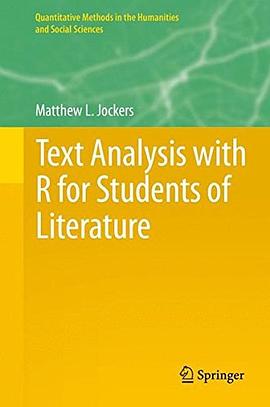
Text Analysis with R for Students of Literature pdf epub mobi txt 电子书 下载 2026
- R
- 语言学
- 统计学
- 社会学/人类学
- 方法论
- 文本
- 文学批评
- 文化
- R语言
- 文本分析
- 文学研究
- 计算文学
- 文本挖掘
- 数据分析
- 自然语言处理
- 人文计算
- 文本数据
- 文学文本

具体描述
Text Analysis with R for Students of Literature is written with students and scholars of literature in mind but will be applicable to other humanists and social scientists wishing to extend their methodological tool kit to include quantitative and computational approaches to the study of text. Computation provides access to information in text that we simply cannot gather using traditional qualitative methods of close reading and human synthesis. Text Analysis with R for Students of Literature provides a practical introduction to computational text analysis using the open source programming language R. R is extremely popular throughout the sciences and because of its accessibility, R is now used increasingly in other research areas. Readers begin working with text right away and each chapter works through a new technique or process such that readers gain a broad exposure to core R procedures and a basic understanding of the possibilities of computational text analysis at both the micro and macro scale. Each chapter builds on the previous as readers move from small scale “microanalysis” of single texts to large scale “macroanalysis” of text corpora, and each chapter concludes with a set of practice exercises that reinforce and expand upon the chapter lessons. The book’s focus is on making the technical palatable and making the technical useful and immediately gratifying.
作者简介
目录信息
读后感
用户评价
作为一名偏爱古典文学的学者,我对新工具的接受度一直比较谨慎,担心现代计算方法会显得过于“降维打击”。这本书巧妙地平衡了这种矛盾。它没有强迫我们用数据去解释一切,而是将R语言定位为一种“放大镜”和“显微镜”。在探讨文本相似性(Text Similarity)的部分,我找到了一个非常有趣的切入点。通过计算不同版本文本间的距离度量,我可以更客观地评估文本在流传过程中,哪些核心信息被保留得最为完好,哪些部分发生了显著的变异。这对于研究版本学或译本比较时,提供了强有力的量化支持。书中对缺失值和异常值处理的章节,也体现了作者对人文学科特点的深刻理解——我们的数据很少是完美对齐的,总是有各种历史和语境的噪音。如何优雅地清洗这些噪音,而不是简单地剔除它们,这本书给出了非常成熟的建议。它教会我们在追求精确的同时,保持对文本复杂性的敬畏。
评分我必须承认,在深入阅读这本书之前,我对R语言的印象还停留在“理工科工具”的层面,认为它与我的研究领域格格不入。然而,这本书的结构设计简直是一场针对非技术读者的精心“策反”。它的章节安排逻辑极其清晰,从基础的数据导入、清理,到进阶的可视化和建模,每一步都像是搭建一座坚固的知识高塔。最让我感到惊喜的是,书中对于如何将R的输出结果,用文学的语言进行有效“翻译”和“阐释”的讨论。这才是将技术与人文结合的关键所在——我们不能仅仅停留在输出漂亮的图表,更要能解释这些图表背后的文学意义。作者在每章末尾都设置了“文学应用案例”,这些案例都非常贴合我们实际研究中可能遇到的难题,例如识别套用特定修辞手法的倾向性。这种以应用驱动学习的方式,使得学习过程充满了动力,每一次代码的成功运行,都像是为我们自己的研究增添了一块坚实的砖石,让我真正体会到科技赋能人文的巨大潜力。
评分这本关于R语言文本分析的书籍,对于文学专业的学生来说,无疑打开了一扇全新的大门。我当初抱着试试看的心态购入,没想到里面的内容远超我的预期。书的叙述方式非常贴合初学者的需求,它没有一开始就抛出那些高深的统计学理论,而是循序渐进地从最基础的R环境搭建讲起。对于我们这些习惯了纸质文本、对编程一窍不通的人来说,这种由浅入深的引导至关重要。作者似乎非常理解文学研究者在面对数据和代码时的那种天然的疏离感,所以他总能找到最巧妙的比喻来解释复杂的概念。比如,在讲解词频统计时,他会联系到我们熟悉的“高频词汇分析”,将抽象的算法转化为具体的文本特征。更让我印象深刻的是,书中对于数据可视化的强调。当我们看到自己处理的文本数据经过R语言的渲染,转化成直观的词云或者主题分布图时,那种成就感是无法用言语形容的。它不仅仅是工具书,更像是一位耐心的导师,引导我们用一种全新的、量化的视角去重新审视那些我们自以为已经非常熟悉的文学作品。这种方法论上的转变,对于我们未来撰写研究论文,无疑是提供了强有力的支撑。
评分这本书的价值,我认为很大程度上体现在它对“文本”这一概念的重新定义上。在传统的人文学科训练中,“文本”往往是不可分割的、具有整体美感的艺术品。但这本书教会我们如何将文本“解构”成可操作的数据点,然后通过精密的统计方法重新“构建”出新的洞察。书中对N-gram分析的讲解尤其精彩,它不仅仅停留在计算连续词组的频率,更进一步引导我们思考这种关联性在不同文本风格中的意义。例如,通过对比两个作家的二元组(bigram)频率差异,我能够量化地观察到他们叙事节奏和偏好用词的结构性不同。此外,对于处理大规模语料库的技巧,书中也提供了非常实用的建议。对于文学研究者来说,我们常常需要处理几百部小说的集合,手动分析是天方夜谭。这本书提供的批量处理思路,彻底解决了我们面对“大数据”时的无力感。每一次成功运行一个复杂的脚本,提取出前所未有的数据支撑,都让我对文学研究的未来充满信心——一个更精确、更客观的未来。
评分坦率地说,我最初对使用R进行文学分析持怀疑态度。毕竟,文学研究的核心魅力在于其细微的情感层次和复杂的人文关怀,我担心冰冷的代码会扼杀掉文本的灵魂。然而,这本书在实践操作层面的细致入微,彻底打消了我的顾虑。它不是教我们如何成为数据科学家,而是教我们如何成为一个“携带数据工具箱的文学学者”。书中涵盖了诸如情感分析(Sentiment Analysis)的入门方法,这对于研究特定时期或作家的情感基调变化极为有用。我特别欣赏其中关于“主题建模”(Topic Modeling)的章节,它帮助我从一个宏大的叙事中,抽离出隐藏在字里行间的潜在议题网络。这些议题的权重和关联性,远比我们仅凭阅读感受到的要系统和深刻。编写代码的过程虽然偶尔会因为小小的语法错误而令人抓狂,但书中的示例代码往往是经过精心设计和注释的,它们不仅能运行,还能清晰地展示背后的逻辑。这种“手把手”的教学风格,极大地降低了技术门槛,让我能够专注于文学问题本身,而不是被编程语言的细节所困扰。这是一种赋能,它让我们的定性研究具备了更坚实的量化基础。
评分还挺容易上手的
评分还挺容易上手的
评分非常好的一本书,不像有些书一样在一些无用的基础上长篇大论,废话少直接上手,适合learn by doing的人
评分文科生走向码农系列之书 照着做了 很好玩
评分非常好的一本书,不像有些书一样在一些无用的基础上长篇大论,废话少直接上手,适合learn by doing的人
相关图书





本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有