

具体描述
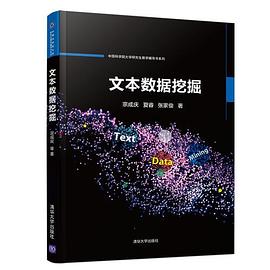
本书阐述文本数据挖掘的理论模型、实现算法和相关应用,主要内容包括:信息抽取和知识库构建、文本聚类、情感文本分析、热点发现、生物医学文本挖掘和多文档自动摘要等。写作风格力求言简意赅,深入浅出,通过实例说明实现相关任务的理论方法和技术思路,而不过多地涉及实现细节。本书可作为大学高年级本科生或研究生从事相关研究的入门文献,也可作为从事相关技术研发的开发人员的参考资料。
作者简介
目录信息
1.1基本概念 1
1.2文本挖掘任务 .2
1.3文本挖掘面临的困难 .5
1.4方法概述与本书的内容组织 .7
1.5进一步阅读 .9
第 2章数据预处理和标注 . 11
2.1数据获取 11
2.2数据预处理 . 15
2.3数据标注 17
2.4基本工具 19
2.4.1汉语自动分词与词性标注 19
2.4.2句法分析 . 20
2.4.3 n元语法模型 . 21
2.5进一步阅读 . 22
第 3章文本表示 . 23
3.1向量空间模型 . 23
3.1.1向量空间模型的基本概念 23
3.1.2特征项的构造与权重 . 24
3.1.3文本长度规范化 . 25
3.1.4特征工程 . 26
3.1.5其他文本表示方法 27
3.2词的分布式表示 29
3.2.1神经网络语言模型 29
3.2.2 C&W模型 . 32
3.2.3 CBOW与 Skip-gram模型 34
3.2.4噪声对比估计与负采样 . 35
3.2.5字词混合的分布式表示方法 . 37
3.3短语的分布式表示 . 38
3.3.1基于词袋的分布式表示 . 39
3.3.2基于自动编码器的分布式表示 . 39
3.4句子的分布式表示 . 42
3.4.1通用的句子表示 . 42
3.4.2任务相关的句子表示 . 45
3.5文档的分布式表示 . 48
3.5.1通用的文档分布式表示 . 48
3.5.2任务相关的文档分布式表示 . 49
3.6进一步阅读 . 52
第 4章文本分类 . 53
4.1概述 . 53
4.2传统文本表示 . 54
4.3特征选择 55
4.3.1互信息法 . 55
4.3.2信息增益法 58
4.3.3卡方统计量法 . 59
4.3.4其他方法 . 60
4.4传统分类算法 . 61
4.4.1朴素贝叶斯模型 . 61
4.4.2 Logistic回归、 Softmax回归与最大熵模型 . 63
4.4.3支持向量机 65
4.4.4集成学习 . 67
4.5深度神经网络方法 . 68
4.5.1多层前馈神经网络 68
4.5.2卷积神经网络 . 69
4.5.3循环神经网络 . 71
4.6文本分类性能评估 . 78
4.7进一步阅读 . 81
第 5章文本聚类 . 83
5.1概述 . 83
5.2文本相似性度量 83
5.2.1样本间的相似性 . 83
5.2.2簇间的相似性 . 86
目录 IX
5.2.3样本与簇之间的相似性 . 87
5.3文本聚类算法 . 87
5.3.1 K-均值聚类 . 87
5.3.2单遍聚类 . 91
5.3.3层次聚类 . 92
5.3.4密度聚类 . 95
5.4性能评估 97
5.4.1外部标准 . 97
5.4.2内部标准 . 99
5.5进一步阅读 . 99
第 6章主题模型 . 101
6.1概述 . 101
6.2潜在语义分析 . 102
6.2.1奇异值分解 102
6.2.2词项 -文档矩阵的奇异值分解 103
6.2.3词项和文档的概念表示及相似度计算 . 104
6.3概率潜在语义分析 . 106
6.3.1模型假设 . 106
6.3.2参数学习 . 107
6.4潜在狄利克雷分布 . 108
6.4.1模型假设 . 108
6.4.2词项和主题序列的联合概率 . 110
6.4.3模型推断 . 112
6.4.4新文档的推断 . 114
6.4.5 PLSA与 LDA的联系与区别 . 115
6.5进一步阅读 . 115
第 7章情感分析与观点挖掘 117
7.1概述 . 117
7.2情感分析任务类型 . 118
7.2.1按目标形式划分 . 118
7.2.2按分析粒度划分 . 119
7.3文档或句子级情感分析方法 . 121
7.3.1基于规则的无监督情感分类 . 122
7.3.2基于传统机器学习的监督情感分类 . 123
7.3.3深度神经网络方法 126
文本数据挖掘
7.4词语级情感分析与情感词典构建 . 131
7.4.1基于语义知识库的方法 . 131
7.4.2基于语料库的方法 131
7.4.3情感词典性能评估 134
7.5属性级情感分析 134
7.5.1属性抽取 . 135
7.5.2属性情感分类 . 138
7.5.3主题与情感的生成式建模 141
7.6情感分析中的特殊问题 143
7.6.1情感极性转移问题 143
7.6.2领域适应问题 . 145
7.7进一步阅读 . 147
第 8章话题检测与跟踪 . 149
8.1概述 . 149
8.2术语与任务 . 151
8.2.1术语 151
8.2.2任务 152
8.3报道或话题的表示与相似性计算 . 154
8.4话题检测 156
8.4.1话题在线检测 . 157
8.4.2话题回溯检测 . 158
8.5话题跟踪 159
8.6评估方法 160
8.7社交媒体话题检测与跟踪 . 161
8.7.1社交媒体话题检测 162
8.7.2社交媒体话题跟踪 163
8.8突发话题检测 . 163
8.8.1突发状态识别 . 164
8.8.2以文档为中心的方法:先检测话题后评估突发性 . 167
8.8.3以特征为中心的方法:先识别突发特征后生成突发话题 . 168
8.9进一步阅读 . 169
第 9章信息抽取 . 171
9.1概述 . 171
9.2命名实体识别 . 173
9.2.1基于规则的命名实体识别方法 . 174
目录 XI
9.2.2有监督的命名实体识别方法 . 175
9.2.3半监督的命名实体识别方法 . 181
9.2.4命名实体识别方法评价 . 183
9.3共指消解 184
9.3.1基于规则的共指消解方法 185
9.3.2数据驱动的共指消解方法 187
9.3.3共指消解评价 . 190
9.4实体消歧 193
9.4.1基于聚类的实体消歧方法 193
9.4.2基于链接的实体消歧 . 197
9.4.3实体消歧任务的评价方法 203
9.5关系抽取 204
9.5.1基于离散特征的关系分类方法 . 206
9.5.2基于分布式特征的关系分类方法 212
9.5.3基于远程监督的关系分类方法 . 214
9.5.4关系分类性能评价 215
9.6事件抽取 215
9.6.1事件描述模板 . 215
9.6.2事件抽取方法 . 217
9.6.3事件抽取评价 . 224
9.7进一步阅读 . 224
第 10章文本自动摘要 227
10.1概述 . 227
10.2抽取式自动摘要 228
10.2.1句子重要性评估 229
10.2.2基于约束的摘要生成方法 . 237
10.3压缩式自动摘要方法 238
10.3.1句子压缩方法 238
10.3.2基于句子压缩的自动摘要方法 242
10.4生成式自动摘要 244
10.4.1基于信息融合的生成式摘要方法 . 244
10.4.2基于编码 -解码的生成式摘要方法 249
10.5基于查询的自动摘要 251
10.5.1基于语言模型的相关性计算方法 . 251
10.5.2基于关键词语重合度的相关性计算方法 . 252
10.5.3基于图模型的相关性计算方法 252
10.6跨语言和多语言自动摘要方法 253
10.6.1跨语言自动摘要 253
10.6.2多语言自动摘要 256
10.7摘要质量评估方法和相关评测 258
10.7.1摘要质量评估方法 . 258
10.7.2相关评测活动 262
10.8进一步阅读 . 263
参考文献 . 265
名词术语索引 . 285
· · · · · · (收起)
读后感
用户评价
我注意到这本书的索引和附录部分做得极为详尽和实用,这简直是深度研究者梦寐以求的配置。当我只是想快速核对某个特定概念的定义或者追溯某个理论的原始出处时,那份条理清晰的索引系统帮了我一个大忙,它不仅仅是简单的页码罗列,更像是作者为你精心规划的一张知识地图,让你能迅速定位到你感兴趣的知识节点,而不用在厚厚的篇幅中盲目搜寻。而那些附录中的补充材料,比如详细的数学推导或者大型数据集的格式说明,更是体现了作者对读者需求的深刻体察。他明白,真正需要深入学习的人,往往需要超越主文内容的细节支持。这种对“工具性”的重视,让这本书的实用价值倍增。它不再仅仅是提供阅读乐趣或理论启发,而是真正成为了一个可以随时查阅、随时调用的、可靠的专业参考工具箱,是那种我愿意放在案头,随时翻开查阅的常备用书。
评分这本书的行文风格简直是教科书级别的典范,充满了严谨的逻辑推导和清晰的论证脉络。作者似乎非常擅长将复杂抽象的概念“切片”并逐层递进地展示出来,读起来完全没有那种抓不住重点的漂浮感。每一段落的展开都像是精心搭建的积木,上一句为下一句做了坚实的铺垫,读到关键转折处时,豁然开朗的感觉让人忍不住想在页边空白处做个标记。我注意到作者在引入新术语时,总是习惯性地先给出背景铺垫,再进行定义,这种做法极大地降低了初学者的理解门槛。更难能可贵的是,即便是在讨论那些公认的硬核理论时,作者也尽量避免了过于晦涩的行话堆砌,而是努力用更具画面感的语言去描摹那个理论模型是如何运作的。这种“带着走”的叙事节奏,让原本可能枯燥的理论学习过程,变成了一场引人入胜的智力探索之旅,让人很自然地就想一口气读下去,去探寻下一个逻辑分支究竟通向何方。
评分这本书的深度超出了我原本的预期,它显然不是那种走马观花的入门读物,而是面向有一定基础的进阶读者的深度剖析。我特别留意了其中关于方法论比较的章节,作者并没有简单地罗列优缺点,而是深入剖析了不同方法论背后的哲学基础和适用场景的内在差异。这种对“为什么”而不是仅仅“是什么”的追问,是真正区分一本优秀学术著作和平庸参考书的关键。书中引用的案例和数据也显得极为新鲜和具有时效性,这表明作者在撰写过程中付出了巨大的精力去追踪最新的研究动态和行业实践,确保了内容的“保鲜度”。我感觉,这本书的价值不在于教会你具体的操作步骤,而在于塑造你分析问题的思维框架,它更像是一个“炼丹炉”,能将你已有的知识经验进行高温提纯,最终结晶出更具洞察力的理解。对于那些渴望从“知道”跨越到“理解”层面的读者来说,这本书无疑是一座需要耐心攀登的高峰。
评分这本书在语言的运用上,透露着一种微妙的、几乎是文学性的精确性,这在技术类书籍中是极为罕见的品质。作者似乎对每一个词语的搭配都经过了深思熟虑,力求达到“信、达、雅”中的“雅”的境界。举个例子,有些描述复杂过程的句子,如果换作一般作者,可能就是平铺直叙的指令式陈述,但在这里,它们却被组织成了富有节奏感的长句,读起来仿佛在听一段结构精巧的赋格曲,每一个从句都在精确地服务于主旨,彼此间的关系被梳理得井井有条,既不拖泥带水,又不失必要的铺陈。这种风格要求读者必须全神贯注,因为它不提供冗余的解释来弥补理解上的松懈,但一旦你跟上了它的韵律,你会发现这种高效的表达方式带来的信息密度是惊人的。我甚至在某些段落中体会到了一种近乎诗意的简洁,仿佛作者在用最少的笔墨,描绘出最广阔的理论图景。
评分这本书的装帧设计真是一绝,那种略带粗粝感的封面材质,配合着沉稳的墨绿色调,一下子就抓住了我的眼球。初拿到手的时候,我甚至有点舍不得马上翻开,生怕破坏了它散发出来的那种学术的庄重感。拿到图书馆里与其他新书对比,它立刻就显得与众不同,不是那种流于表面的花哨,而是内敛的、有深度的质感。内页的纸张选择也十分考究,字迹清晰,排版疏朗有致,即便是长时间阅读也不会让人感到视觉疲劳。我尤其欣赏它在章节标题上的字体处理,那种带着一丝古典韵味的衬线体,似乎在无声地诉说着知识的厚重与传承。虽然我目前只翻阅了前几页,但仅凭这第一印象,我就能感受到出版方在制作这本书时倾注的心血。这不仅仅是一本书,更像是一件值得收藏的艺术品,它成功地将冰冷的理论知识用一种极为优雅且令人愉悦的方式呈现了出来,这对于提升阅读体验来说,是至关重要的一个环节。
评分通俗易懂 比统计自然语言处理好懂
评分内容有点旧,没跟上最新技术的步伐,对深度学习讲的不够具体,不够透彻
评分书是这样组织的,这里有1234个子问题-我们的论文里是这样做的。失望的地方是给出的答案,包括书末的论文列表,百分之五六十是几位作者或者国科大的成果。没有旁征博引深入浅出启发性的介绍。组织的像一本手册或者一个大型PPT。当然本身国科大的论文质量还是不错的,方法更新到了最近几年的深度学习方法,这是值得一看的地方。所以3-4星之间吧。
评分书是这样组织的,这里有1234个子问题-我们的论文里是这样做的。失望的地方是给出的答案,包括书末的论文列表,百分之五六十是几位作者或者国科大的成果。没有旁征博引深入浅出启发性的介绍。组织的像一本手册或者一个大型PPT。当然本身国科大的论文质量还是不错的,方法更新到了最近几年的深度学习方法,这是值得一看的地方。所以3-4星之间吧。
评分内容有点旧,没跟上最新技术的步伐,对深度学习讲的不够具体,不够透彻
相关图书




本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有