
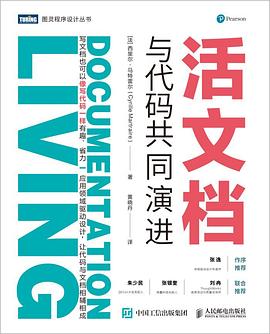

具体描述
这是一本活文档参考指南,教你如何像写代码一样有趣地持续维护文档。
书中系统地阐述了计算机软件开发各个阶段中文档写作的步骤、内容、方法、工具、特点和要求,详尽指导软件开发人员和文档开发工程师写出规范的文档,包括软件文档的概念和内容,软件文档编写的原则和步骤,软件文档的管理和维护,可行性研究报告、软件需求报告、软件测试计划等文档的写作方法和写作技巧。
作者简介
西里尔·马特雷尔(Cyrille Martraire)
Arolla公司CTO、联合创始人,Paris Software Crafters协会创始人,经常在国际性会议上发表演讲。西里尔称自己为开发者,自1999年起他就在为初创公司、软件供应商和各大企业设计软件了。他曾领导过多个重大项目,在处理大型遗留系统方面经验丰富。他对软件设计的各个方面都充满热情,特别是TDD、BDD和DDD。
目录信息
1.1 一则来自活文档世界的故事 1
1.1.1 为什么需要这个功能 1
1.1.2 明天你就不再需要这个草图了 2
1.1.3 抱歉,我们没有营销文档 2
1.1.4 你一直在用这个词,但并非其本意 3
1.1.5 给我看看完整的图,你就知道哪里有问题了 3
1.1.6 活文档属于未来?不,是现在 4
1.2 传统文档存在的问题 4
1.2.1 编写文档通常不太酷 4
1.2.2 文档的缺陷 5
1.2.3 敏捷宣言与文档 9
1.2.4 是时候开启文档2.0 了 9
1.3 文档编写的是知识 10
1.3.1 知识的来源 11
1.3.2 知识如何演进 11
1.3.3 为什么需要知识 11
1.4 文档是为了传递知识 14
1.5 活文档的核心原则 15
1.5.1 可靠 16
1.5.2 省力 16
1.5.3 协作 17
1.5.4 有见地 17
1.5.5 蚂蚁怎么交换知识:共识主动性 18
1.6 大部分知识是已经存在的 18
1.7 固有文档 19
1.7.1 固有文档与外部文档 20
1.7.2 固有文档与外部文档示例 20
1.7.3 首选固有文档 21
1.7.4 就地文档 21
1.7.5 机器可读的文档 22
1.8 专门知识与通用知识 22
1.8.1 学习通用知识 22
1.8.2 专注于专门知识 23
1.9 确保文档准确 23
1.9.1 准确性机制保证文档可靠 23
1.9.2 当文档不需要准确性机制时 25
1.10 挑战文档的大问题 25
1.10.1 质疑是否真的需要文档 26
1.10.2 因缺乏信任而需要文档 26
1.10.3 即时文档,或者未来知识的廉价选择 27
1.10.4 质疑是否需要传统文档 28
1.10.5 减少现在的额外工作 29
1.10.6 减少以后的额外工作 29
1.11 让活动变得有趣 30
1.12 文档重启 31
1.12.1 活文档:非常简短的版本 35
1.12.2 更好的文档编制方法 35
1.13 DDD入门 36
1.13.1 DDD概述 36
1.13.2 活文档和DDD 36
1.13.3 当活文档是DDD应用时 37
1.13.4 BDD、DDD、XP和活文档同根而生 37
1.14 小结 39
第2章 BDD:活需求说明的示例 40
2.1 BDD是为了对话 40
2.2 实现自动化的BDD是为了活文档 41
2.3 在文件中解析场景 42
2.3.1 功能文件的意图 42
2.3.2 功能文件场景 43
2.3.3 需求说明的细节 43
2.3.4 功能文件中的标签 44
2.3.5 场景即交互式活文档 45
2.3.6 将场景做成无聊的纸质文档 46
2.4 功能文件示例 46
2.5 用典型案例展示活文档的方方面面 48
2.6 更进一步:充分利用活文档 48
2.7 小结 51
第3章 知识开发 52
3.1 识别权威性知识 52
3.2 知识现在在哪里 52
3.3 单一来源发布 53
3.3.1 制作并发布文档的示例 54
3.3.2 发布一个带版本号的快照 55
3.3.3 备注 55
3.4 设置一致性机制 55
3.4.1 运行一致性测试 56
3.4.2 关于测试假设的一致性 57
3.4.3 发布的约定 58
3.5 整合分散的信息 59
3.5.1 如何整合知识 60
3.5.2 实施整合的注意事项 61
3.6 现成的文档 61
3.6.1 标准词汇的力量 63
3.6.2 链接到标准知识 64
3.6.3 不仅仅是词汇 64
3.6.4 在会话中使用现成的知识来加速知识传递 65
3.7 工具历史 68
3.8 小结 69
第4章 知识增强 70
4.1 当编程语言不够用时 70
4.2 使用注解编写文档 72
4.2.1 注解不只是标签 73
4.2.2 描述决策背后的依据 74
4.2.3 嵌入式学习 74
4.3 按照约定编写文档 77
4.3.1 使用约定的遗留代码中的活文档 78
4.3.2 记录约定 78
4.3.3 始终遵守约定 79
4.3.4 约定的局限性 79
4.4 外部文档编写方法 80
4.4.1 边车文件 80
4.4.2 元数据数据库 80
4.5 设计自定义注解 81
4.5.1 构造型的属性 81
4.5.2 构造型和战术模式 82
4.5.3 注解包名称要有意义 83
4.5.4 强行将标准注解移作他用 83
4.5.5 标准注解:@Aspect和面向切面编程 84
4.5.6 默认注解或除非必要 85
4.6 处理全模块知识 85
4.6.1 处理多种模块 86
4.6.2 在实践中进行全模块增强 86
4.7 固有知识增强 87
4.8 机器可访问的文档 88
4.9 记录你的决策依据 90
4.9.1 依据里有什么 91
4.9.2 使依据明确 92
4.9.3 超越文档:被激发的设计 92
4.9.4 避免记录猜测 92
4.9.5 作为预记录依据的技能 93
4.9.6 将依据记录作为推动变革的因素 93
4.10 确认你的影响力(又名项目参考文献) 94
4.11 将提交消息作为全面的文档 95
4.12 小结 98
第5章 活知识管理:识别权威性知识 99
5.1 动态的知识管理 99
5.1.1 动态知识管理的示例 100
5.1.2 需要编辑的知识管理 101
5.1.3 不太需要维护的动态知识管理 101
5.1.4 一库多用的知识语料库 102
5.1.5 场景摘要 102
5.2 突出核心 103
5.3 突出启发性的范例 104
5.4 导览和观光地图 106
5.4.1 创建观光地图 108
5.4.2 创建导览 109
5.4.3 创建活导览 111
5.4.4 一个可怜人的文学式编程 112
5.5 总结:策展人筹备一场艺术展览 113
5.5.1 选择和整理现有知识 113
5.5.2 在需要时添加缺失的东西 114
5.5.3 使无法到场和以后的人可以访问 114
5.6 小结 114
第6章 自动化文档 115
6.1 活文档 115
6.1.1 创建活文档的步骤 115
6.1.2 演示规则 116
6.2 活词汇表 116
6.2.1 活词汇表是如何起作用的 117
6.2.2 请举个例子吧 117
6.2.3 活文档的信息管理 119
6.2.4 在限界上下文中创建词汇表 121
6.3 活图表 125
6.3.1 用图表协助对话 126
6.3.2 一图一故事 126
6.3.3 活图表让你诚实 128
6.3.4 追求完美的图表 128
6.3.5 渲染活图表 129
6.3.6 可视化准则 132
6.3.7 示例:六边形架构的活图表 136
6.3.8 案例研究:用活图表呈现业务概览 136
6.3.9 示例:系统上下文图 142
6.3.10 自动生成设计文档所面临的挑战 145
6.4 小结 146
第7章 运行时文档 147
7.1 示例:活服务图表 147
7.1.1 在运行时中增强代码 148
7.1.2 发现架构 149
7.1.3 让这项工作起作用的魔法 149
7.1.4 更进一步 149
7.1.5 可见工作方式:工作的软件即其自身文档 150
7.2 可见测试 150
7.2.1 特定领域的符号 150
7.2.2 生成自定义的领域特定图表,从而获得视觉反馈 152
7.3 示例:使用事件溯源时的可见测试 154
7.3.2 根据事件溯源场景生成的活图表 156
7.4 内省的工作方式:内存中的代码即知识来源 157
7.4.1 使用反射内省 158
7.4.2 不使用反射内省 159
7.5 小结 160
第8章 可重构文档 161
8.1 代码即文档 161
8.1.1 文本布局 162
8.1.2 编码约定 164
8.2 命名作为最初的文档 165
8.2.1 组合方法:你需要为它们命名 166
8.2.2 惯用命名受上下文影响 166
8.2.3 依靠框架编码 166
8.3 类型驱动文档 167
8.3.1 从基本类型到类型 167
8.3.2 被记录的类型和集成的文档 168
8.3.3 类型和关联 168
8.3.4 类型优于注释 169
8.4 组合方法 171
8.5 连贯风格 172
8.5.1 使用内部DSL 172
8.5.2 实现连贯接口 173
8.5.3 连贯风格的测试 173
8.5.4 创建一种DSTL 174
8.5.5 何时不应使用连贯风格 175
8.6 案例研究:由注释引导的重构代码示例 175
8.7 集成的文档 176
8.7.1 类型层次结构 177
8.7.2 代码搜索 177
8.7.3 源自实际用法的语义 177
8.8 使用纯文本图表 178
8.8.1 示例:纯文本图表 178
8.8.2 图表即代码 181
8.9 小结 182
第9章 稳定文档 183
9.1 常青内容 183
9.1.1 需求比设计决策稳定 183
9.1.2 高层级目标往往很稳定 184
9.1.3 很多知识并没有看起来那么稳定 184
9.1.4 案例研究:README文件 184
9.2 关于常青文档的提示 187
9.2.1 避免将策略文档与策略实现文档混在一起 187
9.2.2 确保稳定性 188
9.2.3 使用持久的命名 189
9.2.4 沿着稳定轴组织工件 189
9.3 链接的知识 190
9.3.1 不稳定到稳定的依赖关系 190
9.3.2 断链检查器 191
9.3.3 链接注册表 191
9.3.4 加书签的搜索 192
9.4 稳定知识的类别 192
9.5 愿景声明 193
9.5.1 领域愿景声明 194
9.5.2 目标 195
9.5.3 影响地图 195
9.6 投资稳定知识 196
9.6.1 领域浸入 197
9.6.2 调查墙 197
9.6.3 领域培训 197
9.6.4 “过我的生活”活动 198
9.6.5 影子用户 198
9.6.6 长期投资 198
9.7 小结 198
第10章 避免传统文档 199
10.1 关于正式文档的对话 200
10.1.1 Wiio沟通定律 201
10.1.2 三个解释规则 202
10.1.3 对话的障碍 202
10.2 协同工作,实现持续的知识共享 202
10.2.1 结对编程 203
10.2.2 交叉编程 204
10.2.3 Mob 编程 204
10.2.4 三个(或更多)好朋友 204
10.2.5 事件风暴即熟悉产品的过程 205
10.2.6 知识转移会议 205
10.2.7 持续文档 205
10.2.8 卡车系数 206
10.3 在咖啡机旁沟通 206
10.4 想法沉淀 208
10.5 一次性文档 210
10.6 按需文档 210
10.6.1 即时文档 210
10.6.2 尽早激发即时学习 212
10.6.3 惊讶报告 212
10.6.4 包括一些前期文档 212
10.7 互动式文档 214
10.8 声明式自动化 215
10.8.1 声明式风格 216
10.8.2 声明式依赖关系管理 216
10.8.3 声明式配置管理 218
10.8.4 声明式自动化部署 220
10.8.5 机器文档 223
10.8.6 关于普遍自动化的评论 223
10.9 强制性规范 223
10.9.1 规则的一些例子 224
10.9.2 不断发展规范 225
10.9.3 强制或鼓励 226
10.9.4 声明式规范 226
10.9.5 工具的问题 227
10.9.6 规范还是设计文档呢 227
10.9.7 如果被篡改,保证标签无效 228
10.9.8 信任至上的文化 229
10.10 受限行为 229
10.10.1 轻松地做正确的事 229
10.10.2 不可能出错:防错API 231
10.11 避免编写文档的设计原则 231
10.11.1 可替换性优先 231
10.11.2 一致性优先 231
10.12 示例:零文档游戏 232
10.13 小结 233
第11章 超越文档:活设计 234
11.1 倾听文档 234
11.1.1 领域语言怎么了 235
11.1.2 通过巧合设计编程 235
11.2 谨慎决策 236
11.2.1 “谨慎决策”并不意味着“预先决策” 238
11.2.2 文档是一种代码审查方式 239
11.3 丢脸的文档 239
11.3.1 示例:丢脸的文档 240
11.3.2 故障排除指南 240
11.3.3 丢脸的代码文档 241
11.3.4 记录错误还是避免错误 242
11.4 文档驱动开发 242
11.4.1 文档让你诚实 243
11.4.2 文档驱动和“避免文档”之间的明显矛盾 243
11.5 滥用活文档(反模式) 244
11.6 活文档拖延症 245
11.7 可降解的文档 245
11.8 干净透明 246
11.8.1 诊断工具 248
11.8.2 使用正压清洁内部 250
11.9 无处不在的设计技巧 251
11.10 记者Porter采访Living Doc Doc先生 251
11.11 小结 253
第12章 活架构文档 254
12.1 记录问题 255
12.2 明确的质量属性 257
12.2.1 利害驱动的架构文档 257
12.2.2 显式假设 258
12.2.3 架构简洁说明架构质量高 258
12.2.4 持续发展:易于更改的文档 259
12.3 决策日志 259
12.3.1 结构化决策日志的示例 260
12.3.2 用期刊或博客作为脑转储 263
12.4 分形架构文档 263
12.5 架构全景图 264
12.6 架构规范 266
12.7 透明的架构 268
12.7.1 架构注解 269
12.7.2 强制性设计决策 271
12.8 架构实现检查 272
12.9 测试驱动架构 272
12.9.1 质量属性即场景 273
12.9.2 生产环境中运行时的质量属性 274
12.9.3 其他质量属性 274
12.9.4 从零散的知识到可用的文档 274
12.10 小规模模拟即活架构文档 275
12.10.1 小规模模拟的理想特征 276
12.10.2 简化系统的技术 276
12.10.3 构建小规模模拟就有了一半的乐趣 277
12.11 系统隐喻 278
12.11.1 通过谈论另一个系统来解释这个系统 278
12.11.2 即使没有先验知识也很有用 278
12.11.3 隐喻套隐喻 278
12.12 小结 279
第13章 在新环境中引入活文档 280
13.1 秘密实验 280
13.2 新事物必须能用而且必须被接受 281
13.2.1 渐渐地开始 281
13.2.2 扩大活文档项目的范围并让人看到 282
13.3 案例研究:向团队成员介绍活文档的故事 283
13.3.1 对话优先 283
13.3.2 第一次汇报 284
13.3.3 是时候讨论代码了 284
13.3.4 决策日志和导览 285
13.4 针对活文档的普遍反对意见 286
13.4.1 注解并不是用来编写文档的 286
13.4.2 “我们已经在做了” 286
13.5 将遗留文档迁移到活文档中 287
13.6 边际文档 287
13.7 案例研究:在批处理系统中引入活文档 288
13.7.1 README文件和现成的文档 288
13.7.2 业务行为 289
13.7.3 显露式运行和单一信息源 289
13.7.4 供开发人员使用的集成文档和供其他干系人使用的活词汇表 289
13.7.5 展示设计意图的活图表 290
13.7.6 联系信息和导览 290
13.7.7 微服务总图 290
13.8 向管理层推销活文档 291
13.8.1 从实际问题出发 291
13.8.2 活文档计划 292
13.8.3 对比当前的状况与承诺的更美好的世界——实现人们的愿望 293
13.9 在精神实质上合规 295
13.9.1 案例研究:遵守ITIL合规性要求 296
13.9.2 ITIL示例 296
13.10 小结 297
第14章 为遗留应用程序编写文档 298
14.1 文档破产 298
14.2 遗留应用程序就是知识化石 298
14.3 气泡上下文 300
14.4 叠加结构 302
14.5 突出结构 303
14.6 外部注解 305
14.7 可降解的转化 305
14.7.1 示例:绞杀者应用程序 305
14.7.2 示例:破产 306
14.8 商定标语 306
14.9 强制执行的遗留规则 307
14.10 小结 308
补充知识:显而易见的文档(图灵社区下载)
活文档模式图表(图灵社区下载)
· · · · · · (收起)
读后感
评分
评分
评分
评分
用户评价
我对于这本书中可能触及的“演进”层面尤其感兴趣。软件的生命周期中,重构是常态,而文档往往是重构时最先被遗忘的牺牲品。如果文档能够像代码一样进行版本控制、进行Review,甚至能被Merge Conflict机制所约束,那该是多么理想的状态。这本书的标题暗示了这种动态性,我猜测它会深入讨论如何将文档视为一种“代码资产”来管理,而不是纯粹的“内容资产”。这可能涉及到文档的元数据管理、依赖追踪,甚至是文档的测试策略。如果能够提供一种机制,确保文档的有效性(Validity)与代码的可执行性(Executability)同步,那么这本书的理论价值将远远超出普通的技术手册范畴。
评分对于初入行的新人来说,理解一个庞大代码库的逻辑结构常常像在迷宫里摸索。那些冗长、晦涩的README文件往往只是一个开始,真正的知识隐藏在注释和设计决策的“潜台词”里。这本书如果能深入探讨如何让文档“主动”地向读者展示这些隐性知识,那价值就太大了。想象一下,如果代码块本身就能携带解释性的注释,并且这些注释能够被工具提取并组织成易于导航的指南,岂不是能极大地降低新成员的学习曲线?我希望看到书中能有具体的案例,展示如何设计这样的“活文档”结构,使其既能服务于快速参考,又能支持深层次的架构探索,避免信息过载。
评分很多技术书籍要么过于学术化,要么过于偏重某一门具体的语言工具。我期待《活文档:与代码共同演进》能提供一种跨越技术栈的通用理念。如果它仅仅是介绍如何用Markdown配合某个静态站点生成器来写文档,那意义就不大了。我更希望它探讨的是思维模式的转变:如何将撰写文档视为编写代码的一部分,如何量化文档的“健康度”或“新鲜度”。这种思维的转变,才是真正实现“活”文档的关键。我需要的是一套能够被任何技术团队采纳和实施的、关于知识沉淀和传递的哲学,而不是一套针对特定工具的速成手册。这本书能否提供这种宏观的视角和实践的深度结合,将是我判断其价值高低的重要标准。
评分这本书的出版,对我这种常年浸淫在各种技术文档和代码库之间的“老油条”来说,无疑是一个及时的提醒。我们太习惯于把文档和代码看作是两个独立的实体,文档是写给用户的说明书,代码是执行任务的机器。然而,当我们面对一个复杂系统,或者一个需要多人协作维护的项目时,这种割裂带来的维护成本和认知负担是难以估量的。这本书似乎在探讨的,正是如何打破这种壁垒,让文档不再是僵死的、滞后于代码的附属品,而是成为代码本身演进过程中不可分割的一部分。我非常期待看到作者如何构建一个理论框架,让我们能够真正意义上实现“文档与代码共舞”,而不是“文档在代码身后蹒跚”。这不仅关乎编写规范,更关乎一种全新的软件开发哲学。
评分阅读完这本书的概要后,我脑海中立即浮现出无数次修改文档的痛苦经历——代码改动了,文档里还在引用旧的API或者错误的配置路径,结果不是用户抱怨,就是新加入的同事无所适从。这本书似乎瞄准了现代软件工程中的一个痛点:文档的“死期”总是比我们预想的要早。如果它能提供一套切实可行的方法论,让文档的更新与代码的提交、合并流程无缝集成,那将是革命性的。我关注的重点在于其实现细节,它究竟是通过某种自动化工具链,还是更深层次的语言层面的支持来实现这种“活”的状态?一个真正能与代码同呼吸的文档,应该能让我们在阅读代码时,就能同时获取到最准确的上下文信息,这才是高效协作的基石。
评分google annotation gallery 稳定知识是一项可以长期回收的投资。 使用注解丰富知识,通过工具从代码生成文档,使用工具约束架构规范。
评分非常荣幸能在第一时间,阅读到这样一本优秀的书籍。书中关于软件工程文档的各种理念让我不得不重新思考何为文档,为什么需要文档,怎么编写文档,如何阅读文档,如何维护文档……等一系列问题。我是一名Java研发工程师,目前就职于一家拥有300名员工的互联网小公司,从事过产品岗,也从事过iOS开发。对于文档也有自己的认知,书中表达的“活文档“理念刷新了我对传统文档的认知,就如同哥伦布发现新大陆一般。非常推荐各位技术管理岗的同学阅读。
评分近几年的研发管理实践中,一直在探索如何维护管理必要的文档。从需求分析、产品设计到软件开发交付过程中,每个流程都会产生知识,如果以不互通的专用格式存在,重复劳动带来了浪费和不一致。 通过计算机可识别的DSL格式,维护统一的权威知识源,使用自动化工具,根据需要发布wiki,生成图表和word之类专用文档、甚至代码。 工作的软件本身就是一种文档,最重要的是如何设计和组织代码,通过增强代码、边车文件等,维护跟代码一起演化的知识,都是活文档。 声明式定义,例如基础设施即代码、运维自动化脚本、代码规范,也是活文档。 文档和代码都是知识的载体。标签系统、在知识之间建立连接,似乎是任何知识管理系统都必须的。 知识管理是一种编辑行为,好的结果,离不开导演/策展人的整体规划。 最后文档只是手段,沟通知识才是目的
评分近几年的研发管理实践中,一直在探索如何维护管理必要的文档。从需求分析、产品设计到软件开发交付过程中,每个流程都会产生知识,如果以不互通的专用格式存在,重复劳动带来了浪费和不一致。 通过计算机可识别的DSL格式,维护统一的权威知识源,使用自动化工具,根据需要发布wiki,生成图表和word之类专用文档、甚至代码。 工作的软件本身就是一种文档,最重要的是如何设计和组织代码,通过增强代码、边车文件等,维护跟代码一起演化的知识,都是活文档。 声明式定义,例如基础设施即代码、运维自动化脚本、代码规范,也是活文档。 文档和代码都是知识的载体。标签系统、在知识之间建立连接,似乎是任何知识管理系统都必须的。 知识管理是一种编辑行为,好的结果,离不开导演/策展人的整体规划。 最后文档只是手段,沟通知识才是目的
评分google annotation gallery 稳定知识是一项可以长期回收的投资。 使用注解丰富知识,通过工具从代码生成文档,使用工具约束架构规范。
相关图书





本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有