
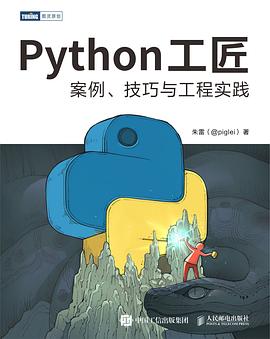

具体描述
◎ 编辑推荐
☆本书基于作者的开源GitHub图书,广受读者喜爱,市面上难得的原创Python进阶图书。
☆写作方式别具一格,核心知识点通过三大板块来阐述:基础知识、案例故事、编程建议。
其中基础知识帮助大家快速回顾Python基础;案例故事由作者经历的编程项目与案 例改编而来,兼具实战性与趣味性;编程建议以大家喜闻乐见的条目式知识点呈现,短小精悍,可直接应用于自己的编程实践中。
◎ 内容简介
本书基于广受好评的“Python工匠”系列开源文章。
全书从工程实践角度出发,通过剖析核心知识、展示典型案例与总结实用技巧,帮助大家系统进阶Python,写好工程代码,做好实践项目。
本书共计13章,分为五大部分:变量与基础类型、语法结构、函数与装饰器、面向对象编程、总结与延伸,涵盖Python编程的方方面面。
作者简介
朱雷(@piglei)
就职于腾讯IEG技术运营部,现任蓝鲸工具PaaS平台负责人,参与和主导了包括“蓝鲸PaaS平台”在内的诸多大型项目。从事后端开发与架构设计十余年,曾就职于搜狐、赶集网。
精通Python语言特性,对如何开发高质量的大型Python工程有独到见解。 从2016年开始创作“Python工匠”系列开源技术文章,其GitHub Star数超过4K,被“腾讯技术工程”等多家媒体全系列转载,收获诸多好评。
GitHub账号:piglei,公众号:piglei。
目录信息
第 1章 变量与注释 1
1.1 基础知识 2
1.1.1 变量常见用法 2
1.1.2 给变量注明类型 4
1.1.3 变量命名原则 6
1.1.4 注释基础知识 11
1.2 案例故事 14
奇怪的冒泡排序算法 15
1.3 编程建议 17
1.3.1 保持变量的一致性 18
1.3.2 变量定义尽量靠近使用 18
1.3.3 定义临时变量提升可读性 20
1.3.4 同一作用域内不要有太多变量 21
1.3.5 能不定义变量就别定义 22
1.3.6 不要使用locals() 23
1.3.7 空行也是一种“注释” 24
1.3.8 先写注释,后写代码 25
1.4 总结 26
第 2章 数值与字符串 28
2.1 基础知识 29
2.1.1 数值基础 29
2.1.2 布尔值其实也是数字 31
2.1.3 字符串常用操作 31
2.1.4 不常用但特别好用的字符串方法 34
2.1.5 字符串与字节串 36
2.2 案例故事 39
2.2.1 代码里的“密码” 39
2.2.2 别轻易成为SQL语句“大师” 41
2.3 编程建议 44
2.3.1 不必预计算字面量表达式 44
2.3.2 使用特殊数字:“无穷大” 46
2.3.3 改善超长字符串的可读性 47
2.3.4 别忘了以r开头的字符串内置方法 48
2.3.5 不要害怕字符串拼接 49
2.4 总结 50
第3章 容器类型 53
3.1 基础知识 54
3.1.1 列表常用操作 54
3.1.2 理解列表的可变性 56
3.1.3 常用元组操作 60
3.1.4 具名元组 61
3.1.5 字典常用操作 63
3.1.6 认识字典的有序性与无序性 66
3.1.7 集合常用操作 68
3.1.8 了解对象的可哈希性 71
3.1.9 深拷贝与浅拷贝 72
3.2 案例故事 74
分析网站访问日志 75
3.3 编程建议 83
3.3.1 用按需返回替代容器 83
3.3.2 了解容器的底层实现 86
3.3.3 掌握如何快速合并字典 89
3.3.4 使用有序字典去重 91
3.3.5 别在遍历列表时同步修改 92
3.3.6 编写推导式的两个“不要” 92
3.3.7 让函数返回NamedTuple 94
3.4 总结 95
第4章 条件分支控制流 97
4.1 基础知识 98
4.1.1 分支惯用写法 98
4.1.2 修改对象的布尔值 101
4.1.3 与None比较时使用is运算符 103
4.2 案例故事 105
消失的分支 105
4.3 编程建议 112
4.3.1 尽量避免多层分支嵌套 112
4.3.2 别写太复杂的条件表达式 114
4.3.3 尽量降低分支内代码的相似性 115
4.3.4 使用“德摩根定律” 116
4.3.5 使用all()/any()函数构建条件表达式 117
4.3.6 留意and和or的运算优先级 118
4.3.7 避开or运算符的陷阱 118
4.4 总结 119
第5章 异常与错误处理 121
5.1 基础知识 122
5.1.1 优先使用异常捕获 122
5.1.2 try语句常用知识 124
5.1.3 抛出异常,而不是返回错误 127
5.1.4 使用上下文管理器 129
5.2 案例故事 133
5.2.1 提前崩溃也挺好 133
5.2.2 异常与抽象一致性 136
5.3 编程建议 139
5.3.1 不要随意忽略异常 139
5.3.2 不要手动做数据校验 140
5.3.3 抛出可区分的异常 142
5.3.4 不要使用assert来检查参数合法性 144
5.3.5 无须处理是最好的错误处理 145
5.4 总结 149
第6章 循环与可迭代对象 151
6.1 基础知识 152
6.1.1 迭代器与可迭代对象 152
6.1.2 修饰可迭代对象优化循环 158
6.1.3 使用itertools模块优化循环 160
6.1.4 循环语句的else关键字 162
6.2 案例故事 164
数字统计任务 164
6.3 编程建议 168
6.3.1 中断嵌套循环的正确方式 168
6.3.2 巧用next()函数 170
6.3.3 当心已被耗尽的迭代器 171
6.4 总结 172
第7章 函数 174
7.1 基础知识 175
7.1.1 函数参数的常用技巧 175
7.1.2 函数返回的常见模式 179
7.1.3 常用函数模块:functools 184
7.2 案例故事 187
函数与状态 187
7.3 编程建议 194
7.3.1 别写太复杂的函数 194
7.3.2 一个函数只包含一层抽象 196
7.3.3 优先使用列表推导式 203
7.3.4 你没有那么需要lambda 204
7.3.5 了解递归的局限性 205
7.4 总结 207
第8章 装饰器 209
8.1 基础知识 211
8.1.1 装饰器基础 211
8.1.2 使用functools.wraps()修饰包装函数 213
8.1.3 实现可选参数装饰器 215
8.1.4 用类来实现装饰器(函数替换) 217
8.1.5 用类来实现装饰器(实例替换) 219
8.1.6 使用wrapt模块助力装饰器编写 221
8.2 编程建议 223
8.2.1 了解装饰器的本质优势 223
8.2.2 使用类装饰器替代元类 225
8.2.3 别弄混装饰器和装饰器模式 226
8.2.4 浅装饰器,深实现 227
8.3 总结 228
第9章 面向对象编程 230
9.1 基础知识 232
9.1.1 类常用知识 232
9.1.2 内置类方法装饰器 235
9.1.3 鸭子类型及其局限性 239
9.1.4 抽象类 242
9.1.5 多重继承与MRO 248
9.1.6 其他知识 251
9.2 案例故事 255
继承是把双刃剑 255
9.3 编程建议 265
9.3.1 使用__init_subclass__替代元类 265
9.3.2 在分支中寻找多态的应用时机 266
9.3.3 有序组织你的类方法 268
9.3.4 函数搭配,干活不累 270
9.4 总结 274
第 10章 面向对象设计原则(上) 276
10.1 类型注解基础 278
10.2 SRP:单一职责原则 279
10.2.1 案例:一个简单的Hacker News爬虫 280
10.2.2 违反SRP的坏处 283
10.2.3 大类拆小类 284
10.3 OCP:开放-关闭原则 285
10.3.1 接受OCP的考验 286
10.3.2 通过继承改造代码 288
10.3.3 使用组合与依赖注入 289
10.3.4 使用数据驱动 292
10.4 总结 294
第 11章 面向对象设计原则(下) 295
11.1 LSP:里式替换原则 296
11.1.1 子类随意抛出异常 296
11.1.2 子类随意调整方法参数与返回值 300
11.1.3 基于隐式合约违反LSP 304
11.1.4 LSP小结 306
11.2 DIP:依赖倒置原则 306
11.2.1 案例:按来源统计Hacker News条目数量 307
11.2.2 为脚本编写单元测试 309
11.2.3 实现DIP 311
11.2.4 倒置后的单元测试 314
11.2.5 DIP小结 315
11.3 ISP:接口隔离原则 317
11.3.1 案例:处理页面归档需求 317
11.3.2 修改实体类 318
11.3.3 违反ISP 320
11.3.4 分拆接口 320
11.3.5 其他违反ISP的场景 322
11.4 总结 322
第 12章 数据模型与描述符 324
12.1 基础知识 326
12.1.1 字符串魔法方法 326
12.1.2 比较运算符重载 329
12.1.3 描述符 332
12.2 案例故事 341
处理旅游数据的三种方案 341
12.3 编程建议 350
12.3.1 认识__hash__的危险性 350
12.3.2 数据模型不是“躺赢”之道 351
12.3.3 不要依赖__del__方法 353
12.4 总结 354
第 13章 开发大型项目 356
13.1 常用工具介绍 357
13.1.1 flake8 357
13.1.2 isort 360
13.1.3 black 361
13.1.4 pre-commit 364
13.1.5 mypy 365
13.2 单元测试简介 366
13.2.1 unittest 367
13.2.2 pytest 369
13.3 有关单元测试的建议 375
13.3.1 写单元测试不是浪费时间 375
13.3.2 不要总想着“补”测试 377
13.3.3 难测试的代码就是烂代码 378
13.3.4 像应用代码一样对待测试代码 379
13.3.5 避免教条主义 380
13.4 总结 381
结语 383
· · · · · · (收起)
读后感
Python 能干的事情实在太多了,掰着指头数有点不够用。 Web 开发、数据分析、网络爬虫、自动化运维、后台开发、机器学习....... 如果你知道主攻哪个方向,只需重点去学习。不过,不论哪个方向,Python 编程的核心知识都是需要掌握的。这两年 Python 很热,教大家入门 Python 的...
评分Python 能干的事情实在太多了,掰着指头数有点不够用。 Web 开发、数据分析、网络爬虫、自动化运维、后台开发、机器学习....... 如果你知道主攻哪个方向,只需重点去学习。不过,不论哪个方向,Python 编程的核心知识都是需要掌握的。这两年 Python 很热,教大家入门 Python 的...
评分 评分Python 能干的事情实在太多了,掰着指头数有点不够用。 Web 开发、数据分析、网络爬虫、自动化运维、后台开发、机器学习....... 如果你知道主攻哪个方向,只需重点去学习。不过,不论哪个方向,Python 编程的核心知识都是需要掌握的。这两年 Python 很热,教大家入门 Python 的...
评分Python 能干的事情实在太多了,掰着指头数有点不够用。 Web 开发、数据分析、网络爬虫、自动化运维、后台开发、机器学习....... 如果你知道主攻哪个方向,只需重点去学习。不过,不论哪个方向,Python 编程的核心知识都是需要掌握的。这两年 Python 很热,教大家入门 Python 的...
用户评价
说实话,我对技术书籍通常抱有一种敬而远之的态度,因为很多书写得过于学术化,让人难以亲近。但这本书完全打破了我的偏见。作者的叙述风格非常接地气,语言流畅自然,就像一位资深的前辈在给你传授经验。我记得其中关于调试技巧的章节,作者竟然用了一个关于“寻找丢失的袜子”的比喻来解释如何定位一个难以捉摸的Bug,真是既幽默又精准。这种将枯燥的技术点与生活场景巧妙结合的能力,极大地降低了学习的门槛。它让我感到,编程并非高不可攀的象牙塔里的学问,而是可以融入日常工作、解决实际问题的强大工具。对于那些还在为看不懂厚厚的技术手册而感到沮丧的人,这本书绝对是能点燃你学习热情的“火种”。
评分这本书的阅读体验简直是一场思想的盛宴。作者的笔触极其老练,文字中透露出对编程艺术的深刻理解。我尤其喜欢作者在阐述编程范式时的那种辩证思维,他并没有简单地推崇某一种特定的方法,而是引导读者去思考在不同场景下,哪种方式更为合适。书中对性能优化的讲解部分,简直是神来之笔。我记得有一节专门讨论了列表推导式和普通循环在特定情况下的效率差异,并且提供了实用的基准测试方法。这种脚踏实地的分析,远比那些空泛的“要优化”的口号要有价值得多。它让我意识到,编写优雅的代码不仅仅是写出能运行的代码,更重要的是要写出高效、可维护的代码。每一次翻阅,都会发现一些新的闪光点,仿佛每一次阅读都是一次深度的代码重构之旅,让我对“工匠精神”有了更具体的认识。
评分这本书的封面设计得非常引人注目,充满了科技感和一种复古的韵味,让人一拿到手就忍不住想深入了解它的内容。我花了几天时间沉浸其中,感觉自己像是在和一位经验丰富的工匠面对面交流。书中的代码示例清晰、准确,不仅展示了如何实现某个功能,更深入地剖析了背后的设计思想。特别是关于面向对象编程的那几章,作者用非常生活化的比喻,将复杂的概念阐述得淋漓尽致,让我这个之前一直对OOP感到困惑的初学者豁然开朗。我特别欣赏作者在讲解高级特性时所展现出的耐心和细致,从基础的语法结构到复杂的内存管理,层层递进,没有一处含糊不清。读完这部分内容后,我感觉自己对Python的理解不再停留在“能用”的层面,而是开始向“会用”和“用好”迈进。这本书对于那些希望从初级向中高级迈进的开发者来说,无疑是一份宝贵的指引。
评分这本书的价值远超于一本普通的编程指南,它更像是一部关于“如何成为优秀程序员”的哲学著作。作者在探讨Python的特性时,总能引申到更深层次的软件工程原则。我尤其被其中关于代码可读性重要性的论述所打动。作者没有用空洞的口号,而是通过对比晦涩难懂的代码块和清晰优美的实现方式,直观地展示了“写给人看的代码”的重要性。这种对细节的执着和对质量的追求,深深地感染了我。它让我开始反思自己过去写代码时的随意性,并下定决心要以更高的标准要求自己。这本书带来的不仅仅是技术的提升,更是一种职业素养和态度的重塑,让人受益终生。
评分这本书的结构安排堪称教科书级别。从最初的模块化设计理念,到后期关于测试驱动开发(TDD)的实践指南,每一步的过渡都显得那么自然合理。我特别欣赏作者在讲解如何构建健壮的应用程序时所展现出的系统性思维。他不仅教我们如何写出功能性的代码,更重要的是教我们如何构建一个易于扩展、稳定可靠的软件架构。书中的项目案例选择得非常巧妙,它们规模适中,足以展示复杂性,但又不会因为过于庞大而让人望而却步。我尝试跟着书中的步骤复现了一个小型数据处理工具,整个过程异常顺畅,获得的成就感是巨大的。这套逻辑框架的建立,对我后续独立承担更大型项目的开发工作,打下了无比坚实的基础。
评分我认为这是一本和《Python Cookbook》同样有用的技术书籍。
评分不只是 python
评分总体比较浅 但有些有用的tricks
评分初级和中级之间补充的一本书。书中有很多代码是略过的。这点提出批评。有些地方代码过于简陋,单纯是伪代码,无法运行
评分偏向 Python 工程技法的一本书,里面的建议都还挺受用的
相关图书






本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有