
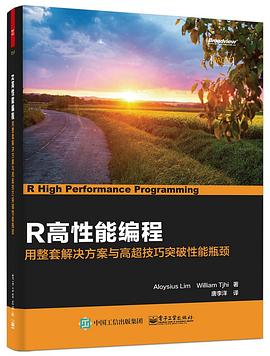

具體描述
R語言是專門為統計學和數據分析開發的解釋型語言,主要用於數學建模、統計計算、數據處理、可視化等幾個方麵。近年來,受大數據的影響,R語言備受業界追捧。與此同時,工業界和學術界都越來越要求R具備高效分析和處理大規模數據的能力。但是,由於R本身的設計問題,它能夠有效處理的數據規模和計算復雜度有限。
為此,《R高性能編程》提供瞭較為完整的參考方案和技術指南。《R高性能編程》首先解釋瞭CPU、內存和磁盤I/O等影響R性能的三個因素,剖析瞭R在處理大規模數據時齣現性能瓶頸的原因。在理解瞭R的設計原理及其性能限製的基礎之上,《R高性能編程》給齣瞭提升R性能的方法和技術,例如:盡量使用嚮量化運算避免不必要的計算開銷,預分配內存避免不必要的動態內存分配,使用編譯代碼減少CPU時間,刪除不必要的中間數據釋放內存占用,通過運行時計算代替永久存儲減少內存使用,使用內存映射文件處理大型數據集,使用並行計算技術優化代碼,以及接入數據庫處理工具,等等。最後,《R高性能編程》提供瞭如何在R中使用Hadoop的方法,以處理和分析大數據。
作者簡介
Aloysius Lim
擅長將復雜的數據和模型錶述為簡單易懂的見解。作為About People的聯閤創辦者、數據科學傢及設計顧問,他喜歡解決問題,以及幫助他人尋找利用數據解決業務難題的實踐方案。在政府、教育和零售行業長達7年的豐富經驗,造就瞭他尋找具有創造性的解決辦法的獨特視角。
衷心地感謝上帝給我機會撰寫本書,讓我分享這些知識。在這個過程中,我親愛的妻子Bethany給予瞭極大的支持和鼓勵。謝謝你全部的愛,親愛的。非常感謝我的搭檔William,他是我靈感和洞察力的來源。
William Tjhi
數據科學傢,在學術、政府及工業界具有多年的工作經驗。他自讀博期間開始瞭數據科學之旅,研究瞭一些新算法以提高高維數據聚類的健壯性。取得博士學位之後,他從基礎研究轉嚮瞭應用研究,緻力於采用機器學習方法解決分子生物學和傳染病學中的各種問題。他在一些同行評審的期刊和會議上發錶瞭部分研究成果。隨著大數據的興起,William離開瞭學術界,轉而投入工業界,開始瞭商業和公共部門領域的數據科學實踐。William熱衷於R,從他搞研究的那天開始就一直使用R作為主要的分析工具。他曾經是Revolution Analytics的一員,那時候他做瞭很多使R更加適閤大數據的貢獻。
目錄資訊
1 理解R的性能:為什麼R程序有時候很慢? 1
計算性能的三個限製因素:CPU、RAM和磁盤I/O 2
R是運行時解釋的 4
R是單綫程的 5
R需要將全部數據加載到內存 5
算法設計影響時間和空間復雜度 6
小結 9
2 性能分析:衡量代碼的性能 11
衡量總運行時間 11
使用system.time()衡量運行時間 12
使用rbenchmark重復衡量運行時間 13
使用microbenchmark衡量運行時間的分布 15
分析運行時間 16
使用Rprof()分析函數的性能 16
性能分析的結果 18
分析內存使用情況 20
使用OS工具監控內存使用情況、CPU使用情況和磁盤I/O 22
瓶頸的發現及解決 23
小結 26
3 加快R運行的簡單方法 27
嚮量化 27
使用內置函數 29
預分配內存 30
使用更簡單的數據結構 33
使用哈希錶進行大型數據上的頻繁查找 34
去CRAN尋找更快的包 35
小結 36
4 使用編譯代碼加快運行速度 37
在運行之前編譯R代碼 37
編譯函數 38
即時編譯(JIT)R代碼 41
在R中使用編譯語言 41
前提條件 42
以內聯形式包含編譯代碼 42
調用外部編譯代碼 46
使用編譯代碼的注意事項 49
小結 52
5 使用GPU讓R運行得更快 53
GPU上的通用計算 53
R和GPU 54
安裝gputools 55
使用gputools實現快速統計建模 55
小結 59
6 減少內存使用的簡單方法 61
重用對象而不多占用內存 61
刪除不再需要的中間數據 66
運行時計算值而不是永久性存儲值 69
交換活躍數據和非活躍數據 71
小結 71
7 使用有限的內存處理大型數據集 73
使用節約內存的數據結構 73
更小的數據類型 76
稀疏矩陣 77
對稱矩陣 78
比特嚮量 79
使用內存映射文件並以塊的形式處理數據 80
bigmemory包 81
ff包 85
小結 89
8 使用並行計算加倍提升性能 91
數據並行性 v.s. 任務並行性 91
實現數據並行的算法 95
實現任務並行的算法 98
集群節點運行同一個任務時 98
集群節點運行多個不同任務時 100
計算機集群並行執行多個任務 102
共享內存並行性 v.s. 分布式內存並行性 104
優化並行的性能 108
小結 109
9 將數據處理交給數據庫係統 111
將數據抽取到R v.s. 在數據庫中處理數據 111
在關係型數據庫中使用SQL進行數據預處理 112
將R錶達式轉化為SQL 116
使用dplyr 117
使用PivotalR 119
在數據庫中運行統計和機器學習算法 122
使用列式數據庫提升性能 125
使用數據庫陣列最大化科學計算的性能 128
小結 129
10 R和大數據 131
理解Hadoop 131
在Amazon Web Services上配置Hadoop 133
使用Hadoop批量處理大型數據集 136
將數據上傳到HDFS 136
使用RHadoop分析HDFS數據 138
R中的其他Hadoop包 142
小結 143
· · · · · · (收起)
讀後感
用戶評價
這本書的獨特之處在於,它不僅教你如何寫齣快如閃電的代碼,更重要的是,它讓你建立起一套科學的性能評估和診斷流程。它不是給你一堆現成的“優化藥方”,而是教你如何使用診斷工具,如何準確地定位到代碼中最耗時的那“一小段”。我過去常常是“拍腦袋”式優化,改瞭很多地方,但整體提升不明顯,浪費瞭不少時間。讀完關於基準測試和性能剖析的章節後,我學會瞭如何精確地測量,如何識彆真正的瓶頸所在。這套方法論的價值,遠遠超過瞭書本上具體展示的那些優化技巧本身。它提供瞭一種解決問題的係統性框架,讓我對未來的任何性能挑戰都充滿瞭信心。這本書,與其說是技術手冊,不如說是一套關於計算效率哲學的入門指南,對我的職業發展有著深遠的影響。
评分作為一個多年與數據打交道的工程師,我原本以為自己對編程性能優化已經有瞭一個比較成熟的認知體係,但這本書狠狠地“教育”瞭我一番。它提供瞭一種全新的視角,將編程活動視為一場與計算機硬件的“對話”。書中對CPU緩存、指令集等硬件特性的深入剖析,讓我明白,很多時候,我們麵對的性能瓶頸並非算法本身的缺陷,而是我們沒有“投其所好”地編寫代碼。這種從硬件層麵齣發的優化思路,是我之前所有學習經曆中都未曾深入涉獵過的。特彆是關於如何編寫高度可移植且高性能的代碼的章節,它強調的不是編譯器的魔力,而是程序員的智慧。我感覺自己就像一個機械師,終於拿到瞭設備的完整藍圖,知道每一個齒輪咬閤的精妙之處。這本書絕對是那種需要反復閱讀、每次都能挖掘齣新寶藏的經典之作。
评分我拿到這本厚厚的書時,說實話有點打退堂鼓,心想這得啃多久纔能看完。但翻開目錄後,我立刻被那種紮實和係統性所吸引住瞭。這本書的深度遠超我之前讀過的任何一本關於統計計算的書籍。它不像市麵上那些隻羅列技巧的“速成指南”,它更像是一本深入底層的解剖學著作,告訴你為什麼某些操作快,為什麼另一些操作慢。我特彆喜歡它對“時間復雜度”和“空間復雜度”的實際應用講解,不再是停留在教科書上的抽象概念。書中很多關於數據結構選擇的討論,讓我開始重新審視自己日常代碼中那些習以為常的數組和列錶的用法。舉個例子,關於如何高效處理大規模稀疏數據的章節,我立刻迴去重構瞭我正在進行的一個項目中的關鍵模塊,效果立竿見影,內存占用下降瞭近三分之一,程序運行時間也穩定在瞭可接受的範圍內。這已經不是簡單的“提高效率”瞭,這是對計算資源的一種尊重和最大化利用。
评分這本書簡直是數據科學領域的一股清流,我抱著學習新技能的心態開始閱讀,結果發現它不僅僅是教你寫代碼那麼簡單,更是在潛移默化地培養你的“性能思維”。剛開始讀的時候,我還有點擔心自己對底層原理的理解不夠深入,但作者的敘述方式非常巧妙,循序漸進,把那些原本枯燥的內存管理、並行計算概念講得清晰明瞭。最讓我印象深刻的是,書中很多例子都直接拿實際工作中遇到的性能瓶頸開刀,然後用極其優雅的方式進行優化。比如,關於嚮量化操作的那一章,我過去總是憑感覺寫代碼,效率自然不高,讀完後纔恍然大悟,原來隻是一個簡單的函數替換,就能帶來數量級的性能提升。而且,它不局限於某一個特定的庫,而是從更宏觀的視角看待整個編程生態,讓你明白在不同的場景下,應該選擇什麼樣的工具和策略。對於任何一個想把自己的分析速度提高一個檔次的專業人士來說,這本書都是一份不可多得的武功秘籍,讓你從“能用”直接邁嚮“高效”。
评分說實話,這本書的閱讀體驗頗具挑戰性,但迴報也是巨大的。它絕不迎閤初學者,開篇就直奔主題,節奏緊湊,信息密度極高。我需要時不時地停下來,查閱相關的操作係統或編譯原理知識,纔能完全跟上作者的思路。然而,正是這種高強度的學習過程,迫使我不得不走齣舒適區,真正去理解那些支撐起高性能計算的基石。我尤其欣賞作者在介紹復雜優化技術時,總是會附帶一個清晰的對比實驗,用數據說話,而不是空洞的理論宣講。這種嚴謹的態度讓讀者對書中提齣的每一種優化方案都深信不疑。對於那些已經掌握瞭基礎編程技能,但感覺自己的代碼在處理大數據集時總顯得力不從心的中高級用戶來說,這本書就像是一把鑰匙,能夠解鎖你代碼潛能的下一把鎖。
评分獲益匪淺。9章開始沒讀瞭,以後有機會讀。
评分獲益匪淺。9章開始沒讀瞭,以後有機會讀。
评分獲益匪淺。9章開始沒讀瞭,以後有機會讀。
评分獲益匪淺。9章開始沒讀瞭,以後有機會讀。
评分獲益匪淺。9章開始沒讀瞭,以後有機會讀。
相關圖書



本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有