
Reinforcement Learning pdf epub mobi txt 电子书 下载 2026
- 强化学习
- 机器学习
- 人工智能
- RL
- 计算机科学
- 数学
- MachineLearning
- 计算机
- Reinforcement Learning
- Machine Learning
- Deep Learning
- Agency
- Decision Making
- Value Function
- Quality Control
- Agent Behavior
- Reward Function

具体描述
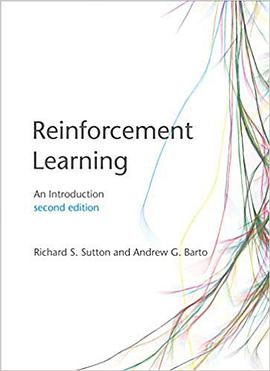
The significantly expanded and updated new edition of a widely used text on reinforcement learning, one of the most active research areas in artificial intelligence.
Reinforcement learning, one of the most active research areas in artificial intelligence, is a computational approach to learning whereby an agent tries to maximize the total amount of reward it receives while interacting with a complex, uncertain environment. In Reinforcement Learning, Richard Sutton and Andrew Barto provide a clear and simple account of the field's key ideas and algorithms. This second edition has been significantly expanded and updated, presenting new topics and updating coverage of other topics.
Like the first edition, this second edition focuses on core online learning algorithms, with the more mathematical material set off in shaded boxes. Part I covers as much of reinforcement learning as possible without going beyond the tabular case for which exact solutions can be found. Many algorithms presented in this part are new to the second edition, including UCB, Expected Sarsa, and Double Learning. Part II extends these ideas to function approximation, with new sections on such topics as artificial neural networks and the Fourier basis, and offers expanded treatment of off-policy learning and policy-gradient methods. Part III has new chapters on reinforcement learning's relationships to psychology and neuroscience, as well as an updated case-studies chapter including AlphaGo and AlphaGo Zero, Atari game playing, and IBM Watson's wagering strategy. The final chapter discusses the future societal impacts of reinforcement learning.
作者简介
Richard S. Sutton is Professor of Computing Science and AITF Chair in Reinforcement Learning and Artificial Intelligence at the University of Alberta, and also Distinguished Research Scientist at DeepMind.
目录信息
读后感
这是一本极好的书,不仅能使你对强化学习有精确、透彻的理解,更能够提升你的思维层次。 接触人工智能领域6年多了,用过统计学习和深度学习做过一些项目。目前,David Silver的教学视频已经过完,这本书读到了第10章(第二版)。下面说一下个人浅陋的理解。 目前应用最广泛的监...
评分[http://incompleteideas.net/book/the-book-2nd.html] 有 [第二版的 PDF(][http://incompleteideas.net/book/bookdraft2018jan1.pdf)][ ],还有 [Python 实现]([https://github.com/ShangtongZhang/reinforcement-learning-an-introduction])。
评分可以在线阅读,还不错的 我还没仔细读,先把网址公布出来,大家一起学习 http://webdocs.cs.ualberta.ca/~sutton/book/ebook/the-book.html
评分可以在线阅读,还不错的 我还没仔细读,先把网址公布出来,大家一起学习 http://webdocs.cs.ualberta.ca/~sutton/book/ebook/the-book.html
评分可以在线阅读,还不错的 我还没仔细读,先把网址公布出来,大家一起学习 http://webdocs.cs.ualberta.ca/~sutton/book/ebook/the-book.html
用户评价
坦白说,这本书的深度和广度远远超出了我最初的预期,它成功地搭建起了一座连接理论与前沿研究的坚实桥梁。我特别敬佩作者在处理一些尚存争议或仍在快速演进的领域时的那种审慎态度。他既没有回避这些“灰色地带”,也没有盲目地下定论,而是客观地呈现了各种主流观点及其背后的逻辑支撑,这体现了极高的学术操守。阅读完之后,我感觉自己对这个领域的认知高度被拔升到了一个新的维度,看待许多既有问题的视角都变得更加立体和全面了。这本书不仅是知识的传授者,更像是思维的催化剂,它激发了我对未知领域更强烈的探索欲望,让我意识到,学习这条路永无止境,而这本书,无疑为我接下来的探索指明了最可靠的星图。
评分我花了整整一个周末沉浸在阅读的乐趣中,这本书的叙事风格简直是教科书级别的流畅与严谨的完美结合。作者似乎有一种魔力,能将那些看似高深莫测的理论概念,用一种极其贴近生活、充满画面感的语言娓娓道来。阅读过程中,我感觉自己不是在被动地接收知识灌输,而是在参与一场由智者引领的深度对话。特别是对那些历史背景和核心思想的梳理,逻辑链条清晰得令人拍案叫绝,仿佛所有看似零散的知识点,都被一把无形的钥匙串联了起来,构建了一个宏大而自洽的知识体系。没有冗余的废话,每一句话都像是经过精心锤炼的宝石,闪烁着智慧的光芒。即便是初次接触该领域的读者,也能被这种引人入胜的叙述方式牢牢抓住,从而心甘情愿地踏入这个知识的迷宫深处,并且确信自己不会迷失方向。
评分这本书的装帧设计简直是一场视觉盛宴,从封面到内页的排版,都透露出一种沉稳又不失现代感的专业气息。我特别喜欢它选择的纸张材质,触感细腻,拿在手里分量十足,让人感觉这不是一本普通的教材,而是一件值得珍藏的艺术品。油墨的印刷质量无可挑剔,字迹清晰锐利,即便是复杂的公式和图表,也能被还原得淋漓尽致,长时间阅读下来,眼睛也不会感到疲劳。内页的留白设计也处理得非常得当,既保证了阅读的舒适度,又为读者预留了做笔记和思考的空间。装帧的工艺也相当扎实,书脊的粘合度很高,即使频繁翻阅也不会出现松动或脱页的现象。从这些细节上就能看出出版方对这本书的重视程度,他们明白,一本好的专业书籍,其物理形态和内容本身同等重要,它应该能够经受住时间的考验,成为读者书架上长久的精神伴侣。这种对细节的极致追求,无疑为阅读体验增添了极大的愉悦感。
评分这本书的章节组织结构,体现了作者极高的教学智慧。它遵循了一种渐进式的学习路径,从基础概念的奠定,到中间复杂模型的剖析,再到最后对未来趋势的展望,每一步的过渡都自然而然,毫无突兀感。我发现自己可以非常高效地安排学习节奏,完全可以根据自己的理解程度来调整进度,而不用担心因为某个环节的跳跃而导致后续内容的理解出现障碍。作者在关键概念的阐述后,通常会穿插一些精心设计的思考题或小测验,这些内容并不是为了考倒读者,而是为了引导我们主动去回顾和内化刚刚学到的知识点,这种主动学习的设计,极大地巩固了我的记忆和理解。这种精心编排的学习曲线,让整个学习过程变得充满掌控感,而不是被动地被信息洪流裹挟前行。
评分与其他同类书籍相比,这本书在案例分析和实际应用层面的深度挖掘,达到了一个令人惊叹的高度。它没有停留在纯粹的理论推演,而是大量引入了跨行业的、具有前瞻性的实践案例,这极大地拓宽了我的视野。我尤其欣赏作者在分析每一个案例时所展现出的那种批判性思维,他不仅仅是罗列“发生了什么”,更深入地剖析了“为什么会这样”以及“未来如何改进”。这种结构化的分析方法,让我学会了如何将抽象的框架应用于具体的复杂场景中,而不是仅仅停留在纸上谈兵的层面。书中提供的工具和方法论,具有极强的可操作性,我已经迫不及待地想将其中几项策略应用到我目前正在进行的项目中去检验其效果。这已经超越了一本理论书籍的范畴,更像是一本实战指导手册,极具价值。
评分不好读。
评分强化学习必看书,还是草稿的时候从头到尾看了一遍,至少应该再看一遍。
评分RL的经典教科书。
评分第二版是98年第一版基础上修订的,在原有基础上增加了一些神经网络相关算法。但原有知识架构还是比较老的,不过非常适合刚接触RL的新手。我只看了前三章基础,后面选择性看了几个重要的章节。前三章虽然基础,但内容非常引人入胜,语言逻辑清晰便于理解,从最基础的MDP讲起到Monte Carlo方法、到经典dynamic programing,后面章节再逐渐到用的最广的Q-learning和policy gradient等方法,一步一步加深完善,便于系统学习知识。Richard Sutton的RL经典,推荐!
评分看了前两部分
相关图书



本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有