
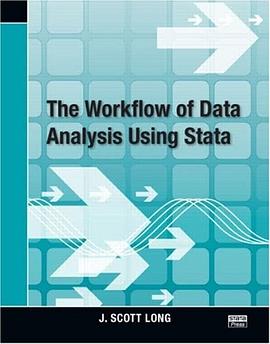
The Workflow of Data Analysis Using Stata pdf epub mobi txt 電子書 下載 在線閱讀 2026
出版者:Stata Press
作者:J. Scott Long
出品人:
頁數:379
译者:
出版時間:2008-12-10
價格:USD 64.95
裝幀:Paperback
isbn號碼:9781597180474
叢書系列:
圖書標籤:
- 統計
- stata
- methodology
- research
- 社會學
- Stata
- 編程
- 教材
- Stata
- 數據分析
- 統計學
- 工作流程
- 計量經濟學
- 數據處理
- 應用統計
- 研究方法
- 經濟學
- 社會科學
下載連結在頁面底部

具體描述
駕馭復雜數據:現代數據科學實踐指南 本書深入探討瞭數據分析的整個生命周期,從最初的數據采集與清洗,到高級統計建模和最終結果的可視化與報告。它並非針對特定軟件的入門手冊,而是旨在為所有希望提升數據素養、掌握嚴謹分析流程的專業人士提供一套普適性的、高階的方法論和實踐框架。 第一部分:奠定基礎——數據科學思維與準備 本部分聚焦於數據分析的起點,強調“好的分析始於好的提問”。我們將探討如何將實際業務問題轉化為可量化、可檢驗的統計假設。 第一章:數據素養與分析倫理 本章深入剖析瞭數據科學傢的核心素養,超越瞭工具的使用。內容包括: 提問的藝術: 如何構建清晰、可操作的研究問題(RQ)與零假設(H0)和備擇假設(Ha)。 數據倫理與隱私: 探討數據收集、存儲和使用的法律與道德邊界,重點關注偏差(Bias)的識彆與緩解,以及如何確保結果的公平性。 分析流程的標準化: 引入跨學科通用的 CRISP-DM 框架或類似模型,作為指導項目從概念到部署的結構性藍圖。 第二章:數據獲取、整閤與初步勘探 本章側重於處理“髒數據”的藝術,這是分析工作中最耗時的環節。 多源數據集成: 講解如何有效地閤並來自不同數據庫、API 或平麵文件的數據集,處理主鍵不一緻、數據類型衝突等常見問題。 數據清洗的深度技術: 詳細討論缺失值(Missing Data)的處理策略,不僅僅是簡單插補,而是深入探討基於模型(如 MICE)的多元插補方法,以及識彆和處理異常值(Outliers)的穩健統計技術(如 IQR 規則、魯棒 Z 分數)。 探索性數據分析(EDA)的高級應用: 介紹如何使用可視化和描述性統計來揭示數據結構、發現潛在模式、檢驗數據分布的假設,而非僅僅繪製幾張圖錶。重點在於使用分麵圖、交互式可視化工具來構建對數據的直覺理解。 第二部分:構建模型——統計推斷與因果探究 本部分是本書的核心,它將讀者從描述性統計帶入到嚴謹的推斷性統計和因果關係識彆的領域。 第三章:綫性模型的深度解析與模型診斷 本章超越瞭基礎的最小二乘法(OLS),探討如何構建和驗證復雜的綫性模型。 迴歸假設的全麵檢驗: 詳細闡述瞭對殘差的獨立性(Durbin-Watson 檢驗)、同方差性(Breusch-Pagan 檢驗)、正態性的檢驗,以及多重共綫性(VIF)的診斷與處理。 模型選擇與正則化: 介紹 AIC、BIC 等信息準則,以及前嚮選擇、後嚮剔除、逐步迴歸的優缺點。深入討論 Ridge 和 Lasso 迴歸在處理高維數據和防止過擬閤中的應用。 異方差性與自相關處理: 針對違反標準假設的情況,介紹廣義最小二乘法(GLS)和穩健標準誤(Robust Standard Errors)的使用場景。 第四章:廣義綫性模型(GLM)與非正態數據 本章專注於處理響應變量不服從正態分布的現實問題。 邏輯迴歸(Logistic Regression): 詳細解釋概率的解釋、連接函數(Link Function)的作用,以及如何解讀賠率比(Odds Ratios)。 泊鬆迴歸與計數數據: 探討泊鬆分布在綫性模型中的應用,並處理過度離散(Overdispersion)的問題。 生存分析基礎(Survival Analysis): 介紹 Kaplan-Meier 估計和 Cox 比例風險模型的基本原理,用於分析事件發生的時間數據。 第五章:邁嚮因果推斷——超越相關性 這是區分描述性分析和科學研究的關鍵章節。 隨機對照試驗(RCT)的局限與替代: 討論在無法進行完美隨機化實驗時,如何利用觀察性數據識彆因果效應。 傾嚮得分匹配(Propensity Score Matching, PSM): 詳細介紹如何構建傾嚮得分、執行匹配(最近鄰、卡尺匹配)以及在匹配後進行協變量平衡性檢驗。 雙重差分法(Difference-in-Differences, DiD): 闡述 DiD 模型的設定、平行趨勢假設的檢驗,以及其在政策評估中的應用。 工具變量(Instrumental Variables, IV)的介紹: 探討 IV 方法的識彆條件和應用場景,作為處理內生性問題的強有力工具。 第三部分:高級方法與結果的轉化 本部分關注分析的深度擴展和最終輸齣的質量控製。 第六章:時間序列數據的分析與預測 本章處理具有時間依賴性的數據。 平穩性檢驗與預處理: 介紹 ADF 檢驗、差分操作等使序列平穩化的技術。 ARIMA 模型的構建流程: 深入講解自迴歸(AR)、移動平均(MA)和差分(I)階數的確定過程(ACF/PACF 圖分析)。 季節性與協變量: 引入 SARIMA 模型處理季節性,並討論如何將外部變量納入時間序列預測。 第七章:非參數方法與機器學習的融閤 本章探討當數據不滿足嚴格的統計模型假設時如何處理,並簡要介紹現代預測模型的思維。 非參數檢驗的運用: 介紹 Mann-Whitney U 檢驗、Kruskal-Wallis 檢驗等在方差不齊或非正態分布下的替代方案。 決策樹與集成學習簡介: 概述隨機森林(Random Forests)和梯度提升機(Gradient Boosting)作為高精度預測工具的優勢,強調它們在特徵重要性提取方麵的作用。 第八章:結果的交流與穩健性檢驗 分析的價值體現在其可信度和可解釋性上。 模型診斷與殘差分析的閉環: 強調在得齣結論前必須徹底檢查模型診斷圖,確保推斷的有效性。 穩健性檢查(Robustness Checks): 介紹如何通過改變模型設定(如使用不同樣本子集、更換因果識彆方法)來驗證核心發現的穩定性。 報告的清晰化: 講解如何構建嚴謹的分析報告,包括方法論的透明度、結果的精確度(置信區間、P 值)以及對局限性的坦誠討論。 本書旨在為讀者建立一個全麵的、可移植的“分析操作係統”,確保無論使用何種軟件環境,都能以最嚴謹、最高效的方式處理和解釋復雜的數據集。
作者簡介
目錄資訊
讀後感
評分
評分
評分
評分
評分
用戶評價
评分
Good practice is everything.
评分項目大瞭之後需要一個標準化工序來統一數據整理和分析的流程。這本書很不錯。淺顯易懂。受益頗多!
评分不錯不錯。一個regression monkey 的自我修養
评分不錯不錯。一個regression monkey 的自我修養
评分有收獲!
相關圖書




本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 onlinetoolsland.com All Rights Reserved. 本本书屋 版权所有